English
 Deutsch
 Polski
Prometheus auf dem Raspberry Pi: Wie Labels die Zeitreihen vervielfachen und wie sich der Verursacher findet

Management Summary
Prometheus sammelt Messwerte im Zeitverlauf und macht den Zustand von Rechnern und Diensten sichtbar. Auf einem kleinen Raspberry Pi entscheidet die Detailtiefe mit darüber, ob die Überwachung beherrschbar bleibt oder zu viel Speicher benötigt. Kennzeichnungen teilen Messwerte in getrennte Verläufe auf; viele wechselnde Kennungen können deshalb übermäßig viel Arbeit erzeugen. Sinnvolle Gruppierung an der Quelle begrenzt den Aufwand. Bloßes Entfernen von Kennzeichnungen fasst Messwerte dagegen nicht korrekt zusammen.
Inhalt
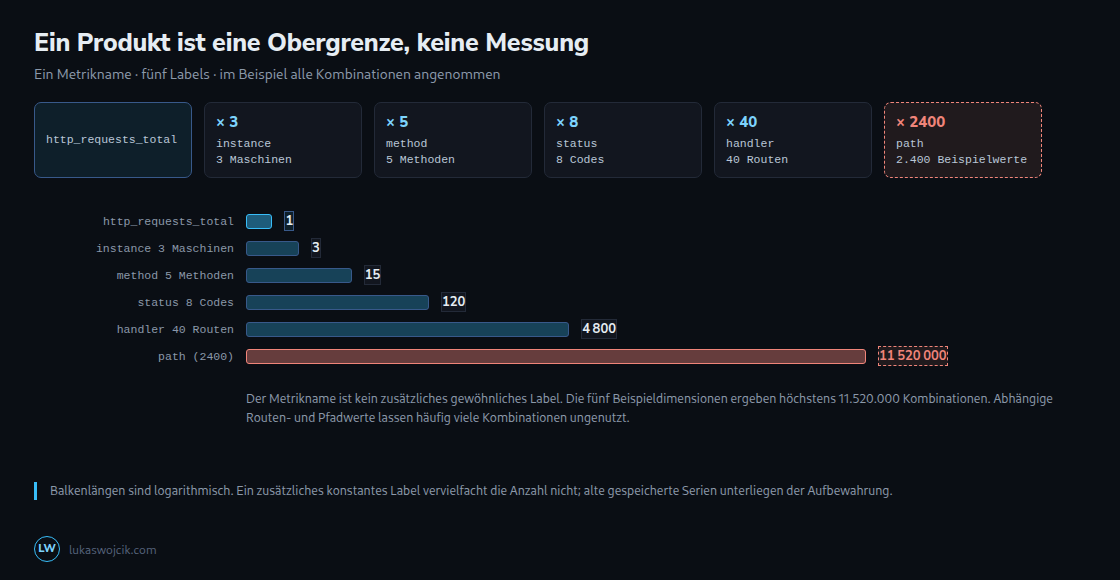
Die Zahl der Exporter allein reicht zur Auslegung eines Raspberry Pi mit Prometheus nicht aus. Entscheidend sind unter anderem die Anzahl der Zeitreihen, die Abtastrate, Abfragen und Aufbewahrung. Eine Zeitreihe wird durch den Metriknamen und die vollständige Kombination der Labelwerte identifiziert.
Die Anzahl unterschiedlicher Kombinationen heißt Kardinalität. Das Produkt der Wertemengen ist eine Obergrenze, keine automatisch erreichte Anzahl: Nicht jede Kombination muss vorkommen. Ein zusätzliches Label mit nur einem festen Wert vervielfacht die Anzahl nicht. Ein Label mit vielen wechselnden Werten kann dagegen erhebliche Kosten verursachen.
Wertemengen und Wechselrate getrennt betrachten
Ein Label braucht eine kontrollierbare Wertemenge und einen Zweck. Bei method und status hängt die tatsächliche Anzahl von der Anwendung und der Instrumentierung ab. HTTP legt weder genau fünf Methoden noch genau zwölf Statuswerte fest. Unbekannte Methoden lassen sich beispielsweise auf einen gemeinsamen Ersatzwert abbilden.
Rohe Pfade wie /wp-admin, /.env oder /product/12345 können zusätzliche Serien erzeugen, wenn die Instrumentierung jeden Pfad als Label übernimmt. Eine erneute Anfrage mit derselben vollständigen Labelkombination erzeugt keine weitere Serie. Die gespeicherten Daten bleiben außerdem nicht unbegrenzt erhalten, sondern unterliegen der Aufbewahrung.
| Label | Typische Herkunft der Werte | Kontrolle der Kardinalität |
|---|---|---|
| job / instance | Ziele und Konfiguration | Inventar und Zielanzahl |
| method / status | Anwendung und Protokoll | Zulässige Werte und Ersatzwert |
| handler / route | Routenvorlagen | Feste Routenmenge; Ersatzwert |
| path (roh) | Anfragepfade | An der Quelle normalisieren |
| user_id / email | Einzelne Personenkennungen | Aus aggregierten Metriken weglassen |
| container_id / pod | Laufende Instanzen | Bestand und Wechselrate beobachten |
Churn bezeichnet die Entstehung und das Verschwinden von Serien, etwa durch wechselnde Pod-Kennungen. Verschwinden zehn alte und entstehen zehn neue Serien, bleibt die Gesamtzahl trotz zwanzig Änderungen gleich. Eine konstante Anzahl gleichzeitig vorhandener Serien kann hohen Churn verdecken. Innerhalb der Aufbewahrungsdauer bleiben alte Serien in den betroffenen Blöcken relevant; bei gleichbleibender Wechselrate und begrenzter Aufbewahrung muss die Gesamtmenge jedoch nicht jede Woche weiter wachsen.
Speicherbedarf ohne starre Faustzahl beurteilen
Viele Serien beanspruchen Arbeitsspeicher, CPU, Datenträger und Netzwerk. Aktuelle Seriendaten und Indizes, das Wiederanlaufprotokoll (Write-Ahead Log, WAL) sowie umfangreiche Abfragen tragen zum Bedarf bei. Ein fester Kilobyte-Wert pro Serie ist keine verlässliche Kapazitätsgarantie: Labelgrößen, Messwerte, Version und Abfragelast unterscheiden sich. Auch auf dem Pi kann zuerst RAM, CPU oder Speicherplatz knapp werden.
Speichermangel kann zu einem Abbruch wegen Speichermangels (Out of Memory, OOM) und einer Neustartschleife führen. Das ist eine mögliche Fehlerfolge, keine Diagnose allein anhand eines ausgefallenen Dashboards. Prozessspeicher, Hostreserve, Neustarts, Protokolle und die zeitliche Entwicklung der Serienzahl gehören gemeinsam geprüft.
Gezielt nach auffälligen Serien suchen
Die folgenden PromQL-Beispiele grenzen die Untersuchung zunächst auf den beispielhaften Job app ein. Ein unbeschränkter Scan über alle Metriken kann gerade einen bereits belasteten Pi zusätzlich beanspruchen. Die zweite Abfrage zählt nur vorhandene, nichtleere path-Werte; ohne passende Serien liefert PromQL hier kein Ergebnis statt einer automatisch ausgegebenen null.
topk(10, count by (__name__)({job="app", __name__=~".+"}))

count(count by (path) (http_requests_total{job="app", path!=""}))

prometheus_tsdb_head_series
delta(prometheus_tsdb_head_series[1h])
Die Head-Metriken setzen voraus, dass Prometheus die eigenen Metriken abfragt; ein leeres Ergebnis kann auch auf eine fehlende Erfassung hinweisen.
Die erste Abfrage zeigt häufige Metriknamen im aktuellen Abfragezustand. Die zweite prüft ein bereits ausgewähltes Label, findet also nicht automatisch das problematische Label. Eine Gauge erfasst einen aktuellen Wert, der steigen oder fallen kann. Die Head-Metrik vom Typ Gauge umfasst die Serien im aktuellen TSDB-Head, dem Bereich für die jüngsten Messwerte, und kann von sofort abfragbaren, noch nicht veralteten Serien abweichen. delta beschreibt die auf eine Stunde extrapolierte Nettoänderung einer Gauge, nicht die Zahl neu angelegter Serien.
Steigende Bestände können durch legitimes Wachstum entstehen; starker Churn kann bei stabilem Bestand auftreten. Als Ergänzung liefert /api/v1/status/tsdb?limit=10 Ranglisten nach Metriknamen und Labelwerten sowie Head-Statistiken. Auch solche Diagnosen haben einen Aufwand. Aussagekräftig sind Vergleiche mit einem bekannten Normalzustand und mit Änderungen an Exportern oder Deployments.
Label entfernen ist keine Aggregation
labeldrop entfernt Labelnamen, addiert aber keine Werte. Beispielsweise werden die beiden Zähler requests_total{path="/a"} 10 und requests_total{path="/b"} 20 nach Entfernung von path gleich bezeichnet. Daraus entsteht nicht zuverlässig der korrekte Gesamtzähler 30. Kollisionen können zur Ablehnung von Messwerten führen. Labelentfernung ist nur geeignet, wenn die verbleibenden Serien weiterhin eindeutig sind.
Eine klar abgegrenzte Sofortmaßnahme ist stattdessen, eine nachweislich entbehrliche, teure Metrik vollständig von der Aufnahme auszuschließen. Das folgende Beispiel verwirft sämtliche http_requests_total-Serien ausschließlich im Job app. Dadurch fehlen diese Messwerte auch für Dashboards und Alarme; der Metrikname ist ein anzupassendes Beispiel.
scrape_configs:
  - job_name: 'app'
    static_configs:
      - targets: ['app:9100']
    metric_relabel_configs:
      - source_labels: [__name__]
        regex: 'http_requests_total'
        action: drop
Die dauerhafte Lösung liegt häufig an der Quelle: Der Exporter zählt direkt je normalisierter Routenvorlage, etwa /product/:id, und verwendet einen festen Wert für unbekannte Routen. Bereits getrennte Zähler nur nachträglich gleich zu beschriften wäre erneut eine Kollision. Eine PromQL-Summe oder Recording Rule kann Auswertungen vereinfachen, verhindert jedoch nicht die vorherige Aufnahme der Rohserien. Vor einer Übernahme prüft promtool check config prometheus.yml die Konfiguration; gültiges YAML bestätigt noch keine fachlich sinnvolle Filterregel.
Neue Labels mit einem Budget versehen
Für jedes Label gehören erwartete Wertezahl, Änderungsrate, mögliche Kombinationen und Nutzen dokumentiert. Eine Konfigurationsdatei garantiert keine kleine Kardinalität; auch eine endliche Menge kann zu groß sein. Hohe Kardinalität bedeutet umgekehrt nicht automatisch Personenbezug: Zufällige Containerkennungen sind ein anderes Problem als E-Mail-Adressen.
Direkte Personenkennungen sind für aggregierte Betriebsmetriken meist unnötig und erhöhen sowohl die Kardinalität als auch die Menge sensibler Informationen. Der Verzicht auf solche Labels reduziert diese Risiken, ersetzt aber keine Prüfung weiterer möglicherweise personenbezogener Messdaten.
Fragen und Antworten
Hilft eine kürzere Aufbewahrung gegen Speichermangel?
Eine kürzere Aufbewahrung begrenzt vor allem ältere Datenblöcke. Der aktuelle Head und aufwendige Abfragen benötigen weiterhin Ressourcen. Prometheus schreibt zunächst typischerweise zweistündige Blöcke; der Head umfasst normalerweise einige Stunden, nicht die gesamte Aufbewahrungsdauer. Kompaktierung, Neustarts und Betriebszustand beeinflussen den genauen Umfang. Nach einer Filteränderung verschwinden alte Serien weder sofort aus dem Head noch rückwirkend aus gespeicherten Blöcken.
Welche Grenzen reduzieren das Ausfallrisiko?
Mehrere Schutzmaßnahmen ergänzen eine kontrollierte Instrumentierung, garantieren jedoch keine Ausfallsicherheit:
sample_limitbegrenzt die akzeptierten Messwerte pro Scrape nach dem Metric Relabeling. Eine Überschreitung lässt den gesamten Scrape scheitern;upwird für das betroffene Ziel null. Der Grenzwert lässt sich aus normalen Werten vonscrape_samples_post_metric_relabelingund einer begründeten Reserve ableiten. Viele wechselnde Serien über mehrere Scrapes werden dadurch nicht als Gesamtbestand begrenzt.- Warnregeln auf Serienzahl und deren Entwicklung helfen zusammen mit Speicher-, Neustart- und Scrape-Fehler-Metriken. Eine Wachstumsregel allein erkennt weder jeden Churn noch jede kurzzeitige Lastspitze.
- Eine wirksame harte Container-Speichergrenze begrenzt den Verbrauch der betreffenden cgroup; ein dortiger OOM-Abbruch kann Prometheus beenden. Globale Speicherknappheit durch andere Prozesse bleibt möglich. Unter Docker gehören tatsächliche Kernel-/cgroup-Unterstützung, wirksame Limits und die Swap-Einstellung geprüft, etwa mit
docker infound der Containerkonfiguration.
Quellen
- Raspberry Pi: Dokumentation
- Prometheus: Datenmodell
- Prometheus: Labeländerung und Abrufgrenzen
- Prometheus: Speicherung und Aufbewahrung
- Prometheus: Einbau der Messwerterfassung
- Prometheus: TSDB-Statistiken
- Prometheus: delta-Funktion
- Prometheus: Veraltete Serien und Abfragekosten
- Docker: Speichergrenzen
- IANA: HTTP-Methoden
Verstehen durch Ausprobieren
Ein Label mehr. Wie viele Zeitreihen mehr?
Ändere die Anzahl der Labelwerte. Schalte dann user_id dazu und beobachte den Multiplikator.
- Mögliche Zeitreihen
- Samples pro Tag
Obergrenze für eine einfache Metrik, wenn alle Kombinationen auftreten. Balken logarithmisch skaliert. Weniger beobachtete Kombinationen ergeben weniger Reihen. Histogramm-Buckets und weitere Metriken fehlen hier; keine RAM-Prognose.
Dieses Modul rechnet im Browser und sendet oder speichert Deine Eingaben nicht.
Verstehen durch Ausprobieren
Eine Minute: Findest Du den Denkfehler?
Eine Metrik hat 200 Kombinationen. Ein neues Label hat 5.000 Werte, die mit jeder bisherigen Kombination auftreten. Was ist die Obergrenze?
Die Kombinationen multiplizieren sich: 200 × 5.000. Tatsächlich existieren nur die beobachteten Kombinationen. Unbegrenzte IDs als Label können diesen Raum laufend vergrößern.
Passend dazu