English
 Deutsch
 Polski
Prometheus na Raspberry Pi: jak etykiety mnożą szeregi czasowe i jak znaleźć winowajcę

Management Summary
Prometheus zbiera pomiary w czasie i pokazuje stan komputerów oraz usług. Na małym Raspberry Pi poziom szczegółowości wpływa na to, czy monitoring działa sprawnie, czy zużywa zbyt dużo pamięci. Etykiety rozdzielają odczyty na osobne historie, dlatego wiele zmieniających się identyfikatorów może powodować nadmierną pracę. Sensowne grupowanie informacji u źródła ogranicza ten koszt i zachowuje użyteczność monitoringu. Samo usunięcie etykiet nie oznacza poprawnego zsumowania pomiarów.
Przejdź do interaktywnego przykładu ↓
Spis treści
Sama liczba eksporterów nie wystarcza do dobrania zasobów Raspberry Pi z Prometheusem. Znaczenie mają między innymi liczba szeregów czasowych, częstotliwość odpytywania, zapytania i okres przechowywania. Każdy szereg identyfikuje nazwa metryki oraz pełna kombinacja wartości etykiet.
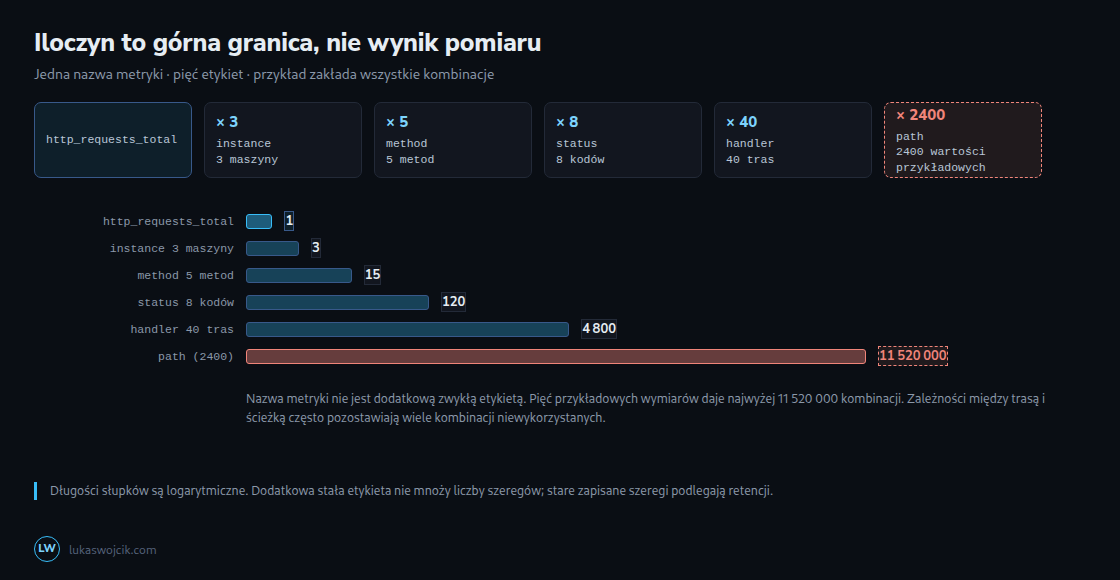
Liczba odrębnych kombinacji to kardynalność. Iloczyn liczebności zbiorów wartości etykiet jest górną granicą, a nie automatycznie osiąganą liczbą: część kombinacji może nigdy nie wystąpić. Dodanie etykiety z jedną stałą wartością nie zwielokrotnia liczby szeregów. Etykieta z wieloma zmiennymi wartościami może jednak powodować znaczne koszty.
Liczba wartości i tempo zmian to osobne kwestie
Etykieta potrzebuje kontrolowanego zbioru wartości i konkretnego celu. Dla method i status rzeczywiste liczby zależą od aplikacji i instrumentacji. HTTP nie określa dokładnie pięciu metod ani dokładnie dwunastu statusów. Nieznane metody mogą na przykład otrzymywać wspólną wartość zastępczą.
Surowe ścieżki, takie jak /wp-admin, /.env lub /product/12345, mogą tworzyć kolejne szeregi, jeśli instrumentacja kopiuje każdą ścieżkę do etykiety. Następne żądanie z identyczną pełną kombinacją etykiet nie tworzy nowego szeregu. Zapisane dane podlegają też retencji zamiast pozostawać na zawsze.
| Etykieta | Typowe źródło wartości | Kontrola kardynalności |
|---|---|---|
| job / instance | Cele i konfiguracja | Inwentarz i liczba celów |
| method / status | Aplikacja i protokół | Dozwolone wartości i wartość zastępcza |
| handler / route | Szablony tras | Stały zbiór tras; wartość zastępcza |
| path (surowa) | Ścieżki żądań | Normalizacja u źródła |
| user_id / email | Identyfikatory poszczególnych osób | Pominięcie w metrykach zagregowanych |
| container_id / pod | Działające instancje | Obserwacja stanu i tempa zmian |
Churn oznacza powstawanie i zanikanie szeregów, na przykład wskutek zmiany identyfikatorów podów. Gdy znika dziesięć starych szeregów i powstaje dziesięć nowych, łączna liczba pozostaje taka sama mimo dwudziestu zmian. Stała liczba szeregów obecnych jednocześnie może ukrywać dużą rotację. Stare szeregi pozostają istotne w odpowiednich blokach przez okres przechowywania; przy stałym tempie zmian i ograniczonej retencji łączna ilość danych nie musi jednak rosnąć z tygodnia na tydzień.
Ocena zasobów bez sztywnego przelicznika na szereg
Wiele szeregów obciąża RAM, CPU, nośnik i sieć. Do zużycia przyczyniają się bieżące dane szeregów i indeksy, przetwarzanie dziennika zapisu wyprzedzającego (WAL) oraz duże zapytania. Stała liczba kilobajtów na szereg nie gwarantuje wystarczających zasobów: różnią się długości etykiet, próbki, wersje i obciążenie zapytaniami. Na Pi pierwszym ograniczeniem może być RAM, CPU albo miejsce na dane.
Zbyt duże zużycie RAM może spowodować zakończenie procesu z powodu braku pamięci (Out of Memory, OOM) i pętlę restartów. To możliwy przebieg awarii, a nie diagnoza wynikająca wyłącznie z niedziałającego panelu. Zużycie pamięci procesu, zapas na hoście, restarty, dzienniki i zmiany liczby szeregów wymagają wspólnej oceny.
Celowane zapytania o nietypową liczbę szeregów
Poniższe przykłady PromQL początkowo ograniczają analizę do przykładowego zadania app. Nieograniczony przegląd wszystkich metryk może dodatkowo obciążyć już przeciążone Pi. Drugie zapytanie liczy wyłącznie obecne, niepuste wartości path; bez pasujących szeregów wyrażenie zwraca brak wyniku, a nie automatycznie wpisane zero.
topk(10, count by (__name__)({job="app", __name__=~".+"}))

count(count by (path) (http_requests_total{job="app", path!=""}))

prometheus_tsdb_head_series
delta(prometheus_tsdb_head_series[1h])
Metryki head wymagają odpytywania własnych metryk przez Prometheusa; pusty wynik może też oznaczać brak zbierania tych danych.
Pierwsze zapytanie wskazuje nazwy metryk z dużą liczbą szeregów w bieżącym stanie zapytania. Drugie sprawdza wcześniej wybraną etykietę, więc nie odkrywa automatycznie problematycznej etykiety. Metryka typu gauge zapisuje bieżącą wartość, która może rosnąć lub maleć. Metryka head tego typu obejmuje szeregi w bieżącym obszarze TSDB head, przechowującym najnowsze pomiary, i może różnić się od szeregów nadal dostępnych w zapytaniu chwilowym. delta opisuje zmianę netto wartości typu gauge ekstrapolowaną na godzinę, a nie liczbę nowo utworzonych szeregów.
Rosnący stan może wynikać z uzasadnionej rozbudowy; duża rotacja może występować przy stałym stanie. Uzupełniająco /api/v1/status/tsdb?limit=10 udostępnia rankingi według nazw metryk i wartości etykiet oraz statystyki head. Taka diagnostyka także ma koszt. Pomocne jest porównanie ze znanym stanem normalnym oraz zmianami eksporterów i wdrożeń.
Usunięcie etykiety nie agreguje wartości
labeldrop usuwa nazwy etykiet, ale nie dodaje wartości. Przykładowo liczniki requests_total{path="/a"} 10 i requests_total{path="/b"} 20 po usunięciu path otrzymują identyczne oznaczenie. Nie powstaje w ten sposób niezawodnie poprawny łączny licznik 30. Kolizje mogą prowadzić do odrzucenia próbek. Usuwanie etykiet jest odpowiednie tylko wtedy, gdy pozostałe szeregi nadal są jednoznacznie identyfikowane.
Wyraźnie ograniczonym działaniem doraźnym jest całkowite pominięcie przy zapisie kosztownej metryki, jeśli zbędność została potwierdzona. Poniższy przykład odrzuca wszystkie szeregi http_requests_total wyłącznie w zadaniu app. Tych próbek zabraknie również na panelach i w alertach; nazwa metryki jest przykładem wymagającym dostosowania.
scrape_configs:
  - job_name: 'app'
    static_configs:
      - targets: ['app:9100']
    metric_relabel_configs:
      - source_labels: [__name__]
        regex: 'http_requests_total'
        action: drop
Trwałe rozwiązanie często znajduje się u źródła: eksporter zlicza bezpośrednio według znormalizowanego szablonu trasy, na przykład /product/:id, ze stałą wartością zastępczą dla nieznanych tras. Samo przemianowanie etykiet istniejących osobnych liczników spowodowałoby kolejną kolizję. Suma PromQL lub reguła zapisująca może uprościć analizę, ale nie zapobiega wcześniejszemu zapisowi surowych szeregów. Przed wdrożeniem promtool check config prometheus.yml sprawdza konfigurację; poprawny YAML nie potwierdza jeszcze zasadności filtra.
Budżet dla nowych etykiet
Dla każdej etykiety potrzebne są udokumentowane oczekiwania dotyczące liczby wartości, tempa zmian, możliwych kombinacji i przydatności. Plik konfiguracyjny nie gwarantuje małej kardynalności; nawet skończony zbiór może być za duży. Z kolei wysoka kardynalność nie oznacza automatycznie danych osobowych: losowe identyfikatory kontenerów to inny problem niż adresy e-mail.
Bezpośrednie identyfikatory osób są zwykle zbędne w zagregowanych metrykach operacyjnych i zwiększają zarówno kardynalność, jak i ilość wrażliwych informacji. Pominięcie takich etykiet ogranicza te ryzyka, lecz nie zastępuje kontroli pozostałych danych pomiarowych pod kątem możliwego związku z osobami.
Pytania i odpowiedzi
Czy krótsza retencja pomaga przy braku pamięci?
Krótsza retencja ogranicza przede wszystkim starsze bloki danych. Bieżący head i kosztowne zapytania nadal wymagają zasobów. Prometheus zapisuje początkowo bloki obejmujące zwykle dwie godziny; head obejmuje zazwyczaj kilka godzin zamiast całego okresu retencji. Dokładny zakres zależy od kompakcji, restartów i warunków pracy. Po zmianie filtra stare szeregi nie znikają natychmiast z head ani wstecznie z zapisanych bloków.
Jakie ograniczenia zmniejszają ryzyko awarii?
Kilka zabezpieczeń uzupełnia kontrolowaną instrumentację, lecz nie gwarantuje nieprzerwanego działania:
sample_limitogranicza przyjmowane próbki w pojedynczym odpytaniu po metric relabeling. Przekroczenie limitu powoduje niepowodzenie całego odpytania;upprzyjmuje zero dla danego celu. Podstawą limitu mogą być normalne wartościscrape_samples_post_metric_relabelingi uzasadniony zapas. Nie ogranicza to łącznego stanu zmieniających się szeregów z wielu odpytań.- Alerty dotyczące liczby szeregów i zmian tej liczby pomagają wraz z metrykami pamięci, restartów i błędów odpytywania. Sam alert wzrostu nie wykrywa każdej rotacji ani każdego krótkiego skoku obciążenia.
- Skuteczny twardy limit pamięci kontenera ogranicza zużycie w danej cgroup; zakończenie przez OOM w tej grupie może zatrzymać Prometheusa. Globalny brak pamięci spowodowany innymi procesami pozostaje możliwy. W Dockerze sprawdzenia wymagają rzeczywista obsługa jądra i cgroup, obowiązujące limity oraz ustawienia swap, na przykład przez
docker infoi konfigurację kontenera.
Źródła
- Raspberry Pi: dokumentacja
- Prometheus: model danych
- Prometheus: zmiana etykiet i limity odpytywania
- Prometheus: przechowywanie i retencja
- Prometheus: wdrożenie pomiarów
- Prometheus: statystyki TSDB
- Prometheus: funkcja delta
- Prometheus: nieaktualne szeregi i koszt zapytań
- Docker: limity pamięci
- IANA: metody HTTP
Zrozum przez eksperyment
Jeszcze jedna etykieta. Ile nowych szeregów?
Zmień liczbę wartości etykiet. Następnie dodaj user_id i zobacz mnożnik.
- Możliwe szeregi czasowe
- Próbki dziennie
Górna granica dla jednej prostej metryki, jeśli wystąpią wszystkie kombinacje. Paski w skali logarytmicznej. Mniej obserwowanych kombinacji daje mniej szeregów. Bez koszyków histogramu i innych metryk; to nie prognoza RAM.
Ten moduł działa w przeglądarce i nie wysyła ani nie zapisuje wpisanych danych.
Zrozum przez eksperyment
Jedna minuta: znajdziesz błąd?
Metryka ma 200 kombinacji. Nowa etykieta ma 5000 wartości występujących z każdą istniejącą kombinacją. Jaka jest górna granica?
Kombinacje się mnożą: 200 × 5000. Istnieją tylko kombinacje faktycznie zaobserwowane. Nieograniczone identyfikatory w etykietach mogą stale powiększać ten zbiór.
Powiązane artykuły