English
 Deutsch
 Polski
Co potrafi Gemini 4 Argon? Zastosowania i ograniczenia

Management Summary
Gemini 4 Argon to model AI przeznaczony do wymagających zadań informacyjnych. Przy pracy z dokumentami i tworzeniu oprogramowania może porównywać materiały, przygotowywać zmiany oraz łączyć treści z różnych mediów. Artykuł wyjaśnia, gdzie takie wsparcie pomaga i dlaczego prostszy model może wystarczyć do codziennych zadań. Głębsze przetwarzanie może zwiększać czas i koszt, a wyniki nadal wymagają sprawdzenia. Znaczenie ma rzeczywiście oszczędzona praca.
Gemini 4 Argon to model Google przeznaczony do zadań wymagających czegoś więcej niż krótkiej odpowiedzi: analizy obszernych dokumentów, wieloetapowych zmian w oprogramowaniu oraz łączenia informacji z tekstu, obrazów, dźwięku i wideo. Karta modelu wymienia także problemy matematyczne i naukowe. Żadna z tych możliwości nie gwarantuje poprawnego wyniku. Praktyczna wartość zależy od zadania, dostępnych narzędzi i możliwości sprawdzenia odpowiedzi. [1][3]
Artykuł przedstawia stan dokumentacji z 26 października 2026 r. Nie opiera się na własnych testach porównawczych ani na deklarowanych wdrożeniach klientów.
Gdzie dostępny jest Gemini 4 Argon
Według Google od 13 października Argon jest dostępny w aplikacji Gemini dla abonamentów Google AI Pro i Ultra. Dostęp programistyczny zapewniają Google AI Studio oraz Gemini API pod identyfikatorem gemini-4-argon. Karta modelu wymienia także ofertę dla firm, Antigravity i tryb AI w wyszukiwarce. Dostępność, limity użycia i funkcje interfejsu zależą od wybranego kanału. [1][2][4]
Aplikacja lub AI Studio nadaje się do pojedynczej próby, na przykład porównania dwóch raportów. API to interfejs programistyczny: inny program wysyła dane do Argona i otrzymuje wynik. Przydaje się to, gdy codziennie nowe raporty wymagają takich samych kontroli, a wyniki mają być zapisywane automatycznie. Wybór dotyczy sposobu pracy, a nie wyższej jakości odpowiedzi w jednym z interfejsów.
Cztery praktyczne obszary zastosowań
Tworzenie oprogramowania: Argon może przygotować propozycje zmian w kilku plikach. Przydatny opis zadania zawiera dany kod, wersje programów, oczekiwane działanie i istniejące testy. Przykładowy cel naprawy: puste dane wejściowe nie mogą powodować awarii. Dopiero wykonane testy i przegląd zmian pokazują, czy propozycja działa. Google wskazuje złożone prace programistyczne jako zastosowanie modelu. [1] [3]
Dokumenty i badania: Kilka raportów, umów lub specyfikacji technicznych można zestawić ze sobą. Tabela twierdzeń, miejsc w źródłach i sprzeczności bywa przydatniejsza od gładkiego streszczenia. API przyjmuje pliki PDF. Odwołania w wygenerowanej odpowiedzi nadal wymagają kontroli w oryginale; płynny opis nie stanowi dowodu poprawnego cytowania. [1][3]
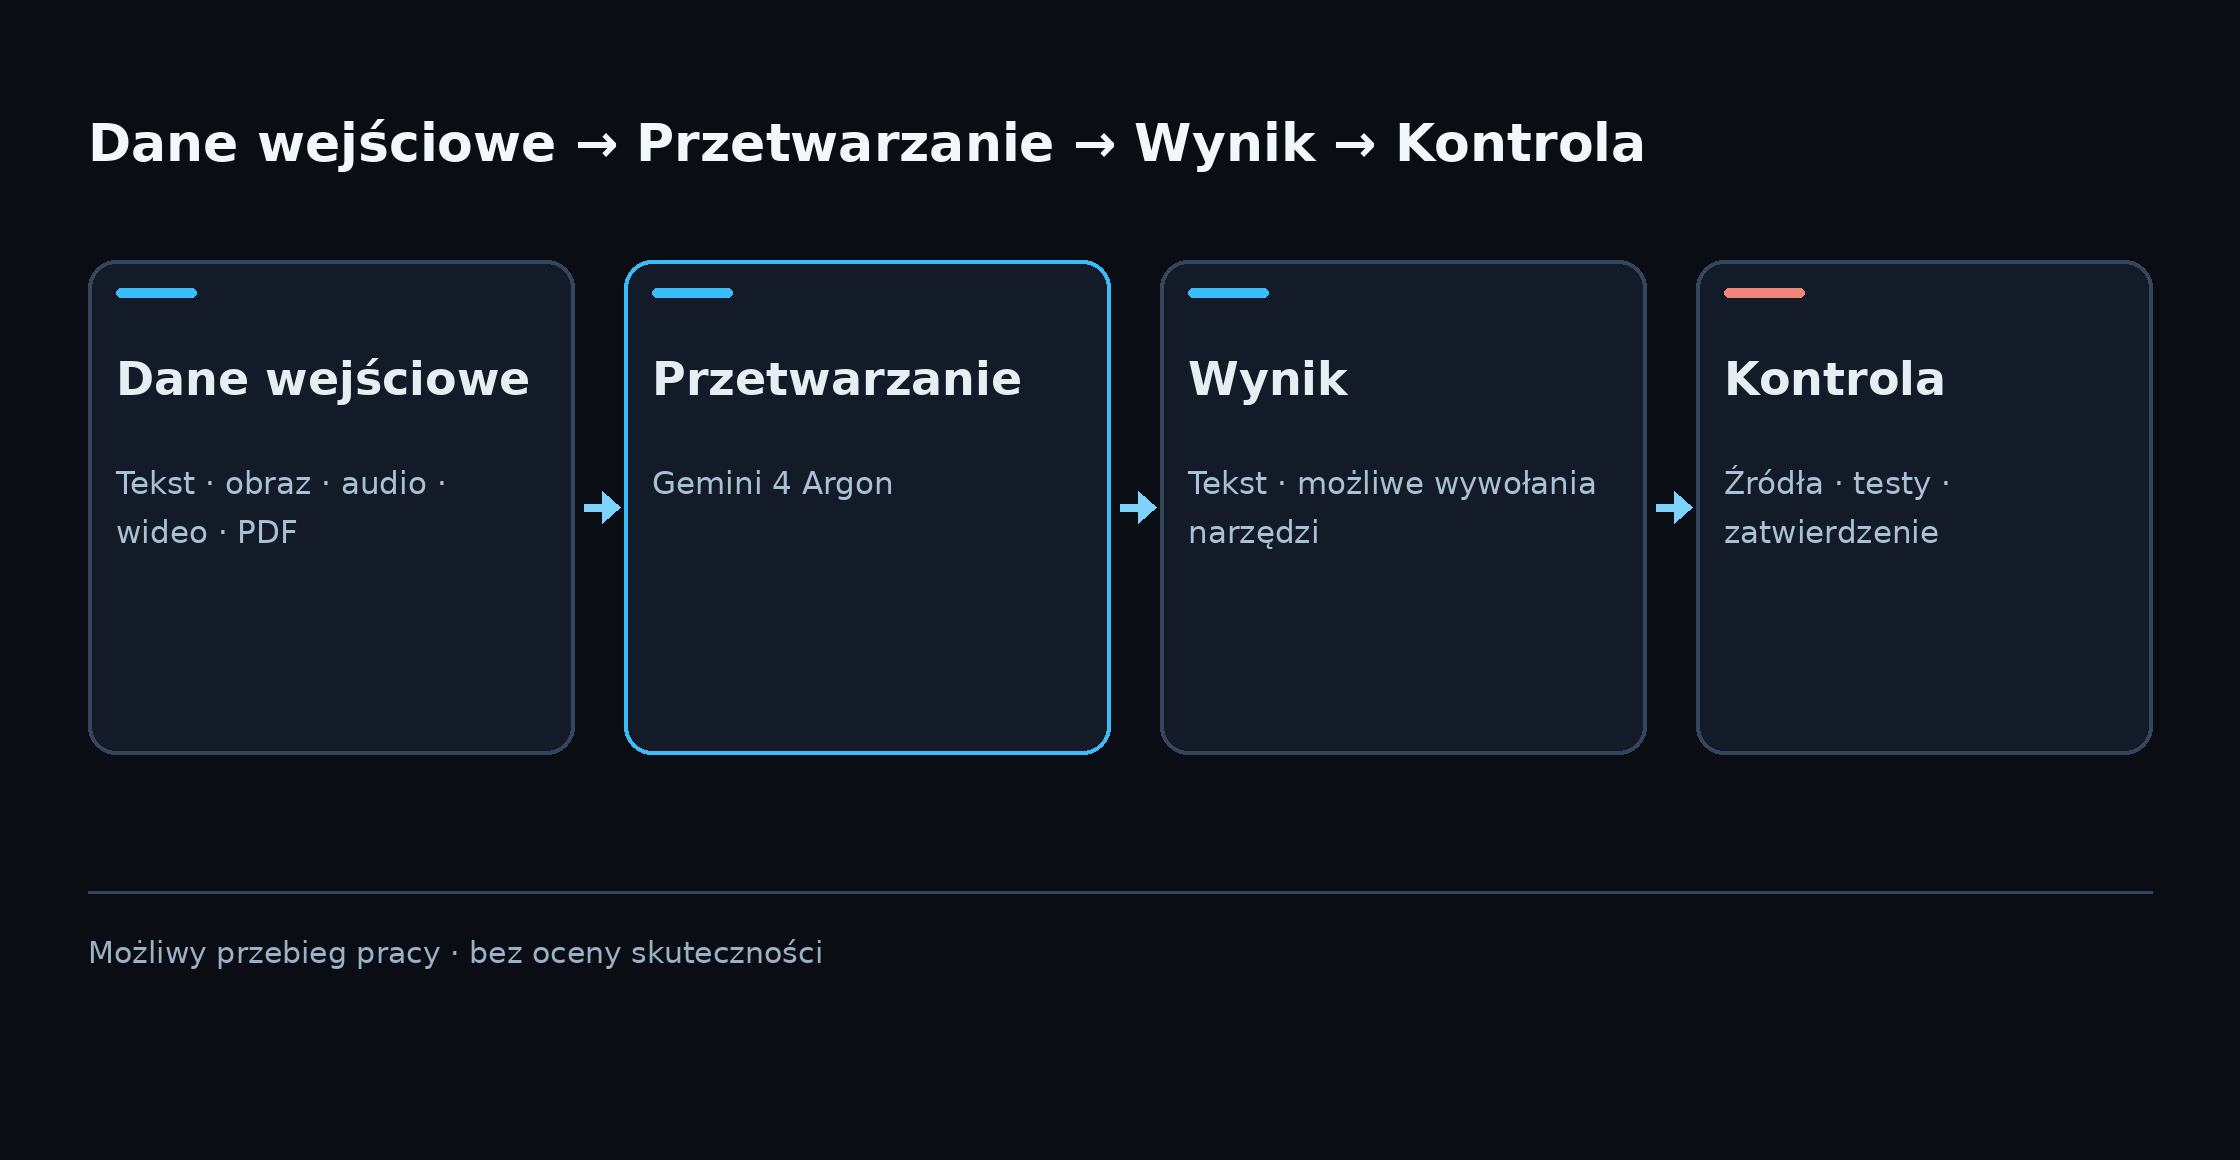
Łączna analiza tekstu, obrazów, dźwięku i wideo: Strona modelu dopuszcza także pliki PDF. Przykładowe zadanie łączy nagranie ekranu z błędnym działaniem i pisemny opis oczekiwanego wyniku. Argon zwraca tekst. Według aktualnej strony API sam model nie generuje obrazów ani plików dźwiękowych i nie obsługuje sesji Live API. [1]
Łączenie kilku kroków: Argon może proponować wywołania narzędzi i zwracać wynik w ustalonym formacie, na przykład z polami „miejsce w źródle”, „kwota” i „sprzeczność”. Obsługiwane narzędzia mogą wyszukiwać, czytać strony lub wykonywać kod. Otaczająca aplikacja określa, które wywołania zostaną rzeczywiście wykonane, zgodnie z ustawieniami i uprawnieniami. Zaproponowane działanie nie jest więc jeszcze wykonanym działaniem. [1]
Ile mieści się w jednym zapytaniu
Tokeny to jednostki, na które model dzieli tekst i inne dane wejściowe; jeden token nie musi oznaczać jednego słowa. Google podaje wspólną granicę 1 048 576 tokenów dla wejścia, wewnętrznego rozumowania i odpowiedzi. Zwykłe zapytania mają domyślny limit wyjścia 65 536 tokenów, który obejmuje również rozumowanie. Widoczna odpowiedź może być więc krótsza. Większe wyniki wymagają opisanego procesu w tle „long decode”; wspólna granica nadal obowiązuje. [1] [2]
Duży kontekst pozwala przekazać wiele dokumentów razem. Nie gwarantuje pełnej analizy. Pomagają konkretne pytania, na przykład: jakie terminy dostawy podają raporty A i B oraz na których stronach? Odpowiedź da się wtedy sprawdzić bezpośrednio w obu wskazanych miejscach.
Ograniczenia, czas i koszt
Karta modelu wymienia zmyślone lub błędne informacje, często nazywane halucynacjami. Możliwe są również powolne odpowiedzi i przerwanie po przekroczeniu czasu. Podana granica wiedzy to marzec 2026 r.; w niektórych dziedzinach informacje mogą być starsze. Pytanie o późniejsze wydarzenie wymaga więc nowych źródeł i sprawdzenia przywołanych dowodów. [3]
Google podaje ceny wprowadzające API do 30 listopada 2026 r.: 2 USD za milion tokenów wejściowych i 10 USD za milion wyjściowych. Od 1 grudnia zapowiedziano odpowiednio 4 i 20 USD. Wewnętrzne tokeny rozumowania również są rozliczane jako wyjście. Według cen wprowadzających 100 000 tokenów wejściowych i 10 000 rozliczanych wyjściowych kosztuje łącznie 0,30 USD, bez innych opłat. Powtarzane początki zapytań mogą kosztować mniej dzięki automatycznemu buforowaniu niejawnemu. Argon nie obsługuje jawnie utworzonego bufora. Nie ma bezpłatnej warstwy API; abonamenty aplikacji mają osobne ceny. [2]
Głębsze rozumowanie i długi kontekst mogą zwiększyć czas przetwarzania oraz koszt. API oferuje poziomy low, medium i high; domyślny jest medium. W częstych zadaniach rutynowych warto porównać tę samą próbkę pracy przy różnych ustawieniach oraz z mniejszym modelem. O wyborze powinny decydować błędy, czas i pełny koszt konkretnego procesu, nie ogólne miejsce w rankingu. [2]
Powtarzalny test na początek
Krótka ocena na zatwierdzonych danych przykładowych daje więcej informacji niż materiał promocyjny. Trzy zadania sprawdzają różne mocne strony: znany błąd programu z wykonywalnymi testami, dwa dokumenty z celową sprzecznością oraz wykres z pytaniami o osie i skalę. Oczekiwane fakty, dopuszczalne źródła, czas i koszt powinny zostać ustalone przed próbą.
Przy kodzie dowodami są zaliczone testy i czytelne porównanie zmienionych wierszy, czyli diff. Przy dokumentach liczą się poprawne numery stron i wykryte sprzeczności. Przy wykresie stwierdzenie „podwojenie” musi odpowiadać widocznym wartościom i skali osi. Ponowna kontrola danych wejściowych jest szczególnie ważna, gdy błąd może mieć skutki zawodowe lub finansowe.
Gemini 4 Argon najbardziej odpowiada więc wymagającej analizie i projektom odpowiedzi z możliwym do sprawdzenia wynikiem. Przy krótkich rutynowych pytaniach podobny nakład może być zbędny. O wartości decydują zadanie i sposób kontroli.
Pytania i odpowiedzi
Czy Gemini 4 Argon generuje obrazy?
Aktualna strona modelu w API wymienia obrazy jako dane wejściowe, lecz nie przypisuje temu modelowi generowania obrazów. Argon zwraca tekst. Inne modele Gemini lub funkcje produktów mogą mieć odmienny zakres.
Czy kontekst miliona tokenów oznacza zwykłą długość odpowiedzi?
Nie. Wejście, wewnętrzne rozumowanie i odpowiedź dzielą limit 1 048 576 tokenów. Zwykły limit wyjścia 65 536 tokenów również obejmuje rozumowanie. Widoczna odpowiedź nie ma więc automatycznie takiej długości. Większe wyniki wymagają osobnego procesu w tle i nadal mieszczą się we wspólnej granicy.
Czy odpowiedzi modelu wystarczą do oceny aktualnych faktów i ważnych decyzji?
Aktualne fakty wymagają nowych, sprawdzonych źródeł. Karta modelu podaje marzec 2026 r. jako granicę wiedzy i wskazuje możliwość halucynacji. Ważne decyzje wymagają kontroli dowodów i wyniku.
Źródła
- Google AI for Developers: opis modelu Gemini 4 Argon
- Google AI for Developers: nowości, API, ceny i migracja
- Google DeepMind: karta modelu Gemini 4 Argon
- Google Blog: dostępność w aplikacji Gemini, 13 października 2026 r.
Stan źródeł: 26 października 2026 r. Informacje o produkcie i cenach pochodzą od Google. Artykuł nie przypisuje sobie własnych pomiarów wydajności ani jakości.
Powiązane artykuły