English
 Deutsch
 Polski
Intel Arc dla lokalnych modeli LLM: B580, Pro B50, B60, B65 i B70 w porównaniu z NVIDIA

Management Summary
Karty graficzne Intel Arc mogą wspierać modele językowe, czyli systemy AI do tekstów i odpowiedzi, na własnym komputerze. Artykuł przedstawia te karty jako możliwą alternatywę dla NVIDIA. Przydatność zależy nie tylko od pamięci i ceny: wybrany program musi działać z konkretną kartą oraz systemem. Taka ocena pomaga uniknąć zakupu na podstawie jednego korzystnego parametru. Dopiero praktyczna próba pokazuje, czy karta dobrze wykonuje planowaną pracę.
Spis treści
Intel Arc może uruchamiać duże modele językowe na lokalnym komputerze. Duża pojemność pamięci graficznej to tylko jeden warunek: program musi obsługiwać konkretną kartę razem z systemem i sterownikiem. Niska cena za gigabajt nie potwierdza tej zgodności.
Porównanie sprawdza dane producenta i udokumentowaną obsługę programową. Nie ma własnych pomiarów szybkości, poboru prądu ani jakości odpowiedzi względem NVIDIA. Na tej podstawie nie da się wskazać zwycięzcy wydajności.
Pięć kart, cztery pojemności pamięci
| Karta Intel | Oficjalna pamięć | Główna kontrola |
|---|---|---|
| Arc B580 | 12 GB | Sprawdzenie sterownika i startu modelu |
| Arc Pro B50 | 16 GB | Sprawdzenie wymiarów i złączy konkretnej karty |
| Arc Pro B60 | 24 GB | Pamięć przy planowanej długości wejścia |
| Arc Pro B65 | 32 GB | Karta partnera i wersja programu |
| Arc Pro B70 | 32 GB | Pomiar szybkości na tym samym zadaniu |
B65 i B70 mają po 32 GB, ale różnią się jednostkami obliczeniowymi: Intel podaje 20 rdzeni Xe dla B65 i 32 dla B70. Nie wynika z tego stała proporcja szybkości modeli językowych. Wybór wymaga dwóch osobnych odpowiedzi: czy zadanie mieści się w pamięci i jak szybko działa konkretny program?
Programy korzystające z karty
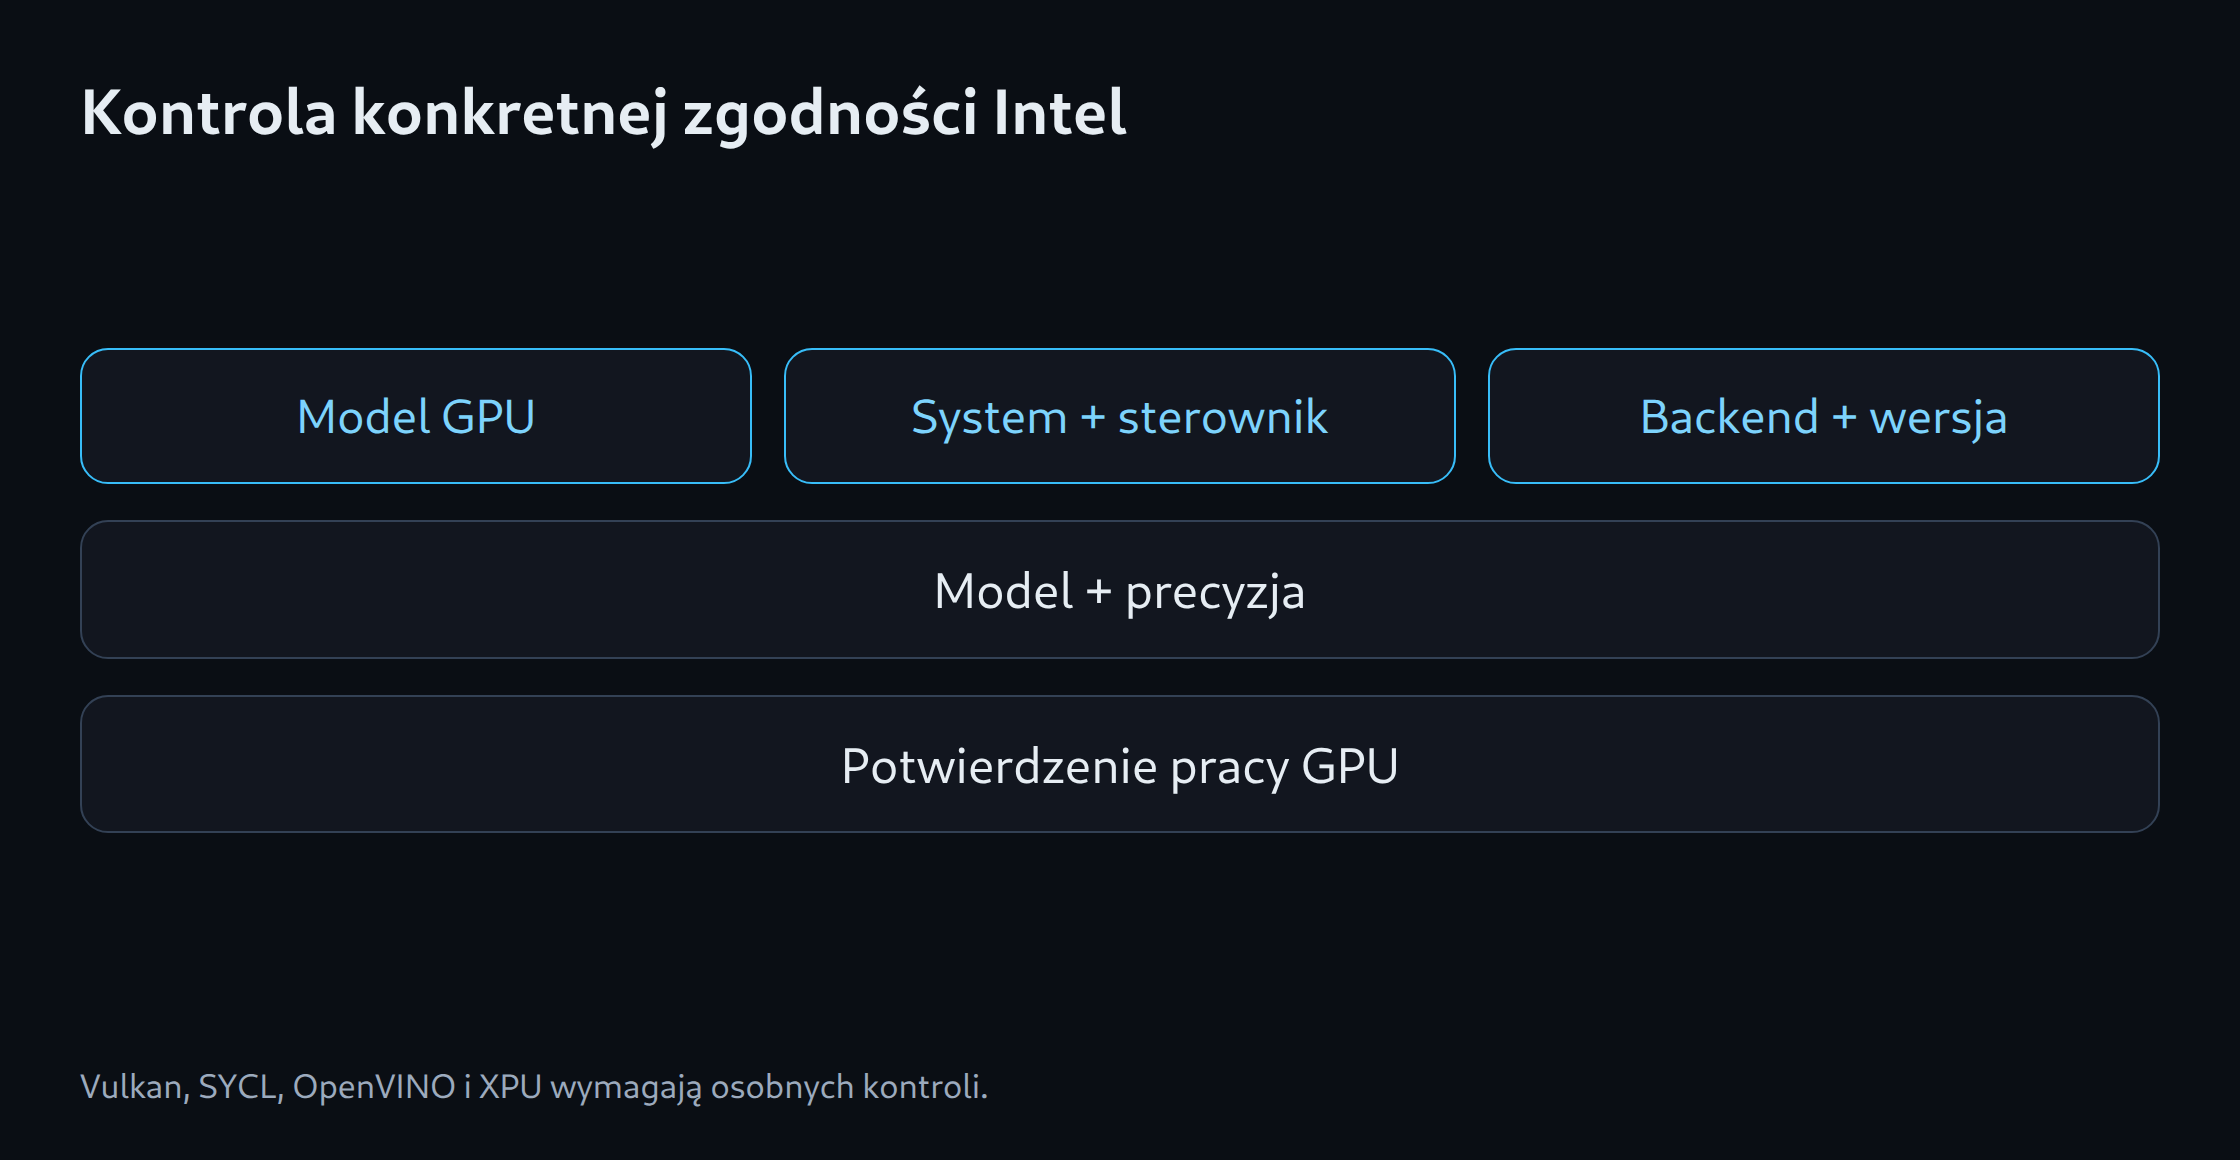
Backend to część programu przekazująca obliczenia do sprzętu. llama.cpp oferuje między innymi Vulkan i SYCL; dokumentacja SYCL wymienia B580 wśród sprawdzonych urządzeń. Ollama opisuje Vulkan w Windows i Linux. OpenVINO GenAI zapewnia osobny sposób uruchamiania modeli, a vLLM oferuje ścieżkę Intel XPU. Żadna z tych informacji nie potwierdza automatycznie wszystkich pięciu kart z każdym modelem.
Powtarzalny test wymaga zapisania karty, sterownika, systemu, wersji programu i dokładnego pliku modelu. Ważny jest też format liczbowy wartości modelu. Kwantyzacja zapisuje te wartości z mniejszą dokładnością, często oszczędza pamięć i może zmieniać odpowiedzi. Niektóre programy potrzebują przekonwertowanego pliku modelu. Udana instalacja jest więc dopiero początkiem.
Sterowniki i dostęp do urządzenia
Windows i Linux mogą wymagać różnych pakietów, sterowników i uprawnień. Interfejs aplikacji komputerowej może ułatwiać obsługę, ale nie potwierdza obsługi karty. W przypadku kontenerów GPU musi być także dostępny wewnątrz kontenera. Instrukcje CUDA zwykle opisują drogę NVIDIA i nie dają się przenieść bez zmian na Intela.
Dziennik startu powinien wskazywać wybrane urządzenie i części modelu załadowane do GPU. Zajęta pamięć graficzna i aktywność GPU dostarczają kolejnych wskazówek, lecz osobno nie dowodzą wykonania całości na GPU. Niektóre programy wykonują część modelu na CPU, czyli głównym procesorze. Może to być zamierzone albo wyjaśniać nieoczekiwanie wolne działanie. Małe zadanie ze znanym wynikiem pomaga znaleźć oczywiste błędy, ale nie zastępuje pełnej oceny jakości.
Uczciwe porównanie z NVIDIA
Arc Pro B60 z 24 GB można porównać z kartą NVIDIA 24 GB pod względem pamięci. Przy zakupie liczą się też aktualne oferty, zasilacz, obudowa, chłodzenie i czas konfiguracji. Artykuł nie podaje sprawdzonych cen rynkowych. Taka sama pamięć nie oznacza takiej samej szybkości ani obsługi programowej.
Przydatny test szybkości używa tych samych zadań i wersji modelu. Zapisuje długość wejścia, maksymalną długość wyjścia, liczbę równoległych żądań i kwantyzację. Czas do pierwszego fragmentu odpowiedzi mierzy się osobno od dalszego generowania. Tokeny to fragmenty tekstu; liczba tokenów na sekundę ma sens tylko przy porównywalnych zadaniach i sposobie liczenia. Wynik powinien uwzględniać także błędy i jakość odpowiedzi.
Kiedy Intel pasuje do zadania
Intel jest możliwością, gdy udokumentowany test potwierdza wymagane zadanie na konkretnej karcie, a łączny koszt odpowiada budżetowi. Dodatkowy czas na kompilację, czyli tworzenie programu wykonywalnego z kodu źródłowego, lub konwersję modelu może przeważyć nad niższą ceną zakupu. Bez takiego testu zestaw pozostaje niezweryfikowany.
Kalkulator pamięci daje oszacowanie, a nie dowód działania. Długie wejścia, zapamiętane wyniki obliczeń i równoległe żądania potrzebują pamięci poza wartościami modelu. Plik modelu może więc być mniejszy od pamięci graficznej, a mimo to nie zmieścić się w całości przy uruchomieniu. Wystarczający VRAM, czyli pamięć karty graficznej, także nie gwarantuje zgodnego oprogramowania.
Planowanie pamięci przy wyborze modelu: kalkulator VRAM dla LLM.
Powiązane narzędzia
Pytania i odpowiedzi
Czy programy CUDA działają bez zmian na Intel Arc?
CUDA nie jest natywnym backendem Intel Arc. Konkretne oprogramowanie wymaga obsługiwanej ścieżki, takiej jak Vulkan, SYCL, OpenVINO lub XPU.
Czy ogólna deklaracja obsługi GPU Intela wystarcza do decyzji zakupowej?
Ogólna deklaracja nie obejmuje każdej karty, architektury modelu ani kwantyzacji. Znaczenie mają konkretny GPU, sterownik, system i wersja środowiska. Udokumentowana konfiguracja testowa zapewnia lepszy dowód niż ogólne oznaczenie zgodności.
Źródła
- Intel: Arc B580 12 GB / B570 10 GB
- Intel: Arc Pro B50 16 GB
- Intel: Arc Pro B60 i B50
- Intel: premiera Arc Pro B65 / B70
- Intel: Arc Pro B70 – specyfikacja, 32 GB
- Ollama: Hardware support
- llama.cpp: projekt i backendy
- vLLM: GPU installation
- OpenVINO: Generative AI workflow
- Intel: Arc Pro B65 32 GB – specyfikacja
- Intel: Arc Pro B60 24 GB
Źródła sprawdzone: 25 października 2026.
llama.cpp: SYCL (25.10.2026).
Powiązane artykuły