English
 Deutsch
 Polski
Hashowanie w Conversions API: normalizacja danych klienta przed SHA-256 i które pola pozostają niezahashowane

Management Summary
Meta wykorzystuje dane klientów do powiązania zgłoszonych zakupów z kontami przy pomiarze reklam. Haszowanie zastępuje wybrane informacje, na przykład dane kontaktowe, obliczonymi odciskami przed wysłaniem. Jednolite przygotowanie jest istotne: różny zapis tej samej informacji może tworzyć różne odciski i uniemożliwić dopasowanie. Dlatego poszczególne rodzaje danych mają własne zasady. Proces zmienia postać danych osobowych, ale nie zapewnia automatycznej anonimowości.
Spis treści
SHA-256 oblicza z danych wejściowych wartość o stałej długości, nazywaną skrótem lub haszem. Poprawna odpowiedź Conversions API nie potwierdza prawidłowego dopasowania adresu e-mail. Wiarygodnie wyglądający skrót SHA-256 może powstać z niewłaściwie przygotowanych danych. Inne identyfikatory nadal mogą wspierać dopasowanie. Przyjęcie zdarzenia, jakość danych i rzeczywiste dopasowanie wymagają zatem osobnych kontroli.
Normalizacja oznacza tutaj przygotowanie wartości do postaci wymaganej dla konkretnego pola przed haszowaniem. Dla adresu e-mail kolejność obejmuje usunięcie białych znaków z początku i końca, zamianę liter na małe, a następnie obliczenie SHA-256. Zmiana gotowego skrótu nie naprawia błędu wejścia.
Dlaczego dokładna postać wejścia ma znaczenie
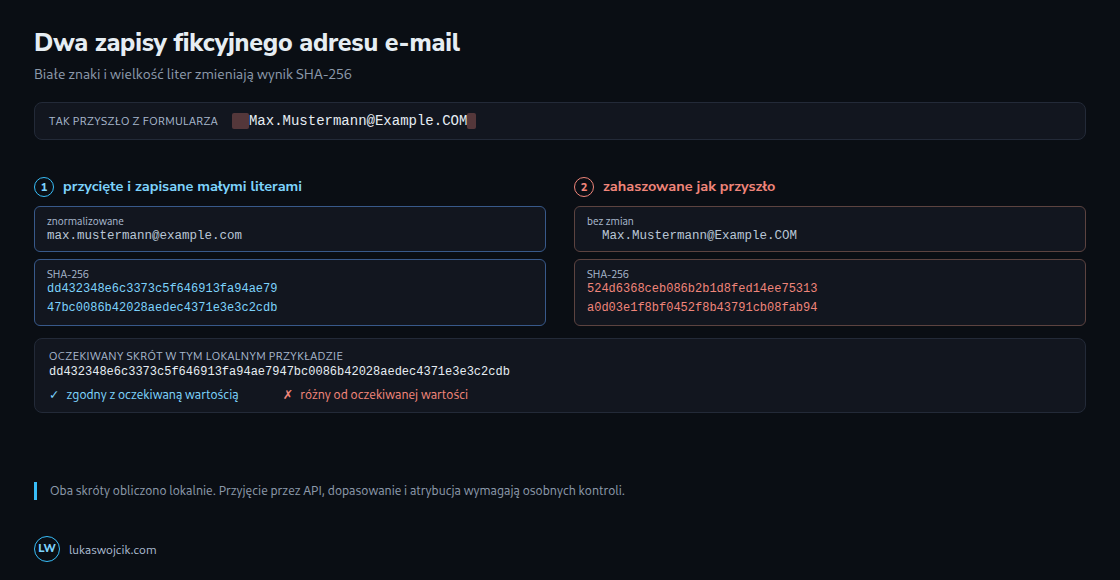
SHA-256 przetwarza bajty. Spacje i wielkość liter zmieniają wynik. W przykładzie trzy zapisy tego samego fikcyjnego adresu dają trzy różne skróty. Porównanie z oczekiwanym skrótem wymaga znormalizowanego zapisu. Nie oznacza to, że Meta w ogóle nie porównuje innych wartości ani że całe zdarzenie musi pozostać bez dopasowania.
Reguły pól zamiast jednej funkcji do wszystkiego
Poniższa tabela ułatwia przygotowanie integracji. Rozstrzygające pozostają aktualna specyfikacja pól Meta i używana wersja SDK. SDK to biblioteka programistyczna ułatwiająca korzystanie z API. Może już normalizować i haszować dane, dlatego wcześniejsze przekształcenia muszą być zgodne z tym działaniem.
| Pole | Przygotowanie i kontrola |
|---|---|
em | Usunięcie zewnętrznych białych znaków i małe litery; bez wymyślonych poprawek samego adresu. |
ph | Numer międzynarodowy z kodem kraju, do haszowania zapisany samymi cyframi. Prefiksy zależne od kraju wymagają wcześniejszej interpretacji. |
fn, ln | Małe litery i kontrola zewnętrznych białych znaków. Sprawdzone funkcje Python/Node.js nie usuwają tutaj automatycznie wszystkich wewnętrznych spacji i znaków interpunkcyjnych. |
ct | Nazwa miejscowości małymi literami, bez spacji i interpunkcji według specyfikacji pola; działanie SDK wymaga testów na przykładach. |
country, st | Kraj jako dwuliterowy kod ISO, np. pl. Region wymaga osobnej obsługi: skrót stanu USA nie jest światową regułą zapisu regionów. |
ge, db | Jeżeli dane są dostępne i przetwarzanie dozwolone: f/m albo poprawna data w formacie YYYYMMDD. Brakujących wartości nie należy zgadywać. |
Numery telefonów można przetwarzać automatycznie z uwzględnieniem kraju i aktualnej biblioteki, takiej jak libphonenumber. Samo usunięcie znaków innych niż cyfry nie wystarcza: w niemieckim przykładzie +49 (0)170 1234567 pozostałoby zbędne zero. Usuwanie zera po każdym kodzie kraju również jest błędem; początkowe zero może należeć do włoskiego numeru międzynarodowego. Niejednoznaczne dane wymagają wyjaśnienia. Kontrola formatu nie potwierdza aktualnej dostępności numeru.
Wartości przekazywane bez haszowania
client_ip_address, client_user_agent, fbp i fbc są przekazywane bez haszowania, zgodnie ze specyfikacją pól. Nie oznacza to braku znaczenia dla prywatności ani braku związku z danymi osobowymi. Adres IP musi odpowiadać zdarzeniu; adres proxy nie zastępuje adresu przeglądarki. Identyfikatorów plików cookie i kliknięć nie wolno dowolnie wymyślać.
To ważne przykłady, a nie pełna lista pól API. Jawne mapowanie określa walidację, normalizację, haszowanie albo przekazanie bez zmian. Nowe pola wymagają osobnej decyzji zamiast objęcia całego obiektu jedną pętlą haszującą.
Powtarzalny test bez prawdziwych danych klientów
Przykład w Pythonie oblicza pełne skróty fikcyjnego adresu. Pierwsze dwa wyniki zaczynają się od 524d6368 i de4c5edc; wersja znormalizowana zaczyna się od dd432348.
import hashlib

samples = [
    "  Max.Mustermann@Example.COM ",
    "  max.mustermann@example.com ",
    "max.mustermann@example.com",
]
for value in samples:
    print(repr(value), hashlib.sha256(value.encode("utf-8")).hexdigest())

expected = "dd432348e6c3373c5f646913fa94ae7947bc0086b42028aedec4371e3e3c2cdb"
normalised = samples[0].strip().lower()
assert hashlib.sha256(normalised.encode("utf-8")).hexdigest() == expected
Test potwierdza lokalne obliczenie, a nie dopasowanie przez Meta. W teście integracji ta sama wartość powinna przejść przez wszystkie etapy przetwarzania aż do danych ostatecznie wysyłanych do Meta. Potrzebne są również przypadki puste, międzynarodowe numery telefonów, kody pocztowe i wejścia już zahaszowane. Niezabezpieczone dzienniki nie są miejscem na surowe dane klientów ani prawdziwe identyfikatory.
Błędy i ostrzeżenia API nadal mają znaczenie. Niewłaściwy skrót może pozostać niezauważony, ale SDK może odrzucić niepoprawne wejście jeszcze przed wysłaniem. Event Match Quality jest wskaźnikiem diagnostycznym, a nie dowodem przypisania konkretnego zdarzenia do konkretnej osoby. Pojedynczy błąd haszowania nie pozwala przewidzieć określonej zmiany wskaźnika ani liczby zdarzeń.
Przeglądarka czy serwer: decyduje przepływ danych
Normalizacja i haszowanie mogą działać w przeglądarce lub na serwerze. Meta udostępnia także kliencki parameter builder. Haszowanie w przeglądarce nie wymusza wysłania surowego adresu: decydują rzeczywiste żądania i pozostałe skrypty. Backend również może otrzymywać surowe dane, co wiąże się z obowiązkami ochrony.
Integracja potrzebuje jasno wskazanego etapu odpowiedzialnego za przetwarzanie, udokumentowanego stanu wejścia i kontroli wychodzących danych. Tajny token dostępu CAPI nie może trafić do publicznie udostępnianego kodu przeglądarki. Haszowanie nie zastępuje szyfrowania transmisji ani zgodności przetwarzania z prawem.
Pytania i odpowiedzi
Czy zahaszowane dane klientów są automatycznie anonimowe?
Nie. W opisanym dopasowaniu powiązanie z osobą pozostaje zamierzone i możliwe dzięki dodatkowym danym. Taki skrót nie zapewnia automatycznej anonimizacji. Podstawa prawna, przejrzystość i ewentualna wymagana zgoda wymagają niezależnego ustalenia.
Jak zapobiegać podwójnemu haszowaniu?
Haszowanie skrótu daje wynik inny niż oczekiwany pojedynczy skrót. Interfejs między etapami musi więc jasno określać, czy przekazywana jest wartość surowa, czy już znormalizowany SHA-256. Wzorzec 64 znaków szesnastkowych nie potwierdza pochodzenia ani poprawnej normalizacji. Własny identyfikator może przypadkowo mieć ten sam format. Reguły rozpoznawania w SDK wymagają kontroli i nie stanowią dowodu pochodzenia.
Jak traktować kody pocztowe i external_id?
zp wymaga przygotowania odpowiedniego dla kraju. Dokumentacja Python SDK wskazuje pięć cyfr dla USA, a dla pozostałych krajów standardy krajowe. Jednocześnie sprawdzona funkcja normalizująca dzieli tekst przy pierwszym łączniku: 00-950 zmieniłoby się w 00. To efekt działania SDK, a nie ogólna reguła dla polskich kodów pocztowych. Integracja wymaga jawnego przypadku testowego sprawdzonego z aktualną specyfikacją pola.
external_id to własny identyfikator. Sprawdzona ścieżka Python UserData przekazuje tę listę bez dodatkowego haszowania; inne funkcje mogą działać inaczej. Rozstrzygający pozostaje aktualny schemat. Udokumentowane zasady muszą określać etap haszowania oraz to, czy wejście jest surowe, czy już zahaszowane. Pixel i CAPI wymagają identycznej końcowej postaci. Automatyczne traktowanie tego pola jak adresu e-mail jest niewłaściwe.
Źródła
- Meta Conversions API
- Meta Python Business SDK: normalizacja i haszowanie
- Meta Python Business SDK: pola danych użytkownika
- Meta Node.js Business SDK: normalizacja pól
- Meta: przygotowanie parametrów w przeglądarce
- Google: libphonenumber
- Google libphonenumber: pytania o odczyt i walidację
- EROD: pytania o ochronę danych
Powiązane artykuły