English
 Deutsch
 Polski
Porównywanie dwóch eksportów kontenera GTM: normalizacja przed diffem i czego nie pokazuje porównanie wierszami

Management Summary
Eksport Google Tag Managera zapisuje ustawienia pomiaru witryny w pliku. Porównanie dwóch eksportów pokazuje zmiany między wersjami, co pomaga przed publikacją albo przy wyjaśnianiu nietypowych raportów. Jednolite formatowanie ułatwia dostrzeżenie rzeczywistych różnic, natomiast usuwanie pól lub przestawianie ważnych list może je ukryć. Porównanie opisuje zmienione ustawienia, a nie automatycznie ich wpływ na stronę. Historia wersji i zaobserwowane działanie dostarczają szerszego kontekstu.
Spis treści
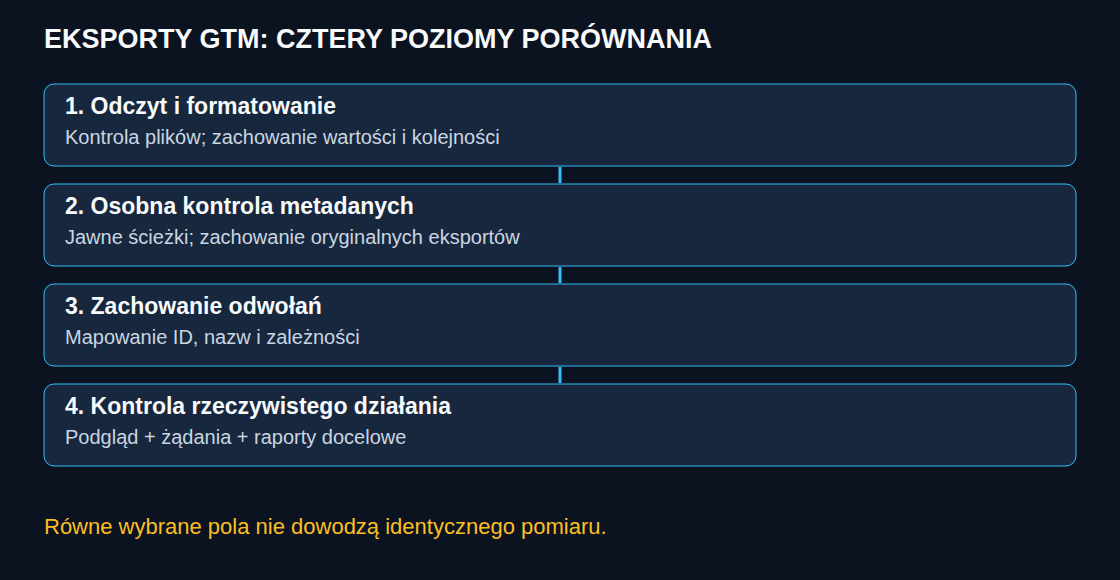
Diff to zestawienie różnic między dwoma plikami. Normalizacja oznacza tu jednakowe formatowanie obu eksportów, aby różnice układu nie przesłaniały zmian ustawień. Porównanie eksportów GTM odpowiada na różne pytania: czy różnią się pliki, odczytane konfiguracje lub rzeczywisty pomiar? Każde wymaga innych dowodów. Formatowanie może przesłonić zmianę, a zbyt szerokie usuwanie pól może ukryć istotną różnicę.
Aktualizacja z 19.10.2026: Ograniczenia porównania obejmują teraz zmiany kodu wykonawczego dostarczanego przez Google i opcjonalną optymalizację kontenera. Październikowe zmiany w Google Tag i GTM.
Określenie zakresu porównania
Oba eksporty wymagają zapisania konta, kontenera, wersji lub obszaru roboczego, czasu eksportu i zakresu wyboru. Eksport częściowy nie jest równoważny pełnemu. Google dokumentuje, że kontynuowanie eksportu częściowego bez wymaganych zależności może usunąć odwołania do brakujących tagów i reguł, zachowując odwołania do zmiennych.
Identyfikatory obiektów GTM wskazują elementy; nie istnieje ogólna udokumentowana reguła nadawania wszystkich ID na nowo przy każdym eksporcie. Fingerprint to wartość obliczana na podstawie elementu. Dokumentacja API opisuje ponowne obliczenie tej wartości po modyfikacji elementu. Nie oznacza to udokumentowanego znacznika czasu ani dowodu konkretnego autora, czasu edycji lub skutku wykonania. Pola te pozostają ważnym materiałem, nawet gdy dodatkowy widok pomija wybrane metadane.
Najpierw formatowanie bez usuwania wartości
jq -S sortuje klucze obiektów i formatuje JSON. Zachowuje kolejność tablic i zawartość ciągów; spacje w wartości nadal są danymi. Poniższy skrypt Bash wymaga jq i diff, przyjmuje dwie ścieżki i odrzuca puste pliki, wiele dokumentów oraz wejścia bez obiektu containerVersion. Taka kontrola struktury nie jest pełną walidacją schematu GTM.
#!/usr/bin/env bash
set -euo pipefail
if (( $# != 2 )); then
  printf 'Usage: bash compare-gtm.sh old.json new.json\n' >&2
  exit 2
fi
work_dir=$(mktemp -d)
trap 'rm -rf -- "$work_dir"' EXIT
normalise() {
  jq -e -S -s '
    if length != 1 then error("Expected one JSON document")
    elif (.[0] | type) != "object" then error("Expected an object")
    elif (.[0].containerVersion | type) != "object"
      then error("Expected a GTM container export")
    else .[0] end
  ' "$1"
}
normalise "$1" > "$work_dir/old.json"
normalise "$2" > "$work_dir/new.json"
if diff -u -- "$work_dir/old.json" "$work_dir/new.json"; then
  printf 'No differences in this parsed, formatted view.\n'
else
  diff_status=$?
  exit "$diff_status"
fi
Po zapisaniu jako compare-gtm.sh wywołanie ma postać bash compare-gtm.sh old.json new.json. Kod 0 oznacza brak różnic w tym widoku, a 1 różnice znalezione przez diff. Błąd odczytu lub polecenia jest błędem, nie równością. Kolejno zapisywane pliki tymczasowe potwierdzają poprawną normalizację przed porównaniem. Podstawienie procesów takie jak diff <(norm old.json) <(norm new.json) samo nie przenosi każdego błędu polecenia przygotowującego dane do kodu zakończenia diff.
Ten widok nadal zawiera daty, odciski i kontekst wersji. Dodatkowy widok zredukowany wymaga jawnej listy dozwolonych ścieżek pól, opisanego celu i zachowania oryginału. Rekurencyjne usuwanie według nazw takich jak accountId czy fingerprint może usunąć istotne dane zagnieżdżone. Równość po usunięciu oznacza tylko równość zachowanej części.
Znaczenie ma też parser JSON: powtarzające się klucze i bardzo duże liczby wymagają określonych zasad. Zachowanie liczb w jq zależy od wersji i sposobu kompilacji. Przykład nie jest archiwum zachowującym dokładne bajty ani uniwersalnym testem równoważności znaczenia.
Zmienione wartości obok nowych kluczy
Różnica zbiorów kluczy pokazuje dodania i usunięcia, ale pomija zmianę wartości pod istniejącym kluczem. Osobne zestawienie obejmuje wszystkie trzy przypadki na najwyższym poziomie:
jq -n --slurpfile a old.json --slurpfile b new.json '
  if ($a|length) != 1 or ($b|length) != 1 then
    error("Expected one JSON document per file")
  elif ($a[0]|type) != "object" or ($b[0]|type) != "object" then
    error("Expected objects")
  else
    $a[0] as $old | $b[0] as $new
    | ($old|keys) as $ka | ($new|keys) as $kb
    | {removed: ($ka - $kb), added: ($kb - $ka),
       changed: [$ka[] as $key
         | select($new|has($key))
         | select($old[$key] != $new[$key]) | $key]}
  end'
Zmiana głęboko wewnątrz taga może pojawić się tutaj jedynie jako containerVersion. Szczegóły ujawnia sformatowany diff lub porównanie uwzględniające schemat. Ciąg "1" i liczba 1 są różnymi wartościami; podobny wygląd i niewielka liczba znaków nie oznaczają braku znaczenia.
Tożsamość obiektów i kolejność tablic
W jednym kontenerze ID pomagają powiązać elementy między wersjami, lecz usunięcie i ponowne utworzenie lub import mogą stworzyć inny element. Między kontenerami identyfikatorów i kontekstu nie można po prostu skasować. Dopasowanie nazw wymaga jednoznacznej mapy oraz obsługi przemianowań, duplikatów i nierozwiązanych odwołań.
Mapa musi zachować odwołania do reguł uruchamiających i blokujących, folderów, sekwencji tagów, szablonów oraz innych istotnych relacji. Udokumentowane odwołania setup i teardown używają nazw tagów. Zmienne często występują jako {{name}}; nie dowodzi to kompletności globalnej zamiany tekstu ani mapowania samych reguł. Wbudowane identyfikatory reguł wymagają jawnej obsługi, a nie ślepego wyszukiwania na liście wyeksportowanych reguł.
jq -S nie sortuje tablic. Sortowanie list elementów może poprawić dodatkowy widok przeglądu po ustaleniu tożsamości. Sortowanie dowolnych tablic zagnieżdżonych może jednak zmienić znaczenie, także kolejność wierszy tabel. Pierwszy widok pozostawia więc wszystkie tablice bez zmian.
Różnice tekstu nie dowodzą skutków działania
Widoki wierszy, słów i znaków pokazują różne szczegóły. Porównanie wierszami może ustalić równość tekstu i pokazać cudzysłowy zmieniające typ wartości. Niektóre narzędzia rozpoznają również przeniesienia. Diff pokazuje zmianę, lecz zwykle nie wyjaśnia jej powodu ani wpływu na pomiar.
Identyczny JSON nie dowodzi identycznego pomiaru. Informacje Google z 8 października 2026 opisują inicjalizację przy ładowaniu kontenera i widoczne zdarzenia gtag.config, które mogą pasować do szerokich reguł Custom Event. Opcjonalna optymalizacja ogłoszona 12 października obejmuje też ustawienia centralne i tagi celów. Podgląd sprawdza wykonanie, analiza sieci żądania, a raporty docelowe przetwarzanie; samo żądanie przeglądarki nie potwierdza poprawnej atrybucji ani końcowych raportów. Uprawnienia nie są wersjonowane i wymagają osobnego zapisu.
Pytania i odpowiedzi
Czy plik znormalizowany zastępuje oryginalny eksport?
Nie. Niezmienione eksporty stanowią podstawę odtwarzania i audytu. Widok porównawczy nie musi nadawać się do importu ani być kompletny. Eksporty mogą zawierać konfigurację, kod i wrażliwe identyfikatory, dlatego wymagają odpowiedniej kontroli dostępu do repozytorium i usuwania danych wrażliwych z udostępnianych kopii.
Czy Windows zawsze zmienia wszystkie zakończenia wierszy?
Nie. Zależy to od edytora i atrybutów Git. *.json text eol=lf wybiera LF dla pasujących plików tekstowych w katalogu roboczym Git. Już śledzona zawartość może wymagać kontrolowanej renormalizacji; ustawienie nie usuwa spacji wewnątrz ciągów JSON.
Czy diff wskazuje autora zmiany?
Same wartości eksportu nie dowodzą autorstwa. Potrzebny kontekst zapewniają historia wersji, zapisy obszaru roboczego i zachowane dowody audytowe. Odcisk fingerprint nie zastępuje tych zapisów.
Źródła
- Google Tag Manager: eksport i import kontenerów
- Google Tag Manager API: tagi i odwołania
- Google Tag Manager API: wersje kontenera
- jq: podręcznik
- Git: atrybuty i zakończenia wierszy
- Google Tag Manager: informacje o wydaniach
- Google: zmiany w Google Tag i Tag Managerze
- Google: optymalizacja kontenera Tag Managera
- Tag Manager dla witryn
- Dokumentacja Dockera
- Google Tag: obsługiwane metody instalacji
- Google Tag w Tag Managerze: konfiguracja i inicjalizacja
Powiązane artykuły