English
 Deutsch
 Polski
Vocal-Chain in FL Studio: Effektfolge und Messungen zu Hochpass, Kompression und De-Essing

Management Summary
Eine Vocal Chain ist eine Folge von Effekten zur Bearbeitung einer aufgenommenen Gesangsstimme. In FL Studio können einzelne Schritte tiefe Störungen mindern, laute und leise Stellen ausgleichen und scharfe Zischlaute abschwächen. Die Reihenfolge zählt, weil jeder Effekt das Ausgangsmaterial für den nächsten verändert. Ziel ist eine klare, ausgewogene Stimme im Lied. Die Beispiele erklären diese Zusammenhänge; Auswahl und Einstellungen richten sich nach der Aufnahme statt nach einem festen Rezept.
Inhalt
- So wurde gemessen
- 1. Eigene Mixer-Spur und Vorbereitung der Aufnahme
- 2. Tonhöhenkorrektur bei Bedarf
- 3. Tiefe Störungen mit einem Hochpass absenken
- Was ein Hochpass vor diesem Kompressor verändert
- 4. Kompression mit Fruity Limiter im Reiter COMP
- 5. Zischlaute gezielt absenken
- De-Esser vor oder nach dem Kompressor: Einstellungen mitvergleichen
- 6. Weitere Klangbearbeitung nur bei Bedarf
- Hall und Echo über Send-Spuren
- Beispiel für die Aufteilung der Aufgaben
- Gemeinsame Vocal-Spur und abschließende Kontrolle
- Grenzen des Versuchs
- Fragen und Antworten
- Quellen
Eine Vocal Chain ist eine Folge von Effekten für eine Gesangsspur. Ein Hochpass senkt tiefe Störungen ab, ein Kompressor gleicht Pegelunterschiede aus, und ein De-Esser dämpft starke Zischlaute. In FL Studio lassen sich diese Aufgaben auf einer eigenen Mixer-Spur mit zehn Effekt-Steckplätzen ordnen. Nicht jede Aufnahme braucht jeden Effekt.
Dieses Beispiel verbindet Hinweise aus dem FL-Studio-Handbuch mit Messungen an einem künstlichen Stimmsignal in FFmpeg. Gemessen wurden Hochpass, Kompression und De-Essing. Pitcher, Edison, Hall, Delay und Soundgoodizer wurden nicht gemessen. Die Zahlen zeigen das Verhalten des Versuchsaufbaus; die passende Einstellung für eine Aufnahme bleibt von Stimme und Klangziel abhängig.
So wurde gemessen
- Signal: 24 Sekunden Mono bei 48 kHz, mit 48 gleich aufgebauten Silben. Jede Silbe enthält 300 ms Vokal, 120 ms Zischlaut und 80 ms Pause. Der Vokal besteht aus 180 Hz Grundton und Harmonischen bis 4,5 kHz, also ganzzahligen Vielfachen des Grundtons. Spitzenpegel: Vokal −12 dBFS, Zischrauschen von 5 bis 10 kHz −18 dBFS. Hinzu kommen ein Dauerton bei 45 Hz und alle zwei Sekunden ein kurzer 30-Hz-Impuls als Modell einer Plosivstörung, etwa durch einen Luftstoß am Mikrofon. Zusammen erreicht das Signal −1,86 dBFS. 0 dBFS bezeichnet digitale Vollaussteuerung; negative Werte liegen darunter.
- Effekte: FFmpeg 7.1.5. Der Hochpass besteht aus zwei hintereinandergeschalteten Filtern zweiter Ordnung mit zusammen etwa 24 dB Abfall pro Oktave weit unterhalb der Grenzfrequenz. An der Grenzfrequenz beträgt die Absenkung rund 6 dB. Kompressor: Schwelle −20 dBFS, Verhältnis 4:1, Parameter knee=6, Release 120 ms, RMS-Erkennung und keine nachträgliche Verstärkung. knee=6 bezeichnet hier einen Parameterwert, nicht 6 dB. De-Esser: dynamischer Equalizer bei 7 kHz mit Q=1,4, ratio=4 und Attack 1 ms. Q beschreibt die Bandbreite; ratio ist bei diesem Filter ein Verstärkungsfaktor und kein Kompressionsverhältnis von 4:1.
- Auswertung: Eine Fourier-Analyse trennt Frequenzbereiche. Daraus wird der RMS-Pegel berechnet, ein Maß für die mittlere Signalstärke. Für den Vokal gilt das Band 150 Hz bis 4 kHz von 50 bis 280 ms jeder Silbe; für Zischlaute das Band 5 bis 10 kHz von 310 bis 410 ms. Die RMS-Werte werden zuerst linear über 48 Silben gemittelt und danach in dB umgerechnet. Die Lautheit in LUFS stammt aus FFmpegs Messung nach ITU-R BS.1770; ein Unterschied in LU beschreibt die Änderung dieses Messwerts.
- Geltungsbereich: Die Filter und Kompressoren von FFmpeg sind keine Nachbildungen der FL-Plugins. Gemessene Pegel sind außerdem keine Hörbewertung. Identische Reglernamen oder Zahlen garantieren kein identisches Ergebnis.
1. Eigene Mixer-Spur und Vorbereitung der Aufnahme
Der Mixer bietet laut Handbuch 500 Insert-Spuren mit jeweils zehn Effekt-Steckplätzen. Eine eigene Spur erleichtert die getrennte Bearbeitung des Gesangs. Bei der Aufnahme verhindert ausreichender Abstand zu 0 dBFS Übersteuerung durch unerwartete Spitzen; ein bestimmter Zielpegel passt nicht zu jeder Signalkette. Der verlinkte Pufferrechner berechnet Zeitanteile aus Puffergröße und Abtastrate. Die kleinste störungsfrei nutzbare Einstellung hängt zusätzlich von Treiber, Gerät und Rechnerlast ab. Weiterführend: Latenz- und Puffer-Rechner
Edison ist ein Audioeditor in einem Effekt-Steckplatz und nimmt das Signal an dieser Stelle auf. Reinigung und Schnitt erfolgen am aufgenommenen Material. Anschließend gelangt der bearbeitete Clip zurück in die Playlist. Das Laden von Edison allein schaltet keine automatische Reparatur der laufenden Gesangsspur ein. Rauschminderung, Entknacksen und Reparatur übersteuerter Stellen können helfen, ersetzen aber keine unverzerrte Aufnahme.
2. Tonhöhenkorrektur bei Bedarf
Pitcher korrigiert einstimmiges Material anhand von Tonart und Skala. Die Korrekturgeschwindigkeit beeinflusst hörbare Tonübergänge. Formantfunktionen beeinflussen die Klangfarbe bei Tonhöhenänderungen; eine unveränderte Stimme ist dadurch nicht garantiert. MIDI kann Zielnoten vorgeben, und Harmonize erzeugt zusätzliche Stimmen.
Image-Line empfiehlt für Pitcher ein trockenes, einstimmiges Eingangssignal und eine frühe Position im Effektweg. Hall, Akkorde oder mehrere Stimmen erschweren die Tonhöhenerkennung. Das ist ein konkreter Grund für die frühe Platzierung; eine allgemeine Pflicht, jede Tonhöhenkorrektur vor jeden Kompressor zu setzen, folgt daraus nicht.
3. Tiefe Störungen mit einem Hochpass absenken
Ein Equalizer verändert die Stärke einzelner Frequenzbereiche. Fruity Parametric EQ 2 bietet sieben Bänder, darunter Hochpassfilter. Ein Hochpass senkt tiefe Frequenzen ab und lässt höhere weitgehend passieren. Steilheit und Filterform beeinflussen das Ergebnis. Auch bei gleichem Wert von 24 dB pro Oktave können zwei Filter an der Grenzfrequenz unterschiedlich stark absenken. Der FFT-Modus mit linearer Phase erhöht die Plugin-Latenz; der Standardmodus eignet sich deshalb eher für einen latenzarmen Aufnahmeweg.
Die folgende Tabelle zeigt den FFmpeg-Hochpass. Das Band 10 bis 100 Hz enthält überwiegend die zugesetzten tiefen Störungen; das Band 150 bis 250 Hz enthält den Grundton. Die Werte sind Band-RMS-Pegel des gesamten Signals, keine getrennte Messung einzelner Schallquellen.
| Hochpass | Tiefes Band 10–100 Hz | Grundtonband 150–250 Hz | Spitzenpegel |
|---|---|---|---|
| ohne | −20,91 dBFS | −23,96 dBFS | −1,86 dBFS |
| 60 Hz | −34,85 dBFS | −24,06 dBFS | −10,87 dBFS |
| 80 Hz | −43,17 dBFS | −24,29 dBFS | −10,47 dBFS |
| 100 Hz | −50,29 dBFS | −24,75 dBFS | −10,70 dBFS |
| 120 Hz | −56,31 dBFS | −25,53 dBFS | −11,32 dBFS |
| 150 Hz | −63,86 dBFS | −27,38 dBFS | −12,78 dBFS |
Bei 100 Hz sinkt der Pegel im tiefen Band um 29,38 dB, im Grundtonband um 0,79 dB. Bei 150 Hz sind es 42,95 und 3,42 dB. Ein höherer Hochpass entfernt hier mehr tiefe Energie, schwächt aber auch den Grundton stärker. Schon 60 Hz senken den Spitzenpegel um rund 9 dB. Dieser zusätzliche Abstand zu 0 dBFS entsteht nach der Bearbeitung und kann eine bereits übersteuerte Aufnahme nicht reparieren.
Eine feste Grenzfrequenz passt nicht zu allen Stimmen. Entscheidend ist, welche tiefen Anteile stören und welche zum gewünschten Stimmklang gehören. Eine halbe Oktave unter 180 Hz liegt rechnerisch bei etwa 127 Hz, nicht bei 120 Hz. Auch dieser Abstand ist keine allgemeine Einstellregel; die 100 Hz im Versuch sind eine gewählte Vergleichseinstellung.
Was ein Hochpass vor diesem Kompressor verändert
Der untersuchte Kompressor steuert seine Absenkung anhand des vollständigen Eingangssignals. Tiefe Störungen können deshalb auch den Vokal mit absenken. Ein zuvor gesetzter Hochpass verringert diesen Einfluss. Kompressoren mit gefiltertem Steuersignal können anders reagieren. Bei sonst gleichen Einstellungen ergibt der Versuch:
| Reihenfolge | Vokalpegel | Lautheit | Spitzenpegel | Einbruch bei Plosiv-Silben |
|---|---|---|---|---|
| Hochpass, dann Kompressor | −23,72 dBFS | −25,8 LUFS | −13,61 dBFS | 0,01 dB |
| Kompressor, dann Hochpass | −25,06 dBFS | −27,1 LUFS | −14,16 dBFS | 1,45 dB |
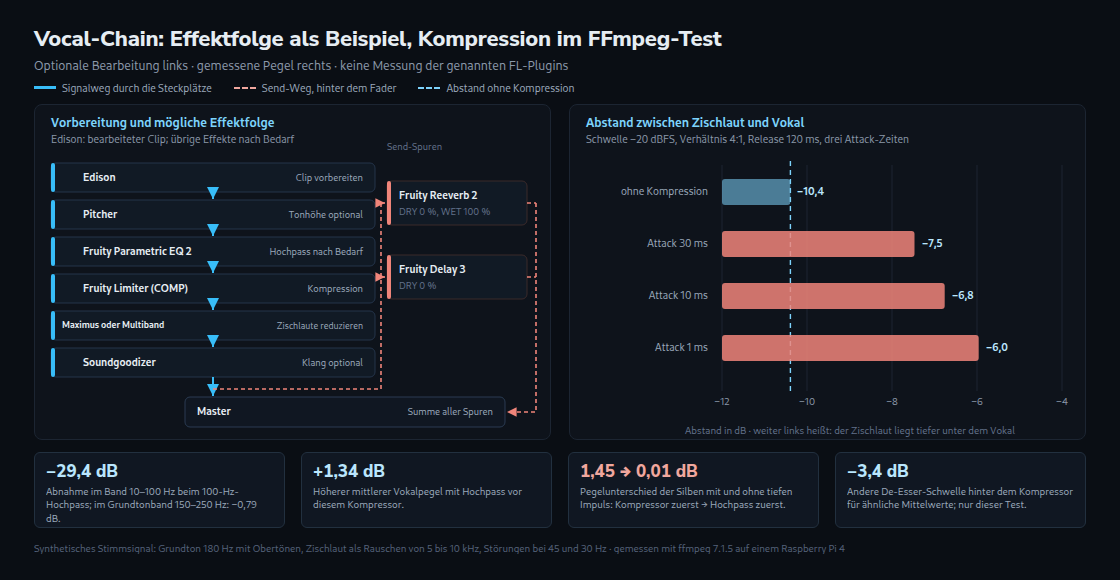
Mit Hochpass vor dem Kompressor liegt der mittlere Vokalpegel um 1,34 dB höher, die gemessene Lautheit um 1,3 LU. Silben mit zugesetztem Plosivimpuls liegen bei umgekehrter Reihenfolge durchschnittlich 1,45 dB unter den übrigen Silben; mit Hochpass zuerst sind es noch 0,01 dB. Das beschreibt einen gemessenen Pegelunterschied. Ob der Unterschied als kurzes Wegdrücken hörbar ist, wurde nicht getestet.
4. Kompression mit Fruity Limiter im Reiter COMP
THRESH bestimmt die Einsatzschwelle, RATIO das Verhältnis oberhalb dieser Schwelle und KNEE den Übergang zur Absenkung. ATT im Reiter COMP beeinflusst, wie schnell die Kompression einsetzt; REL beeinflusst das Zurücknehmen der Absenkung. Sehr kurze Zeiten können Verzerrungen erzeugen. SUSTAIN steuert die Mittelung der Pegelerkennung. GAIN verstärkt hinter dem Kompressor und vor dem Limiter. Wichtig: COMP-ATT erzeugt laut Handbuch kein Lookahead. Erst ATT im Reiter LIMIT bestimmt den zeitlichen Vorlauf des Limiters und damit dessen Verzögerung.
Das Testbeispiel verwendet 4:1, Attack 10 ms und Release 120 ms. Solche Zahlen sind Startpunkte für einen Vergleich, keine Vorgabe für jede Stimme. Entscheidend sind gleichmäßige Silben, erhaltene Anlaute und ein Vergleich bei ähnlicher Ausgangslautheit. Der verlinkte Sidechain-Artikel erklärt die Steuerung durch eine andere Spur. Weiterführend: Sidechain-Kompression in FL Studio
5. Zischlaute gezielt absenken
Ein De-Esser verringert starke Zischlaute, etwa ein hervortretendes „s“. Häufig liegt der relevante Bereich zwischen 4 und 12 kHz; die genaue Lage hängt von Stimme und Aufnahme ab. Im Unterschied zu einer dauerhaften EQ-Absenkung wird der Bereich nur bei entsprechender Auslösung abgesenkt. Das kann helle Anteile außerhalb der Zischlaute besser erhalten.
Im Maximus-Preset „De-esser Split Band“ ist die Kompression im tiefen Band deaktiviert: Der tiefe Signalanteil bleibt hörbar. Das hohe Band ist ausgeschaltet, wodurch das mittlere Band bis 20 kHz reicht; auch die Master-Kompression ist deaktiviert. Das mittlere Band begrenzt den oberen Bereich. PRE GAIN bestimmt, wie stark das Signal in diese Bearbeitung gelangt, POST GAIN gleicht die Verstärkung anschließend aus. Fruity Multiband Compressor bietet alternativ drei getrennt bearbeitbare Bänder. Trennfrequenzen, Schwelle und Zeitverhalten benötigen eine Anpassung an die Aufnahme.
Im Versuch senkt der Kompressor die lauteren Vokale stärker ab als die leiseren Zischabschnitte. Dadurch liegen beide Pegel näher beieinander. „Abstand“ in der Tabelle bedeutet Zischpegel minus Vokalpegel; ein weniger negativer Wert bedeutet relativ stärkere Zischlaute.
| Bearbeitung | Vokalpegel | Zischpegel | Abstand | Änderung |
|---|---|---|---|---|
| ohne Kompression | −19,29 dBFS | −29,68 dBFS | −10,39 dB | Bezug |
| Attack 30 ms | −22,34 dBFS | −29,81 dBFS | −7,47 dB | +2,92 dB |
| Attack 10 ms | −23,21 dBFS | −29,97 dBFS | −6,76 dB | +3,63 dB |
| Attack 1 ms | −24,50 dBFS | −30,46 dBFS | −5,96 dB | +4,43 dB |
Die Zischabschnitte verlieren höchstens 0,78 dB, die Vokale bis zu 5,21 dB. Der Abstand schrumpft gegenüber dem unbearbeiteten Signal um 2,92 bis 4,43 dB. Das erklärt eine mögliche Zunahme der relativen Zischlautstärke trotz sinkender absoluter Pegel. Eine hörbare Schärfe oder eine allgemeine Wirkung jedes schnellen Attacks lässt sich aus diesem Test allein nicht ableiten.
De-Esser vor oder nach dem Kompressor: Einstellungen mitvergleichen
Ein zweiter Versuch stellt die De-Esser-Schwelle für jede Position getrennt ein. Ziel ist jeweils der ursprüngliche mittlere Abstand von −10,39 dB zwischen Zischlaut und Vokal. Die übrigen Einstellungen bleiben gleich:
| Stellung | Angepasste Schwelle im Test | Zischpegel am Ende | Vokalpegel am Ende |
|---|---|---|---|
| De-Esser vor dem Kompressor | −41,8 dB | −34,16 dBFS | −23,77 dBFS |
| De-Esser hinter dem Kompressor | −45,2 dB | −34,24 dBFS | −23,85 dBFS |
Die Endpegel liegen mit diesen angepassten Schwellen innerhalb von 0,09 dB beieinander. Hinter dem Kompressor liegt die nötige Schwelle im Versuch 3,4 dB tiefer. Das bloße Verschieben bei unveränderten Reglern beantwortet deshalb nicht, ob beide Positionen eine ähnliche Balance erreichen können. Gleiche Mittelwerte beweisen jedoch weder identische Wellenformen noch gleichmäßige Bearbeitung jeder einzelnen Silbe.
Beide Positionen sind möglich. Hinter dem Kompressor lässt sich dessen bereits veränderte Balance bearbeiten; davor lassen sich starke Zischlaute schon am Eingang begrenzen. Schwelle und Rücklaufzeit benötigen einen Vergleich im vollständigen Effektweg. Eine pauschale Release-Empfehlung von 5 bis 40 ms lässt sich aus den Versuchsergebnissen nicht ableiten.
6. Weitere Klangbearbeitung nur bei Bedarf
Soundgoodizer arbeitet mit dem Maximus-Modell und mischt das Eingangssignal mit bearbeiteten Ausgängen der drei Kompressorbänder. Die Presets A bis D legen unterschiedliche Bearbeitungen fest. Das Plugin ist deshalb kein reiner Sättigungseffekt. Eine zusätzliche Klangbearbeitung kann passen, ist aber weder Pflicht noch zwingend der letzte Schritt einer Vocal Chain.
Nach weiterer Dynamikbearbeitung oder Verzerrung lohnt eine erneute Prüfung der Zischlaute. Nichtlineare Verzerrung kann zusätzliche Harmonische erzeugen. Soundgoodizer und Sättigung wurden im vorliegenden Versuch nicht gemessen.
Hall und Echo über Send-Spuren
Eine Send-Spur ist ein zusätzlicher paralleler Effektweg: Die trockene Stimme bleibt hörbar, während eine Kopie Hall oder Echo erhält. Das erleichtert getrennte Einstellungen und gemeinsame Räume für mehrere Spuren. Hall und Delay können ebenso als Insert mit passendem Mischverhältnis arbeiten. Mixer-Sends liegen hinter dem Fader; Fruity Send ermöglicht einen früheren Abgriff im Effektweg.
Auf einer reinen Hall-Send-Spur nennt das Handbuch für Fruity Reeverb 2 DRY 0 % und WET 100 %. So gelangt keine zweite trockene Stimme aus dem Hallweg in die Summe. DELAY verschiebt den Beginn der Reflexionen. DEC beschreibt den Abfall um 60 dB relativ zum Hallbeginn, nicht einen absoluten Zielpegel von −60 dBFS. Filter und Dämpfung verändern den Klang der Hallfahne.
Für einen reinen Echo-Send in Fruity Delay 3 steht auch der Ausgangsregler DRY auf 0 %. Die Verzögerung lässt sich in Millisekunden oder passend zum Tempo einstellen. 16 Schritte entsprechen einem Takt bei der üblichen 4/4-Einteilung, nicht bei jedem Taktmaß. Bei einem Mono-Eingang benötigt Ping Pong laut Handbuch zusätzlich eine passende PAN-Einstellung, damit die Wiederholungen zwischen den Seiten wechseln. Der BPM-Rechner liefert passende Zeitwerte. Weiterführend: BPM- und Delay-Rechner
Beispiel für die Aufteilung der Aufgaben
| Stufe | Plugin | Aufgabe | Beispiel / Hinweis |
|---|---|---|---|
| Vorbereitung | Edison | Clip bearbeiten | Nur bei Bedarf; bearbeiteten Clip zurückführen |
| Optional | Pitcher | Tonhöhe | Tonart und Korrektur passend zur Aufnahme |
| Optional | Fruity Parametric EQ 2 | Tiefe Störungen | Grenzfrequenz nach Stimme und Störung |
| Optional | Fruity Limiter (COMP) | Pegel ausgleichen | Test: 4:1, 10 ms Attack, 120 ms Release |
| Optional | Maximus / Multiband Compressor | Zischlaute | Band, Schwelle und Zeiten passend zum Signal |
| Optional | Soundgoodizer | Klang und Dynamik | Preset und Mischung nach Klangziel |
| Send | Fruity Reeverb 2 | Hall | DRY 0 %, WET 100 % |
| Send | Fruity Delay 3 | Echo | Ausgang DRY 0 %, Zeit passend zum Tempo |
Gemeinsame Vocal-Spur und abschließende Kontrolle
Mehrere Gesangsspuren lassen sich auf einer gemeinsamen Bus-Spur zusammenführen. Eine weitere Kompression ist optional. Der Signalweg sollte die Stimmen nicht versehentlich gleichzeitig direkt und über den Bus zum Master schicken. LUFS beschreibt die gemessene Lautheit; True Peak schätzt auch Spitzen zwischen den gespeicherten Abtastwerten. Beide Werte helfen bei der Kontrolle des fertigen Signals. Ein Korrelations- oder Mid/Side-Messwert des gesamten Mixes beweist jedoch nicht, dass eine einzelne Stimme mittig steht; dafür sind unter anderem die isolierte Spur, Panorama und Links-rechts-Pegel relevant. Der verlinkte Mastering-Artikel behandelt den fertigen Mix. Weiterführend: LUFS- und True-Peak-Messer · Werkzeug für Stereo-Korrelation und Mid/Side · Mastering auf Streaming-Lautheit
Grenzen des Versuchs
- FFmpeg-Filter und FL-Plugins arbeiten unterschiedlich. Besonders Maximus besitzt frei formbare Kennlinien. Die Zahlen dieses Artikels sind keine Messwerte der genannten FL-Plugins und keine direkt übertragbaren Presets.
- Das künstliche Signal enthält regelmäßig angeordnete Silben, keinen Raumklang, keine Atemgeräusche und kein Vibrato. Reale Aufnahmen können größere, kleinere oder andere Effekte der Reihenfolge zeigen.
- Der Hochpassvergleich gilt für dieses Signal mit 180-Hz-Grundton und den zugesetzten Störungen. Andere Stimmen, Filterformen und Störspektren verändern das Ergebnis. Die scharfe Bandtrennung der Auswertung kann zudem Zeitverläufe beeinflussen.
- Bei unveränderter Schwelle zeigt ein zusätzlicher Versuch mit Release 40 ms eine Zischabsenkung von 19,40 dB vor und 5,15 dB nach dem Kompressor. Mit 5 ms liegen die Werte bei 15,19 und 15,32 dB. Mit 200 ms sinkt außerdem der Vokalpegel um 5,34 beziehungsweise 3,21 dB. Die Ursache der starken Differenz bei 40 ms wurde nicht isoliert. Das Ergebnis ist reproduziert, rechtfertigt aber keine allgemeine Empfehlung dieser Rücklaufzeit.
- Die Angaben zur Bedienung stammen aus dem Image-Line-Handbuch. Ein praktischer Test dieser FL-Plugins und ein Hörvergleich gehören nicht zur Messung.
Fragen und Antworten
Warum bleibt eine Silbe leiser, obwohl ein nachgeschalteter Hochpass den tiefen Impuls entfernt?
Im Versuch löst der tiefe Impuls bereits im Kompressor eine stärkere Absenkung aus. Diese klingt mit der eingestellten Rücklaufzeit aus und betrifft dadurch auch den Vokal. Ein späterer Hochpass entfernt tiefe Energie, macht die zuvor angewandte Pegelabsenkung aber nicht rückgängig. Im gemessenen Vergleich beträgt der Unterschied zwischen betroffenen und übrigen Silben durchschnittlich 1,45 dB.
Kann ein Kompressor auf dem Vocal-Bus Zischlaute wieder hervorheben?
Das ist möglich, aber nicht zwangsläufig. Entscheidend ist, welche Anteile die Absenkung auslösen und wie lange diese anhält. Im Einzelspurversuch werden Vokale stärker abgesenkt als Zischlaute. Daraus lässt sich keine feste Veränderung pro Dezibel Bus-Kompression ableiten, zumal sich mehrere Stimmen zeitlich überlagern können.
Die abschließende Zischlautkontrolle umfasst deshalb auch den Bus und nachfolgende Effekte. Ein zusätzlicher De-Esser auf dem Bus kann helfen; eine Bearbeitung einzelner auffälliger Spuren kann ebenso passen. Die Summe benötigt eine eigene Beurteilung statt automatisch schärferer Einstellungen.
Welche Effekte erhöhen die Verzögerung beim Einsingen?
Lineare-Phase-EQ und Lookahead-Limiter können zusätzliche Verzögerung verursachen. Bei Fruity Limiter ist dafür LIMIT-ATT relevant, nicht COMP-ATT. Auch weitere Plugins und der Audio-Treiber können beitragen. Die Plugin-Latenzanzeige und ein Test des tatsächlichen Aufnahmewegs sind aussagekräftiger als eine Liste mit nur zwei vermeintlichen Ursachen.
Die Verzögerungskompensation gleicht vorhandene Spuren bei der Wiedergabe zeitlich an. Die verzögerte Stimme im Kopfhörer wird dadurch beim Einsingen nicht früher hörbar. Ein sparsamer Aufnahmeweg mit latenzarmen Effekten kann helfen; weitere Bearbeitung lässt sich nach der Aufnahme ergänzen.
Quellen
- Image-Line: Mixer – Effekt-Steckplätze, Busse und Send-Signalwege.
- Image-Line: Fruity Parametric EQ 2 – Filterformen und Latenz des FFT-Modus.
- Image-Line: Fruity Limiter – getrennte Attack-Funktionen in COMP und LIMIT sowie Signalfluss.
- Image-Line: De-Essing Options in FL Studio – Grundlagen der frequenzabhängigen Zischlautbearbeitung.
- Image-Line: Maximus Tutorials – Aufbau des Split-Band-De-Esser-Presets.
- Image-Line: Fruity Multiband Compressor – drei Frequenzbänder und deren Bearbeitung.
- Image-Line: Fruity Reeverb 2 – Send-Einstellungen und relative Abklingzeit.
- Image-Line: Fruity Delay 3 – Zeitsteuerung, trockener Ausgang und Ping-Pong-Betrieb.
- Image-Line: Pitcher – einstimmiger Eingang, Tonhöhenkorrektur und Harmonize.
- Image-Line: Soundgoodizer – Mischung mit den bearbeiteten Maximus-Bändern.
- Image-Line: Edison – Aufnahme und Bearbeitung von Audioclips.
- FFmpeg 7.1.5 – Filterparameter des reproduzierten Messaufbaus.
Passend dazu