English
 Deutsch
 Polski
Integracje GTM dla Claude Code: trzy serwery MCP, liczba narzędzi i koszt kontekstu

Management Summary
Asystenci AI mogą pomagać w przygotowaniu pomiaru witryny w Google Tag Managerze, na przykład rejestrowania zakończonych zakupów. Integracje MCP łączą w tym celu Claude Code z ustawieniami pomiaru. Trzy porównane pakiety inaczej organizują narzędzia, lecz sama liczba narzędzi niewiele mówi o użyteczności lub kosztach. Ważniejsze są właściwe uprawnienia, oddzielenie szkicu od publikacji i rzetelne zmiany. Faktyczne zużycie pozwala ocenić koszty lepiej niż długość listy narzędzi.
Spis treści
- Narzędzia, bezpośrednie wywołania API i skille
- Co oznaczają historyczne rozmiary
- Oddzielenie szkicu od publikacji
- Odczyt tagów szkicu i opublikowanej wersji
- Trzy kontrole dostępu
- GTM_SCOPES nie działa przy każdym sposobie logowania
- Zmiana bez przypadkowej utraty ustawień
- Kontrola w przeglądarce i opis zmiany
- Pytania i odpowiedzi
- Źródła
Asystent AI może przygotować w Google Tag Managerze tag dla zakończonych zakupów. Integracja potrzebuje dostępu do właściwego kontenera. Kontener grupuje tagi, reguły uruchamiania i zmienne; eksport JSON opisuje te ustawienia jako tekst. Prawa dostępu są ważniejsze niż liczba dostępnych narzędzi.
Porównanie obejmuje trzy pakiety MCP. MCP to protokół, przez który asystent może wywoływać narzędzia. Pierwotny pomiar z 9 września 2026 roku podaje liczby narzędzi i rozmiary odpowiedzi dla konkretnych wersji pakietów. Surowe protokoły tamtego pomiaru nie są dostępne w tej weryfikacji. Wartości pozostają oznaczone jako dane historyczne; aktualne zasady API i kod pakietów sprawdzono osobno.
Narzędzia, bezpośrednie wywołania API i skille
Serwer MCP może udostępniać na przykład narzędzie odczytujące tag. Claude Code przekazuje argumenty, serwer wywołuje API Tag Managera i zwraca wynik. Lokalny serwer może komunikować się przez wejście i wyjście procesu, czyli stdio; zdalny serwer może używać HTTP.
Bezpośrednie żądanie curl nie wymaga MCP. Nadal muszą zgadzać się adres API, token dostępu i format danych. Instrukcje oraz wyniki również na tej drodze zajmują kontekst. Token dostępu jest czasowym poświadczeniem; zakresy OAuth określają żądane rodzaje dostępu.
Skill może zawierać instrukcje, kroki kontroli i skrypty pomocnicze. Ustawienia skilla w Claude Code mogą też z góry dopuszczać wywołania narzędzi. Skill nie tworzy jednak brakujących uprawnień Google. Dostęp zależy od rzeczywistych narzędzi, poświadczeń i uprawnień konta.
Co oznaczają historyczne rozmiary
| Wersja pakietu | Podana liczba narzędzi | Podane bajty tools/list |
|---|---|---|
google-tag-manager-mcp-server 5.1.1 |
18 | 108201 |
gtm-mcp 1.0.0 |
104 | 49656 |
@theethosteam/gtm-mcp 1.1.1 |
33 | 19797 |
Podane bajty opisują zgłoszoną wtedy odpowiedź na tools/list, czyli opisy wszystkich oferowanych narzędzi. Definicja zawiera między innymi nazwę, opis i pola wejściowe. Kilka narzędzi może więc wymagać więcej tekstu niż wiele małych narzędzi.
Pierwotne porównanie opisuje pierwszy serwer jako zestaw narzędzi według rodzaju obiektu: na przykład gtm_tag łączy odczyt i edycję przez parametr action. Drugi rozdziela znacznie więcej wywołań API na osobne narzędzia. Sprawdzony kod trzeciego pakietu potwierdza gotowe zadania oraz gtm_raw do bezpośrednich metod API.
Wcześniejsze wartości około 27 000, 12 400 i 4900 tokenów to jedynie przybliżenia na podstawie bajtów, a nie pomiary tokenizerem konkretnego modelu. Tokeny są jednostkami tekstu przetwarzanymi przez model. Formatowanie JSON, kodowanie znaków i tokenizer wpływają na wynik.
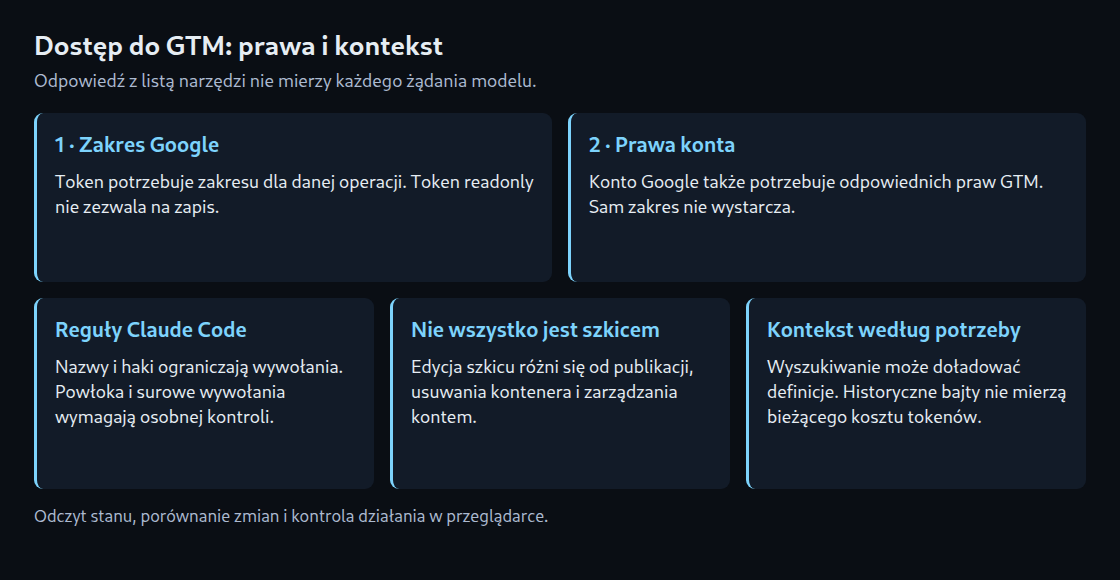
Claude Code może obecnie wyszukiwać narzędzia MCP i wczytywać definicje dopiero w razie potrzeby. Nie każda pełna definicja trafia więc automatycznie do każdego żądania modelu. O zachowaniu decydują ustawienia, wersja klienta i platforma. Lista o rozmiarze 108 201 bajtów nie oznacza zatem stałego zajęcia kontekstu ani stałej ceny każdej tury.
Buforowanie promptu może obniżyć cenę powtarzanych danych wejściowych, które zostały już wczytane. Trafienie w bufor nie zmniejsza jednak liczby przetwarzanych tokenów kontekstu. Trafienia, koszt zapisu i oszczędność zależą od modelu, żądania i konfiguracji bufora. Rzeczywiste dane zużycia są przy porównywaniu kosztów ważniejsze niż szacunek z bajtów.
Oddzielenie szkicu od publikacji
Publiczny opis API pobrany 25 października 2026 roku ma rewizję 20261021. Dokument zawiera 270 858 bajtów i 106 metod: 38 GET, 38 POST, 15 PUT i 15 DELETE. To liczba metod API, a nie narzędzi serwera MCP.
Przestrzeń robocza jest szkicem wewnątrz kontenera. Zmiana konfiguracji tagu nie zastępuje automatycznie opublikowanej wersji domyślnej. Zwykle workspaces.create_version najpierw tworzy wersję, a versions.publish publikuje wersję. Podgląd i środowiska niestandardowe wymagają osobnego uwzględnienia.
Ten przebieg nie czyni innych uprawnień API nieszkodliwymi. Usuwanie kontenerów, zmiana praw użytkowników i edycja środowisk nie są jedynie szkicami tagów. W sprawdzonym dokumencie discovery dokładnie dwie metody używają zakresu tagmanager.publish. Nie wynika z tego, że pozostałe metody nie mogą wpłynąć na działający system.
Odczyt tagów szkicu i opublikowanej wersji
Lista tagów przestrzeni roboczej wymaga jej identyfikatora. Opublikowaną wersję można natomiast odczytać przez versions:live; odpowiedź zawiera także tagi tej wersji. Poniższy przykład tylko odczytuje dane. Identyfikatory i token reprezentują wartości z uprawnionej konfiguracji.
# Przykładowe ID; TOKEN musi zawierać uprawniony token dostępu.
ACC=6012345678
CONT=123456789
WS=42
: "${TOKEN:?Wymagany token dostępu}"

# Tagi szkicu w jednej przestrzeni roboczej
curl --silent --show-error --fail-with-body \
  --connect-timeout 10 --max-time 30 \
  -H "Authorization: Bearer $TOKEN" \
  "https://tagmanager.googleapis.com/tagmanager/v2/accounts/$ACC/containers/$CONT/workspaces/$WS/tags"

# Opublikowana wersja z tagami; bez ID przestrzeni roboczej
curl --silent --show-error --fail-with-body \
  --connect-timeout 10 --max-time 30 \
  -H "Authorization: Bearer $TOKEN" \
  "https://tagmanager.googleapis.com/tagmanager/v2/accounts/$ACC/containers/$CONT/versions:live"
Brak tokenu, wygaśnięcie tokenu i niewystarczające prawa mogą powodować różne błędy. Jeden komunikat nie jest gwarantowaną odpowiedzią każdej metody API. --fail-with-body sygnalizuje błędy HTTP kodem zakończenia i zachowuje treść odpowiedzi; opcja wymaga odpowiedniej wersji curl.
Trzy kontrole dostępu
Po pierwsze, token musi zawierać wymagany zakres OAuth. Po drugie, powiązane konto Google potrzebuje odpowiednich praw w Tag Managerze. Sam zakres publikacji nie pozwala publikować kontu bez prawa publikacji. Obie kontrole działają także poza Claude Code.
Po trzecie, Claude Code może blokować konkretne wywołania lub wymagać potwierdzenia. Reguła dla mcp__gtm__gtm_version dotyczy tego narzędzia. Hak PreToolUse może dodatkowo sprawdzać pola wejściowe, na przykład action. Hak to skrypt zwracający decyzję przed wywołaniem.
Reguła nazwy narzędzia nie kontroluje osobnego wywołania curl. Jeżeli te same poświadczenia są dostępne w powłoce, nadal obowiązują tam zakresy Google i prawa konta, ale nie ta reguła nazwy MCP. Otwarty dostęp do surowych wywołań może też zastąpić zablokowane narzędzia specjalistyczne. Potrzebna jest wspólna ocena wszystkich dostępnych dróg.
GTM_SCOPES nie działa przy każdym sposobie logowania
Sprawdzona wersja CLI google-tag-manager-mcp-server@5.1.1 używa zakresu wersji pakietu core od 2.1.1. W osobno sprawdzonym core 2.1.1 zmienna GTM_SCOPES trafia do generowania tokenu tylko przy uwierzytelnianiu konta usługowego. Bez własnego wyboru żądanych jest siedem zakresów Tag Managera.
W gałęzi tokenu odświeżającego lub tokenu dostępu ta sama zmienna środowiskowa nie zmienia istniejących praw. Ograniczenie wymaga poświadczenia Google z odpowiednim zakresem. Poniższa konfiguracja pokazuje tylko wariant konta usługowego. Wartość klucza jest zastępcza; prawdziwe klucze nie powinny trafiać do publicznego repozytorium.
W tej konfiguracji Claude Code zastępuje ${GTM_SERVICE_ACCOUNT_KEY} wartością zmiennej środowiskowej. Wartość musi zawierać pełny JSON klucza konta usługowego, a nie ścieżkę pliku. Konto potrzebuje także odpowiednich praw Tag Managera.
{
  "mcpServers": {
    "gtm": {
      "command": "npx",
      "args": [
        "-y",
        "google-tag-manager-mcp-server@5.1.1"
      ],
      "env": {
        "GOOGLE_SERVICE_ACCOUNT_KEY": "${GTM_SERVICE_ACCOUNT_KEY}",
        "GTM_SCOPES": "https://www.googleapis.com/auth/tagmanager.readonly"
      }
    }
  }
}
Stała wersja CLI ułatwia odtworzenie porównania, ale nie ustala automatycznie wszystkich wersji zależności. Dokładne odtworzenie wymaga także zapisanego rozwiązania zależności. Poszczególne pakiety MCP używają ponadto różnych nazw poświadczeń i sposobów logowania.
Zmiana bez przypadkowej utraty ustawień
Aktualizacja zaczyna się od odczytu bieżącego obiektu. Następnie zmienia się zamierzone pole i przesyła pełny obiekt wymagany przez daną metodę. Żądanie PUT nie oznacza automatycznie częściowego uzupełnienia. To konkretna metoda i serwer określają, które pola mogą zostać pominięte.
fingerprint oznacza odczytany stan obiektu. Przy tags.update ten parametr kontrolny jest w API opcjonalny. Jeżeli stary odcisk zostanie przesłany po zmianie zapisanej wartości, wartości przestaną się zgadzać. Bez przesłania odcisku ta ochrona nie działa. Zgodny odcisk nadal nie dowodzi poprawności konfiguracji tagu.
Parametry tagu mogą zawierać listy i zagnieżdżone obiekty. Identyfikator pomiaru, odwołanie do zmiennej i odwołanie do tagu to różne wartości. Aktualny eksport właściwego typu tagu jest więc lepszym punktem wyjścia niż przypadkowy przykład GA4 w JSON. Przywołane zmienne i reguły muszą także istnieć w kontenerze docelowym.
Kontrola w przeglądarce i opis zmiany
quick_preview tworzy wersję podglądową. Wywołanie nie otwiera witryny i nie dowodzi, że zdarzenie zakupu dociera we właściwej chwili. Kontrola w przeglądarce powinna obejmować reguły, wartości warstwy danych i stany zgody. Dodatkowa integracja przeglądarki może pomóc, ale samo wywołanie API nie wykonuje tych testów.
Nazwa i opis wersji mogą zapisywać powód zmiany. Te informacje nie powstają automatycznie z promptu i mogą zostać zmienione także później w zarządzaniu wersjami. Eksport przed zmianą i po zmianie dodatkowo pokazuje faktyczną różnicę. Samo porównanie nie wymaga kolejnych poświadczeń Google, gdy oba pliki są już dostępne.
Pytania i odpowiedzi
Czy mniejsza lista narzędzi zawsze jest lepsza?
Nie. Krótkie definicje mogą słabiej wyjaśniać poprawne dane wejściowe. Dokładne definicje mogą zapobiegać błędom. Liczą się zadanie, jakość opisów i rzeczywiście wczytany kontekst. Z rozmiaru nie wynika stały czas odpowiedzi API.
Czy jedno narzędzie może odczytywać i publikować?
Tak. Przy połączonych akcjach reguła samej nazwy może zablokować oba działania. Kontrola parametru akcji jest dokładniejsza, ale musi odpowiadać zainstalowanej wersji serwera. Osobne narzędzie publikacji łatwiej zablokować pojedynczo.
Po co osobna przestrzeń robocza?
Osobny szkic grupuje powiązane zmiany i ułatwia kontrolę lub odrzucenie całości. Zmiany z innych przestrzeni nadal mogą wymagać synchronizacji i rozwiązania konfliktów. workspaces.sync wspiera ten proces. Dostępna liczba równoległych przestrzeni zależy od oferty Tag Managera.
Co dowodzi nieudany start pakietu?
Błąd o brakującej konfiguracji bazy lub klucza dowodzi najpierw tylko braku warunków potrzebnych do tego uruchomienia. Nie oznacza, że pakiet nigdy nie może działać lokalnie. Dokumentacja pakietu i wymagane usługi określają możliwe sposoby wdrożenia.
Źródła
- https://code.claude.com/docs/en/mcp
- https://code.claude.com/docs/en/skills
- https://code.claude.com/docs/en/hooks
- https://developers.google.com/tag-platform/tag-manager/api/v2/authorization
- https://developers.google.com/tag-platform/tag-manager/api/reference/rest/v2/accounts.containers.versions/live
- https://developers.google.com/tag-platform/tag-manager/api/reference/rest/v2/accounts.containers.workspaces.tags/update
- https://developers.google.com/tag-platform/tag-manager/api/reference/rest/v2/accounts.containers/delete
- https://developers.google.com/tag-platform/tag-manager/api/reference/rest/v2/accounts.containers.environments/update
- https://developers.google.com/tag-platform/tag-manager/api/reference/rest/v2/accounts.containers.versions/update
- https://tagmanager.googleapis.com/$discovery/rest?version=v2
- https://registry.npmjs.org/google-tag-manager-mcp-core/2.1.1
- https://registry.npmjs.org/google-tag-manager-mcp-server/5.1.1
- https://registry.npmjs.org/gtm-mcp/1.0.0
- https://registry.npmjs.org/@theethosteam/gtm-mcp/1.1.1
- https://curl.se/docs/manpage.html#–fail-with-body
- https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- https://developers.google.com/tag-platform/tag-manager/api/v2
- https://docs.claude.com/en/docs/claude-code/mcp
Powiązane artykuły