English
 Deutsch
 Polski
Lokalny model językowy z Ollama za proxy z uwierzytelnianiem

Management Summary
Model językowy tworzy odpowiedzi tekstowe na podstawie poleceń. Ollama na własnym sprzęcie pozwala udostępnić tę funkcję aplikacjom z większą kontrolą nad miejscem obliczeń i dostępem. Lokalne połączenie Ollama nie ma wbudowanego sprawdzania logowania, dlatego chroniony pośrednik może weryfikować dostęp przed przekazaniem zapytania. Artykuł wyjaśnia taki układ prywatnej usługi AI oraz potrzebę zasad dostępu i przechowywania danych mimo posiadania własnego sprzętu.
Spis treści
Inferencja oznacza tutaj generowanie odpowiedzi przez model. Lokalny model językowy pozwala wykonywać to przetwarzanie na kontrolowanym sprzęcie. Samodzielny hosting nie gwarantuje jednak izolacji, zgodności z ochroną danych ani wydajności usługi chmurowej. Lokalne API Ollama nie ma wbudowanego uwierzytelniania. Odwrotny serwer proxy odbiera żądania kierowane do Ollama, sprawdza poświadczenia i obsługuje szyfrowane połączenie TLS; granice sieci, ruch wychodzący, przechowywanie i zachowanie aplikacji pozostają osobnymi zagadnieniami.
1. Określenie rzeczywistej granicy
Przykład udostępnia przez nginx wyłącznie minimalny endpoint generowania. Loopback oznacza własny lokalny adres sieciowy komputera, tutaj 127.0.0.1. Proxy nasłuchuje na adresie IPv4 loopback hosta Docker, a nie na wszystkich interfejsach sieciowych. Dostęp zdalny wymaga osobno zaplanowanego wejścia przez VPN lub sieć prywatną. Kontener Ollama nie publikuje portu. Host Docker i kontenery w tej samej sieci backendu nadal mogą docierać do Ollama bezpośrednio, dlatego obce aplikacje nie powinny należeć do tej sieci.
Zwykła sieć mostkowa Dockera pozwala na ruch wychodzący. Pobieranie modeli działa, lecz pełna izolacja od sieci nie występuje. OLLAMA_NO_CLOUD=1 wyłącza funkcje chmurowe Ollama w obsługujących wersjach; dodatkowo potrzebny jest wybór lokalnego modelu. Ustawienie nie blokuje zewnętrznych narzędzi, interfejsów internetowych ani ruchu hosta. Ścisły tryb offline wymaga kontrolowanego dostarczania modeli i niezależnego egzekwowania blokad ruchu wychodzącego.
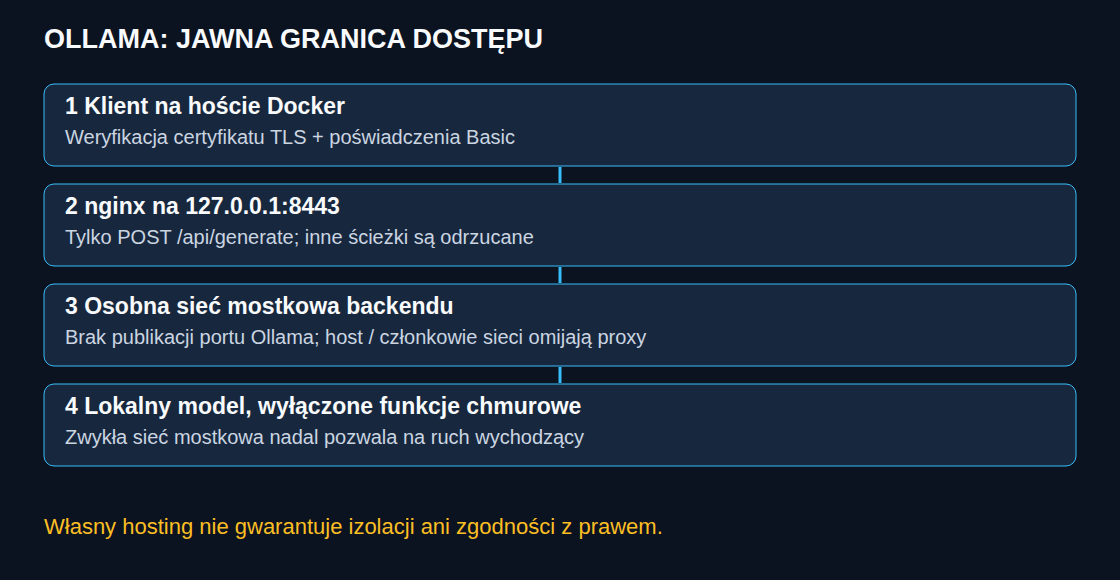
Przykład sieci zakłada aktualny Docker Engine w standardowym trybie mostkowym NAT. Dokumentacja Dockera opisuje dostęp sąsiednich hostów do portów loopback w wersjach starszych niż 28.0.0; własne ustawienia routingu bezpośredniego również wymagają osobnej oceny.
2. Przygotowanie kontenerów i certyfikatów
Poniższy compose.yaml to konfiguracja wyjściowa dla inferencji CPU, nie kompletne wdrożenie firmowe. OLLAMA_IMAGE i NGINX_IMAGE muszą zawierać sprawdzone referencje obrazów, najlepiej niezmienne skróty digest. Wybór modelu wymaga kontroli pamięci, długości kontekstu, licencji modelu i architektury sprzętu.
services:
  ollama:
    image: ${OLLAMA_IMAGE:?Set a reviewed Ollama image tag or digest}
    restart: unless-stopped
    environment:
      OLLAMA_HOST: 0.0.0.0:11434
      OLLAMA_NO_CLOUD: "1"
    volumes:
      - ollama_data:/root/.ollama
    networks:
      - llm_backend
  auth_proxy:
    image: ${NGINX_IMAGE:?Set a reviewed nginx image tag or digest}
    restart: unless-stopped
    ports:
      - "127.0.0.1:8443:443"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
      - ./certs:/etc/nginx/certs:ro
      - ./htpasswd:/etc/nginx/.htpasswd:ro
    depends_on:
      - ollama
    networks:
      - llm_backend
networks:
  llm_backend:
    driver: bridge
volumes:
  ollama_data:
Przed uruchomieniem muszą istnieć nginx.conf, plik haseł i certyfikaty. Certyfikat musi zawierać llm.example.internal jako Subject Alternative Name; klient potrzebuje certyfikatu wystawiającego urzędu CA. Polecenie htpasswd -cB ./htpasswd api_user interaktywnie tworzy nowy plik haseł bcrypt. Opcja -c nadpisuje istniejący plik, dlatego przy późniejszych zmianach kont należy pominąć tę opcję. Uprawnienia plików muszą umożliwiać odczyt przez nginx i ograniczać obcy dostęp; klucze prywatne wymagają odpowiedniej ochrony.
Akceleracja NVIDIA dodatkowo wymaga zgodnej karty, sterowników, NVIDIA Container Toolkit i rezerwacji GPU w usłudze Ollama. Sama kwantyzacja nie zmienia wykonania CPU w akcelerację GPU. depends_on ustala kolejność startu kontenerów, ale nie potwierdza gotowości modelu. Ponowne utworzenie backendu może też wymagać restartu proxy, ponieważ ta prosta konfiguracja rozwiązuje adres usługi przy starcie nginx.
3. Ograniczenie proxy do potrzebnej operacji
Ten nginx.conf dopuszcza wyłącznie uwierzytelnione żądania POST do /api/generate. Pozostałe ścieżki zwracają 404; inne metody na dozwolonej ścieżce są odrzucane. Zarządzanie modelami pozostaje poza współdzielonym API. Proxy usuwa poświadczenia Basic przed przekazaniem żądania.
events { worker_connections 1024; }
http {
    upstream ollama_backend { server ollama:11434; }
    server {
        listen 443 ssl;
        server_name llm.example.internal;
        ssl_certificate /etc/nginx/certs/server.crt;
        ssl_certificate_key /etc/nginx/certs/server.key;
        ssl_protocols TLSv1.2 TLSv1.3;
        client_max_body_size 1m;
        location = /api/generate {
            limit_except POST { deny all; }
            auth_basic "Local inference";
            auth_basic_user_file /etc/nginx/.htpasswd;
            proxy_pass http://ollama_backend;
            proxy_http_version 1.1;
            proxy_set_header Host ollama:11434;
            proxy_set_header Authorization "";
            proxy_set_header Connection "";
            proxy_buffering off;
            proxy_cache off;
            proxy_connect_timeout 5s;
            proxy_read_timeout 600s;
            proxy_send_timeout 60s;
        }
        location / { return 404; }
    }
}
Basic Auth uwierzytelnia konto usługi, nie indywidualne uprawnienia do dokumentów. Silne hasła, unieważnianie kont, limity żądań i równoległości oraz retencja logów nadal wymagają zasad eksploatacji. Limit żądania 1 MiB jest przykładowy i może być za mały dla obrazów. Przejęta uprawniona aplikacja nadal może wysyłać kosztowne żądania lub wybierać dostępne modele.
4. Test połączenia z weryfikacją certyfikatu
Po uruchomieniu usług polecenie docker compose exec ollama ollama pull llama3.1:8b może pobrać model. Identyfikator jest przykładem lokalnego modelu, nie rekomendacją sprzętową. Pull pobiera model; ollama run dodatkowo uruchamia sesję interaktywną. Poniższe żądanie curl działa na hoście Docker, pyta o hasło i weryfikuje certyfikat serwera przy użyciu wskazanego CA:
curl --cacert ./certs/ca.crt --resolve llm.example.internal:8443:127.0.0.1 --user api_user --header 'Content-Type: application/json' --data '{"model":"llama3.1:8b","prompt":"Return the word test.","stream":false}' https://llm.example.internal:8443/api/generatePrompt testowy nie zawiera danych firmowych. Polecenie podsumowania polityki nie udostępnia automatycznie brakującego dokumentu. Weryfikacja powinna objąć brakujące i błędne poświadczenia, poprawne żądanie, zablokowane ścieżki administracyjne, streaming, niedostępny backend i rzeczywistą ekspozycję portów. Kontrole składni, takie jak docker compose config i nginx -t, są warunkiem wstępnym, nie dowodem skutecznej granicy bezpieczeństwa.
Pytania i odpowiedzi
Czy Open WebUI lub klient zgodny z OpenAI zadziała bez zmian?
Nie. Minimalna brama udostępnia tylko natywny endpoint generowania. Interfejs internetowy wymaga dodatkowych sprawdzonych endpointów oraz drogi sieciowej do proxy bez bezpośredniego dostępu do backendu. Login i hasło w adresie URL nie stanowią uniwersalnej metody integracji i mogą trafić do konfiguracji lub logów. Klienci zgodni z OpenAI zwykle wysyłają uwierzytelnianie Bearer, a nginx Basic Auth oczekuje innego schematu. Integracja wymaga jawnego dostosowania uwierzytelniania lub bramy z odpowiednią kontrolą tokenów oraz potrzebnych ścieżek /v1/. Zgodność API obejmuje tylko część funkcji.
Czy 600 sekund ogranicza całą odpowiedź?
Nie. proxy_read_timeout ogranicza przerwę między odczytami z backendu. Fragmenty strumienia mogą wydłużać całkowity czas odpowiedzi ponad ten limit; wygenerowany token nie musi odpowiadać osobnemu odczytowi sieciowemu. Bez streamingu ładowanie modelu i generowanie mogą opóźniać pierwszą odpowiedź. Nawiązanie połączenia ma osobny limit pięciu sekund. Właściwe timeouty wymagają pomiaru przy planowanym obciążeniu.
Czy własny hosting gwarantuje ochronę danych?
Nie. Nadal istotne są uprawnienia, podstawa prawna, retencja, kopie zapasowe, logi aplikacji i integracje zewnętrzne. Lokalny backend nie odpowiada również pełnemu produktowi ChatGPT. Rezultatem jest określona usługa inferencji z możliwą do sprawdzenia drogą dostępu, nie gwarancja zgodności, jakości ani pełnej izolacji.
Powiązane artykuły