Porównywanie dwóch eksportów kontenera GTM: normalizacja przed diffem i czego nie pokazuje porównanie wierszami

Spis treści
Porównanie dwóch eksportów tej samej konfiguracji to najszybsza droga do ustalenia, co ktoś zmienił, a pierwsza próba niemal zawsze daje wynik bezużyteczny. To kilkaset różniących się wierszy, z których liczy się jeden, a reszta to format pliku rozmawiający sam ze sobą.
Wszystko, co następuje, dotyczy odstępu między tymi dwiema liczbami – czym jest wypełniony, jak znika i co pozostaje niewidoczne również potem.
Czym wypełniony jest ten odstęp
Eksporty są generowane, a generatory do niczego nie są zobowiązane. Ta sama konfiguracja wyeksportowana dwukrotnie może różnić się kolejnością kluczy obiektów, identyfikatorami nadawanymi przy eksporcie, odciskiem będącym znacznikiem czasu i tym, czy plik kończy się złamaniem wiersza. Nic z tego nie jest zmianą; wszystko z tego jest różnicą.
| Źródło szumu | Jak wygląda | Jak znika |
|---|---|---|
| Kolejność kluczy | całe bloki uchodzą za zmienione | jq -S . sortuje klucze rekurencyjnie |
| Odciski, znaczniki czasu | jeden zmieniony wiersz na obiekt | usunąć te pola przed porównaniem |
| Identyfikatory nadane przy eksporcie | każde odwołanie się różni | tak samo – albo porównywać po nazwach |
| Wcięcia | różni się wszystko | jq formatuje obie strony jednakowo |
| Zakończenia wierszy | różni się każdy wiersz i wygląda tak samo | dos2unix albo opcja narzędzia porównującego |
| Minifikacja | różni się jeden wiersz i nic nie mówi | sformatować od nowa, potem porównać |
Wiersz o zakończeniach wierszy kosztuje godzinę, bo oba wiersze wyglądają na ekranie dokładnie tak samo. Plik, który przeszedł przez edytor na Windowsie, różni się od źródła w każdym pojedynczym wierszu, a każda z tych różnic jest niewidoczna.
Najpierw normalizacja, potem porównanie
Zaradzeniem jest potok przetwarzania, a nie lepsze narzędzie porównujące. Oba pliki przechodzą przez tę samą normalizację, pola ulotne zostają usunięte i dopiero potem porównuje się wyniki – wtedy porównanie zawiera to, co się zmieniło, i nic poza tym.
norm() {
  jq -S 'walk(if type == "object"
              then del(.fingerprint, .accountId, .containerVersionId)
              else . end)' "$1"
}

diff <(norm stary.json) <(norm nowy.json)
walk schodzi do każdego obiektu, pola znikają więc wszędzie, gdzie występują, a nie tylko na najwyższym poziomie. -S sortuje klucze każdego obiektu i już samo to usuwa największe źródło szumu. Co przetrwa oba, jest zmianą, którą ktoś wprowadził.
Trzy poziomy, trzy różne odpowiedzi
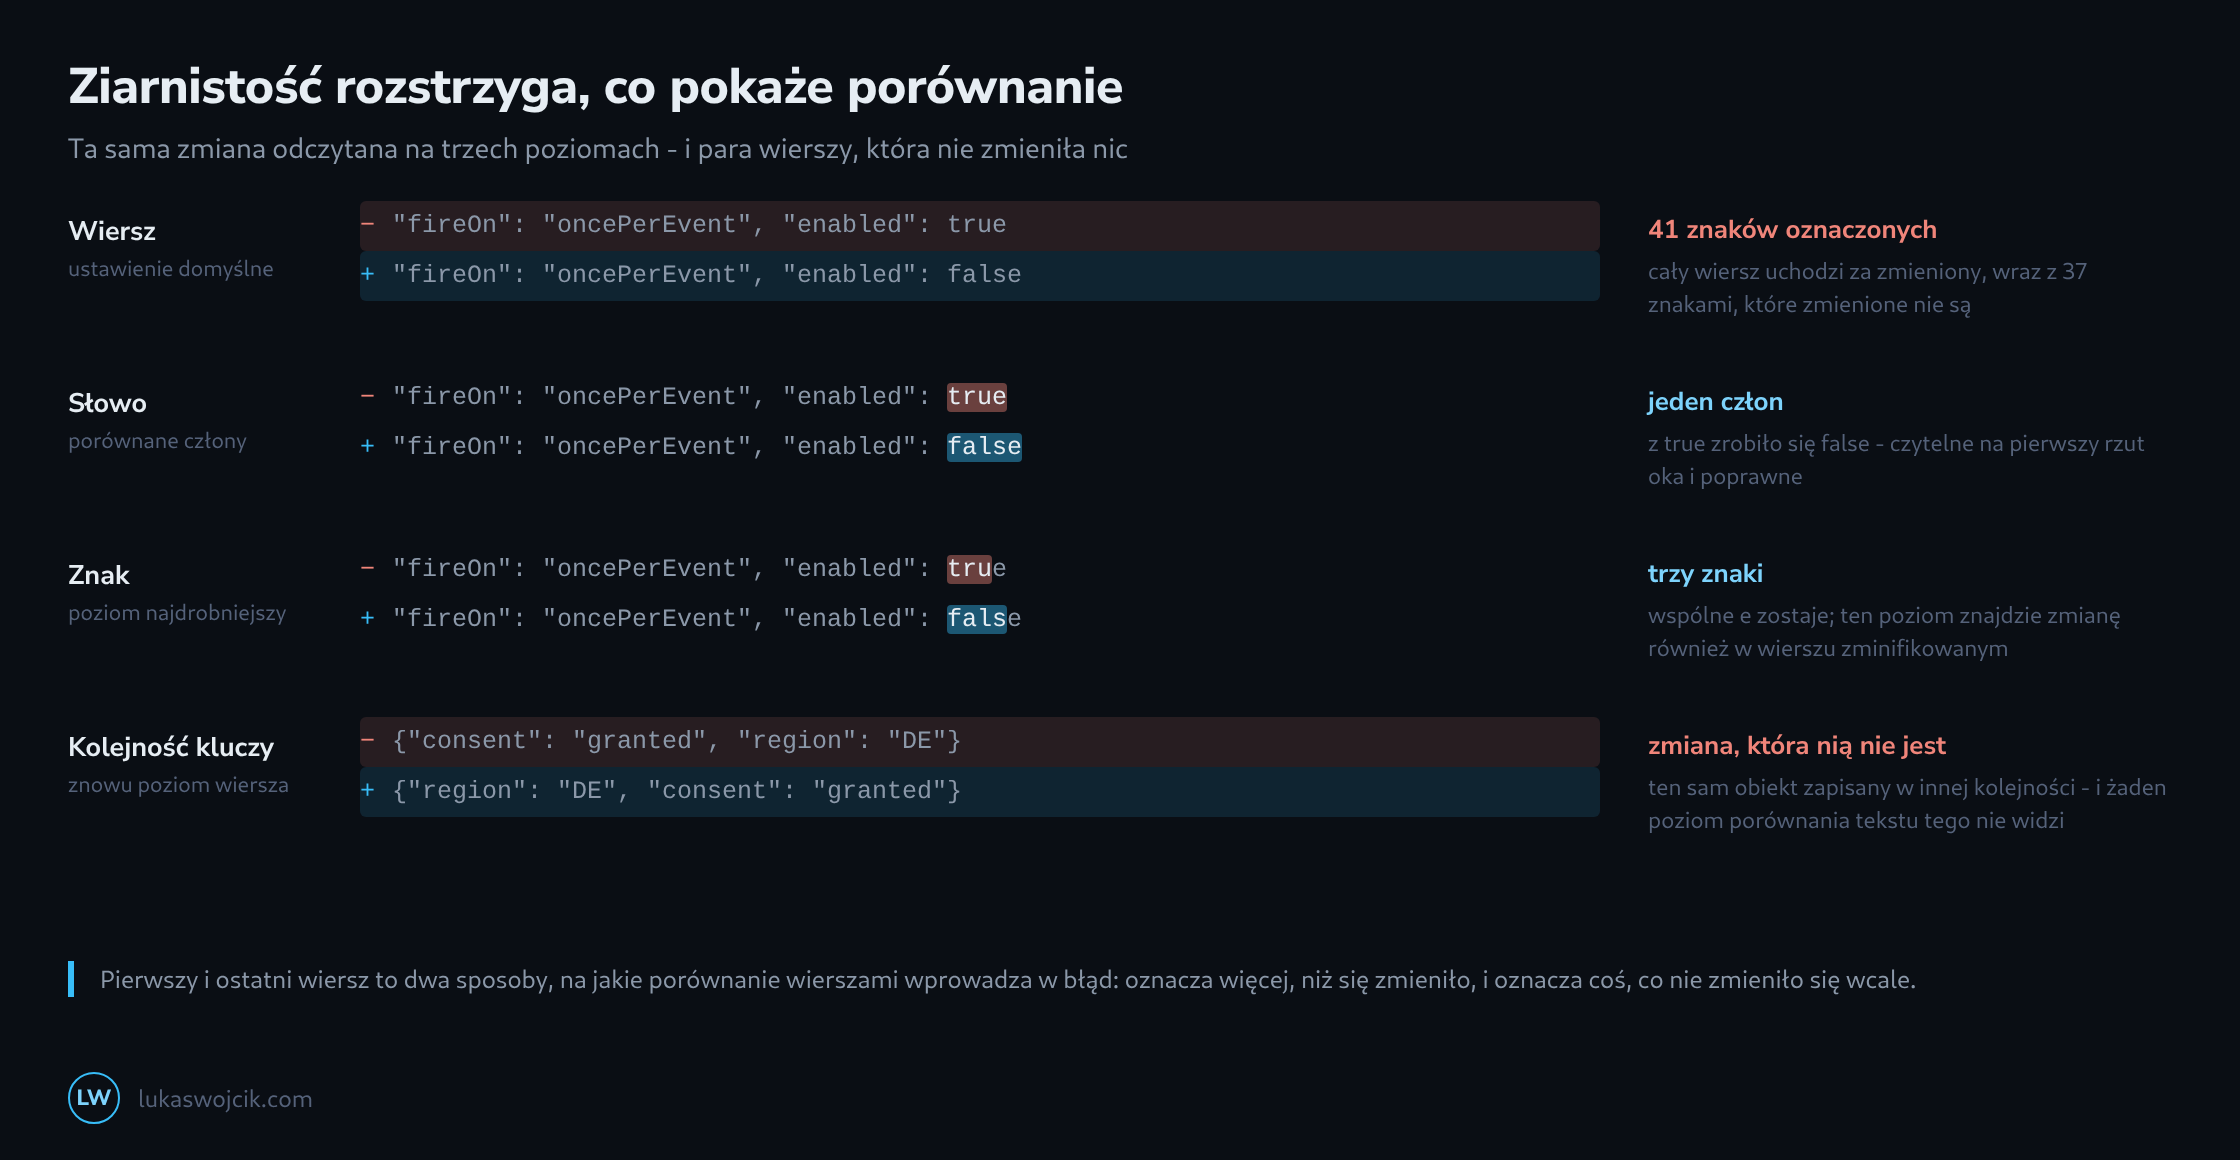
Wiersz, słowo i znak to nie klasy jakości, tylko różne pytania. Porównanie wierszami odpowiada, które wiersze nie są identyczne, a to pytanie właściwe dla kodu źródłowego, gdzie wiersz to mniej więcej jedna instrukcja. Jest pytaniem niewłaściwym dla pliku JSON z jednym obiektem na wiersz i całkiem bezużytecznym dla zminifikowanego, w którym cały dokument jest jednym wierszem.
Poziom słowa porównuje człony i czyni zmianę jednej wartości czytelną. Poziom znaku jest drobniejszy, niż do czytania potrzeba, i jest dokładnie tym, czego trzeba, gdy wiersz jest długi: w zminifikowanym eksporcie kontenera tylko porównanie znakami wskaże ten jeden przewrócony znacznik logiczny.
Czego nie pokaże żaden poziom
Porównanie tekstu widzi tekst. Trzy rodzaje zmian pozostają przez to niewidoczne, bez względu na drobiazgowość rozdzielczości. Przeniesiony blok pojawia się jako usunięcie w jednym miejscu i dodanie w drugim, bez niczego, co by je łączyło. Przemianowana zmienna występująca w dwunastu miejscach pojawia się jako dwanaście osobnych zmian zamiast jednego zamiaru. A wartość, która zmieniła typ, nie zmieniając wyglądu – z "1" na 1 – jest różnicą dwóch znaków o skutkach, których żadne wyróżnienie nie przekaże.
Przypadek odwrotny stoi w czwartym wierszu diagramu: dwa pliki różniące się w każdym wierszu i opisujące ten sam obiekt. Porównanie tekstu potrafi odpowiadać wyłącznie na pytania o tekst – a pytanie faktycznie zadawane, czy konfiguracja się zmieniła, jest pytaniem o strukturę.
Co porównywać zamiast tego, gdy zależy na odpowiedzi
Przy wszystkim, co ma schemat, uczciwym porównaniem jest to między rozłożonymi obiektami, a nie między plikami. jq potrafi to wprost: dwa dokumenty są równe albo nie są, a odpowiedzią jest pojedyncza wartość logiczna, której nie dotyka formatowanie, kolejność ani biały znak.
# czy to w ogóle ten sam obiekt?
jq -e --slurpfile b nowy.json '. == $b[0]' stary.json >/dev/null && echo "identyczne"

# które klucze najwyższego poziomu się różnią?
jq -n --slurpfile a stary.json --slurpfile b nowy.json \
  '($a[0] | keys) as $ka | ($b[0] | keys) as $kb
   | { tylko_stary: ($ka - $kb), tylko_nowy: ($kb - $ka) }'
Porównaniu wierszami zostaje przez to zadanie, w którym jest dobre: pokazać człowiekowi, co zrobił ktoś inny, w postaci czytającej się jak plik, który będzie edytował. Bardzo dobrze odpowiada, na co spojrzeć, i wcale nie odpowiada, czy coś jest tym samym – a większość irytacji nim bierze się z zadawania mu tego drugiego pytania.
Powiązane artykuły