English
 Deutsch
 Polski
Tutorial: Znalezienie wersji kontenera, w której zmienił się tag

Spis treści
Liczba w raporcie zmienia się we wtorek. Kontener opublikowano w tym miesiącu cztery razy, a lista wersji mówi, kto to zrobił i kiedy – i zupełnie nic o tym, co poruszyło się w środku.
Otworzyć i przeczytać cztery wersje da się. Czterdziestu już nie, a czterdzieści to liczba zwyczajowa w chwili, gdy ktoś to zauważy. Poniżej droga, która najpierw znajduje wersję, a dopiero potem porównuje dwie.
Co pokazuje lista wersji, a co ukrywa
Każda publikacja tworzy wersję, a ta wersja jest pełną, niezmienną kopią kontenera z tamtej chwili. Lista tych wersji pokazuje cztery rzeczy: numer, nazwę, kto opublikował i kiedy.
Nie pokazuje zawartości. Dwie wersje mogą różnić się jednym znakiem w jednej zmiennej, a lista i tak wygląda tak samo. Liczba zmian obok wersji pomaga trochę, a myli wiele, bo liczy zmiany w obszarze roboczym, a nie różnicę wobec wersji poprzedniej – obszar roboczy, w którym coś zmieniono i cofnięto, podnosi tę liczbę, niczego nie zmieniając.
Jedynym polem, które odpowiedziałoby na pytanie wprost, są notatki wersji. To dowolny tekst, pisany przy publikacji, i w niemal każdym istniejącym kontenerze pusty. Wypełnianie go jest najtańszą możliwą poprawą całego tego problemu – i pomaga dopiero od teraz.
Pobranie wersji przez API
API Tag Managera zwraca te same wersje, które pokazuje interfejs, oraz pełną zawartość każdej z nich. Wystarczy dostęp do odczytu.
# Zakres: https://www.googleapis.com/auth/tagmanager.readonly

BASIS="https://tagmanager.googleapis.com/tagmanager/v2"
PFAD="accounts/6000000001/containers/7000000002"

# 1 lista wersji - krotka, bez zawartosci
curl -s -H "Authorization: Bearer $TOKEN" \
  "$BASIS/$PFAD/version_headers" | jq -r \
  '.containerVersionHeader[] | [.containerVersionId, .name] | @tsv'

# 2 jedna pelna wersja
curl -s -H "Authorization: Bearer $TOKEN" \
  "$BASIS/$PFAD/versions/41" > version-41.json
Dwie rzeczy o pierwszym wywołaniu warto wiedzieć. Zwraca nagłówki zamiast zawartości, co czyni je tanim i jest właściwą drogą do wyliczenia. I jest stronicowane: kontener z wieloma wersjami zwraca nextPageToken, a skrypt go pomijający po cichu pracuje wyłącznie z najnowszą stroną.
Drugie wywołanie jest tym drogim, bo zwraca cały kontener. To powód istnienia następnego rozdziału: pobranie czterdziestu pełnych wersji, by porównać jeden tag, to dużo danych na jedno pytanie.
Suma kontrolna wskazująca zmianę
Każdy element kontenera niesie pole fingerprint, a zmienia się ono, gdy tylko element zostanie zmodyfikowany. Porównanie sumy kontrolnej jednego tagu w kolejnych wersjach odpowiada więc na pytanie bez porównywania czegokolwiek innego.
import json, glob

GESUCHT = "25"   # tagId: GA4 - Event - purchase

vorher = None
for datei in sorted(glob.glob("version-*.json"),
                    key=lambda d: int(d.split("-")[1].split(".")[0])):
    daten = json.load(open(datei))
    tags  = {t["tagId"]: t for t in daten.get("tag", [])}
    tag   = tags.get(GESUCHT)

    if tag is None:
        print(f"{datei:16s} nie istnieje")
    else:
        marke = tag["fingerprint"]
        hinweis = "ZMIENIONY" if vorher and marke != vorher else ""
        print(f"{datei:16s} {marke}  {hinweis}")
        vorher = marke
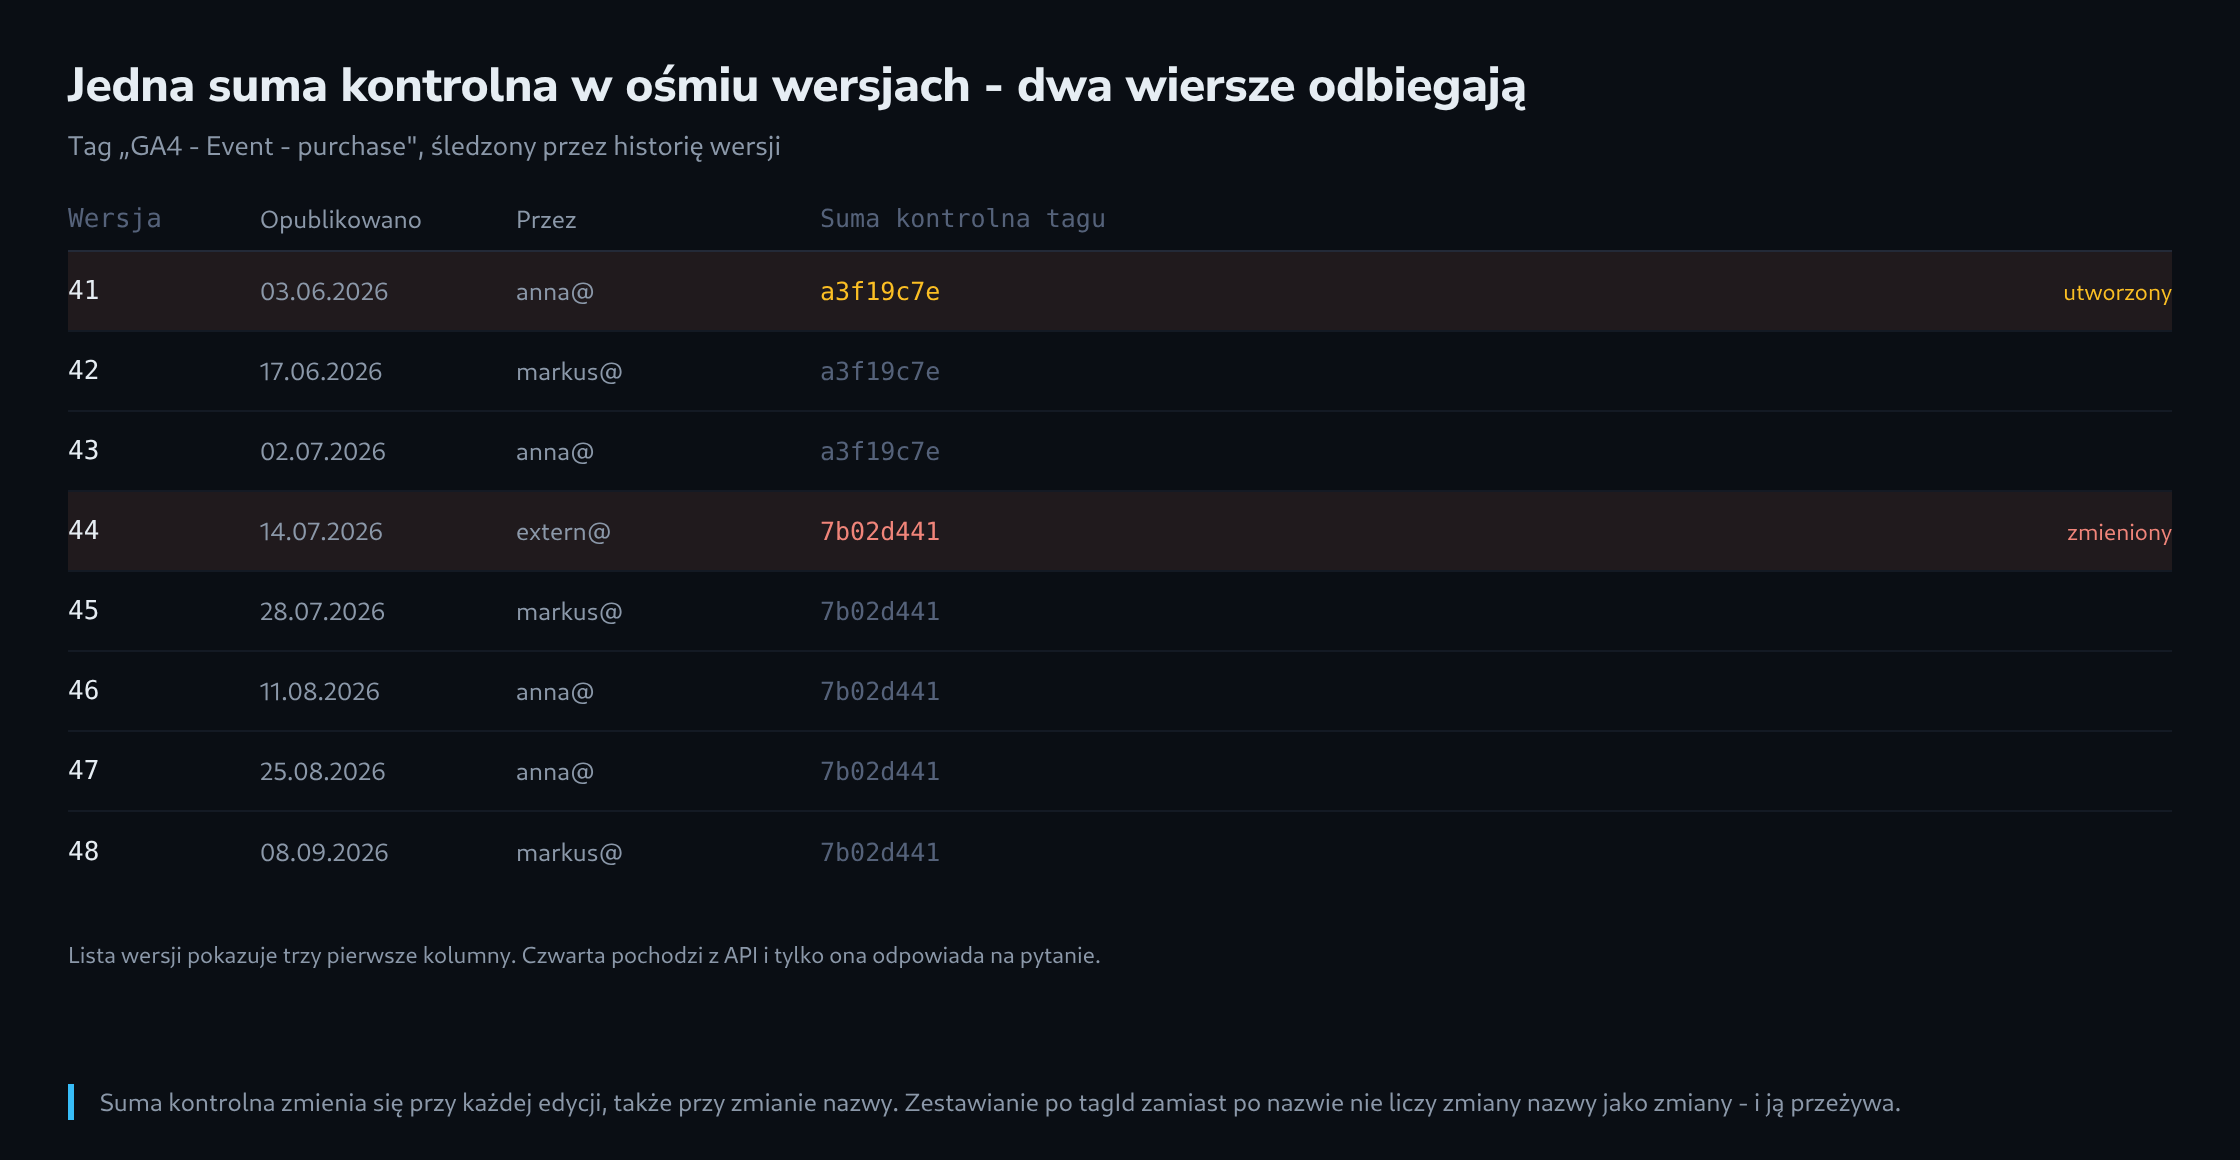
Wynikiem jest jedna linia na wersję, a te ciekawe zgłaszają się same. Tag nietknięty przez trzydzieści wersji, a potem raz zmieniony, daje dokładnie jeden oznaczony wiersz – i ten wiersz jest odpowiedzią.
Dwie właściwości sumy kontrolnej zasługują na uwagę. Jest nieprzejrzysta – mówi, że coś się zmieniło, a nie co – i do tego kroku to wystarcza. I zmienia się przy każdej edycji, łącznie ze zmianą nazwy: przemianowany tag pojawia się jako zmieniony, choć zachowuje się tak samo. Zestawianie po tagId zamiast po nazwie tego nie zmienia, ale przeżywa tę zmianę nazwy, która w ogóle utrudniła odnalezienie elementu.
Znaleźć wersję, potem porównać dwie
Gdy wersja jest znana, porównanie odbywa się między dwoma plikami, a nie czterdziestoma – i opłaca się na kopii ujednoliconej, a nie na surowym eksporcie.
# tylko szukany tag z obu wersji, posortowany
for v in 43 44; do
  jq -S --arg n "GA4 - Event - purchase" \
    '.tag[] | select(.name == $n)' version-$v.json > tag-$v.json
done

diff -u tag-43.json tag-44.json
To -S czyni wynik czytelnym. Bez niego klucze JSON wracają w kolejności wytworzonej przez API, a porównanie dwóch obiektów o tym samym znaczeniu potrafi mieć kilkadziesiąt linii. Posortowanie kluczy usuwa to całkowicie, a zostaje właściwa zmiana.
Trzy pola warto w porównaniu pominąć, bo zmieniają się same z siebie: fingerprint, służący tutaj do znalezienia wersji, a nie do jej opisu, oraz każde pole znacznika czasu albo ścieżki niosące numer wersji. Wszystko inne, co się różni, jest różnicą prawdziwą.
Przydział zapytań i kopia lokalna
API Tag Managera ma ograniczenia na minutę i na dobę, a pętla po czterdziestu pełnych wersjach szybko na nie wpada. Niepowodzeniem jest odpowiedź 429, a skrypt bez przerwy zamienia jedno badanie w API zablokowane do końca godziny.
for v in $(cat versionen.txt); do
  [ -f "version-$v.json" ] && continue          # juz jest
  curl -s -H "Authorization: Bearer $TOKEN" \
    "$BASIS/$PFAD/versions/$v" > "version-$v.json"
  sleep 2
done
Pominięcie istniejącego pliku to ważna linia. Wersje są niezmienne, więc raz pobranej wersji nigdy nie trzeba pobierać ponownie – a katalog z nimi staje się archiwum odpowiadającym na następne pytanie bez dotykania API w ogóle.
To archiwum warto zakładać celowo, a nie ubocznie. Cotygodniowe zadanie pobierające najnowsze wersje nic nie kosztuje – a dzięki temu historia jest dostępna także dla kontenera, do którego ktoś później traci dostęp.
Pytanie, na które API nie odpowiada
Trzy rzeczy pozostają poza zasięgiem, a wiedza o tym, które to, oszczędza długiego szukania czegoś, czego nie ma.
Pierwszą jest to, kto zmienił określony element. Wersja zapisuje, kto ją opublikował, a publikacja może zawierać pracę kilku osób z kilku tygodni. Autorstwa na poziomie elementu API nie ma, a interfejs również nie.
Drugą jest wszystko, co nigdy nie stało się wersją. Zmiana wprowadzona w obszarze roboczym i cofnięta przed publikacją nie zostawia śladu, podobnie jak skasowany obszar roboczy. Historia jest historią publikacji, a nie edycji.
Trzecią jest skutek. Dwie wersje mogą różnić się warunkiem wyzwalania spełniającym się o dziesięć procent częściej, a nic w kontenerze tego nie mówi – różnicą jest jedna linia konfiguracji, a jej następstwo stoi w danych. Dlatego cała ta procedura jest pierwszą połową badania: daje chwilę i zmianę, a drugą połową jest sprawdzenie, czy liczby również poruszyły się w tej chwili.
Pytania i odpowiedzi
Czy porównanie sumy kontrolnej wykrywa także zmianę triggera albo zmiennej, z których korzysta tag?
Nie, i to jest najważniejsza luka tej procedury. Pole fingerprint tagu zmienia się tylko wtedy, gdy edytowany jest sam tag. Tag odwołuje się do swoich triggerów przez ich identyfikatory, a do zmiennych przez ich nazwy w podwójnych nawiasach klamrowych. Jeśli ktoś zmieni warunek wyzwalania triggera albo wartość zmiennej, tag pozostaje identyczny znak po znaku, a wraz z nim jego suma kontrolna, choć zachowuje się już inaczej.
Pętlę z artykułu da się więc rozszerzyć na zależności: z tagu odczytuje się identyfikatory w firingTriggerId i blockingTriggerId oraz zbiera nazwy wszystkich odwołań {{…}}, a następnie porównuje sumy kontrolne tych triggerów w daten["trigger"] i tych zmiennych w daten["variable"] w kolejnych wersjach tak samo jak sumę tagu.
Nawet to nie wystarcza w pełni, bo zmienne mogą odwoływać się do innych zmiennych. Dokładną drogą jest śledzenie odwołań, dopóki nie przestaną pojawiać się nowe; prostszą jest porównanie od razu sum kontrolnych wszystkich elementów kontenera przy szukaniu wersji.
Co się dzieje, gdy pobranie w pętli kończy się odpowiedzią 429?
Plik i tak powstaje. Bez dodatkowych opcji curl -s zapisuje do wyjścia także odpowiedź z błędem, więc version-44.json zawiera wtedy komunikat błędu API w formacie JSON zamiast kontenera. Przy następnym przebiegu plik uchodzi za istniejący i zostaje pominięty, a więc właśnie linia, która czyni archiwum wartościowym, utrwala błąd.
Skrypt analizujący tego nie zgłasza, lecz wprowadza w błąd: daten.get("tag", []) zwraca dla komunikatu błędu pustą listę, a wersja pojawia się jako „nie istnieje”, jakby tag został w niej usunięty.
Samo dodanie -f nie wystarczy, bo przekierowanie > tworzy plik, zanim curl odpowie; zostałby wtedy pusty plik, pominięty tak samo. Pewną drogą jest plik tymczasowy, któremu nadaje się docelową nazwę dopiero wtedy, gdy curl zakończył się powodzeniem, a jq -e .containerVersionId znajduje wartość.
Czy wersja, w której zmienił się tag, jest też tą, która działała w danym dniu?
Niekoniecznie. Każda publikacja tworzy wersję, ale nie każda wersja zostaje opublikowana: wersję da się utworzyć bez uruchamiania jej na stronie, a starszą wersję da się później opublikować ponownie, na przykład żeby cofnąć zmianę. Numer wersji oddaje więc kolejność powstania, a nie kolejność publikacji.
Przy zestawieniu z raportem liczy się to, kiedy która wersja zaczęła działać. Jeśli porównanie znajduje zmianę w wersji 44, trzeba ustalić, czy i kiedy wersja 44 została opublikowana i czy potem nie obowiązywała znów starsza wersja.
Jakich uprawnień potrzebuje cotygodniowe zadanie archiwizujące?
Wystarczy dostęp do odczytu, jak podaje artykuł, z zakresem tagmanager.readonly. Jeśli zadanie działa na koncie usługi, jego adres e-mail musi zostać dodany w Tag Managerze jako użytkownik z uprawnieniem do odczytu konta albo kontenera; sam zakres nie daje dostępu. Z samym prawem odczytu zadanie nie może niczego opublikować, a utracony klucz ujawnia wtedy zawartość kontenera, ale nie pozwala jej zmienić.
Źródła
Powiązane artykuły