English
 Deutsch
 Polski
Hashowanie w Conversions API: normalizacja danych klienta przed SHA-256 i które pola pozostają niezahashowane

Spis treści
Zdarzenie Conversions API z zahaszowanym adresem e-mail wygląda tak samo, czy zahaszowano dobrze, czy źle. Ładunek jest poprawny, interfejs odpowiada powodzeniem, licznik zdarzeń rośnie, a jakość dopasowania zostaje tam, gdzie była – bo adres, poprawnie zahaszowany do napisu, któremu nic nie odpowiada, porównano z bazą klientów i nie znaleziono w żadnej.
To rodzaj porażki, który warto zrozumieć przed całą instalacją: haszowanie nie zawodzi głośno, zawodzi, wytwarzając coś technicznie nienagannego i treściowo pustego.
Dlaczego mała różnica jest różnicą całkowitą
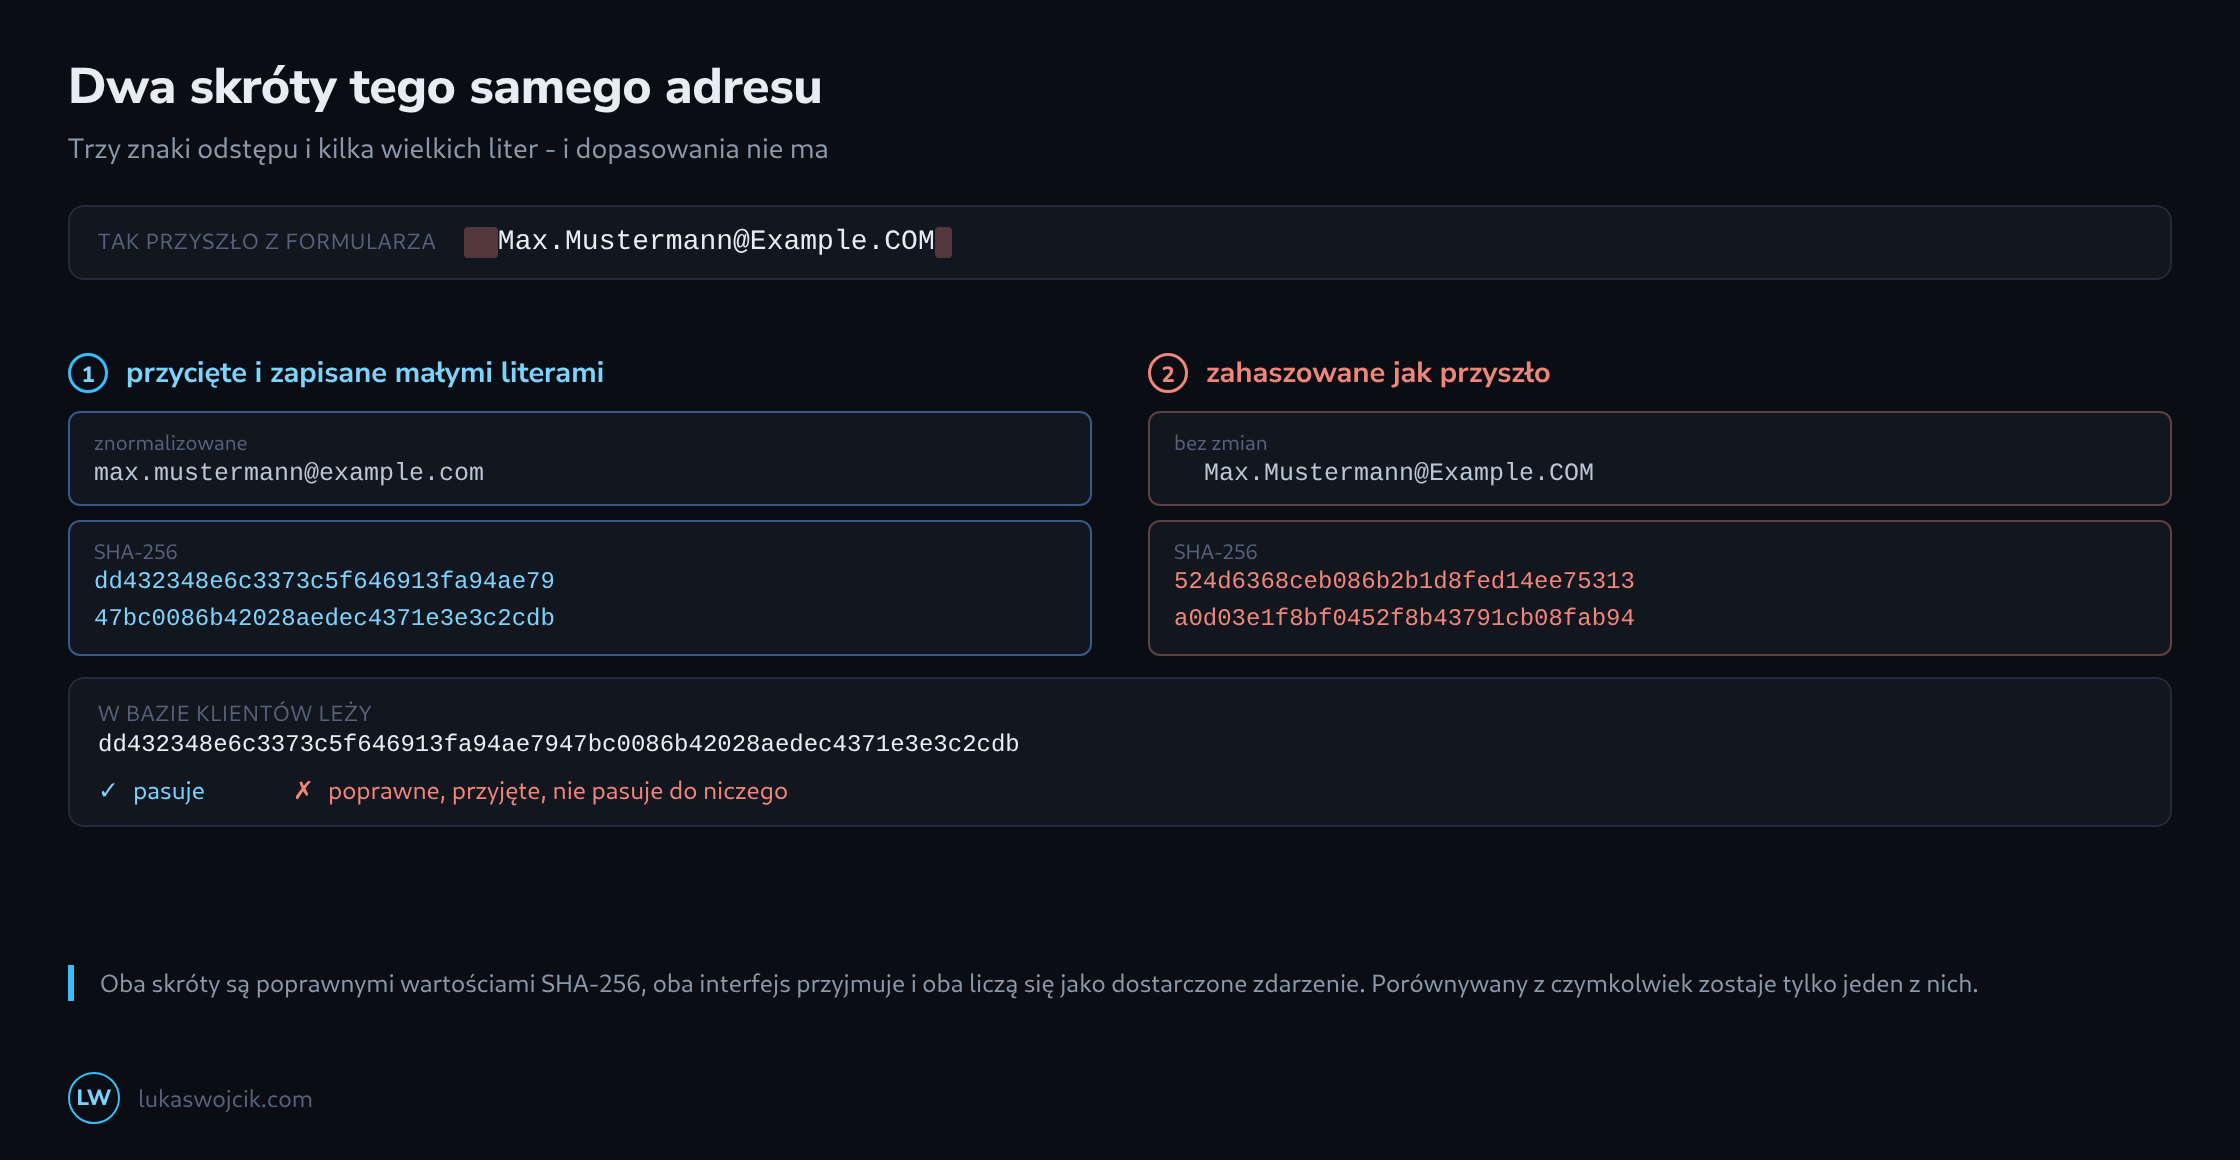
Funkcja skrótu jest zbudowana tak, by drobna zmiana wejścia dawała wyjście różne nie do poznania. Ta własność czyni haszowanie użytecznym i dokładnie ona czyni błąd normalizacji śmiertelnym: prawie-dopasowanie nie istnieje. Dwa skróty są równe albo nie mają ze sobą nic wspólnego, a żadne, choćby najbardziej rozmyte, dopasowanie dalej w potoku tej różnicy nie odzyska.
O tym, czy zdarzenie znajdzie osobę, rozstrzyga się więc, zanim funkcja skrótu w ogóle zostanie wywołana – w tych kilku wierszach, które ustalają, co dokładnie do niej trafia.
Postać, w jakiej musi stać każdy parametr
| Parametr | Wymagana postać | Co idzie źle |
|---|---|---|
em |
przycięte, małe litery | wielka litera z formularza, spacja ze schowka |
ph |
same cyfry, z numerem kraju | krajowe zero w +48 (0)601 przeżywa |
fn, ln |
małe litery, bez znaków i odstępów | łącznik w nazwisku dwuczłonowym |
ct |
małe litery, bez spacji | Nowy Sącz zachowuje spację |
st, country |
dwuliterowy kod, małe litery | kraj stoi rozpisany |
ge |
dokładnie f albo m |
cokolwiek innego, zahaszowane jakby było wartością |
db |
RRRRMMDD | lokalny format daty, bezgłośnie przestawiony |
Numer telefonu zasługuje na osobną uwagę, bo to jedyny przypadek, którego nie da się znormalizować maszynowo. Usunięcie z +48 (0)601 234567 wszystkiego poza cyframi daje 480601234567, a zero po numerze kierunkowym kraju jest krajową cyfrą wyjścia, której w numerze międzynarodowym być nie powinno. Żadna reguła nie rozstrzygnie tego niezawodnie dla każdego kraju, dlatego uczciwym postępowaniem jest usunąć i zgłosić podejrzany wzorzec człowiekowi, zamiast zgadywać.
Parametry, których haszować nie wolno
Błąd odwrotny jest rzadszy i równie ostateczny. client_ip_address, client_user_agent, fbp i fbc wysyła się jawnie. Nie są identyfikatorami w tym sensie, w jakim są nimi pola haszowane; są wartościami, które Meta zestawia z własnymi zapisami, a zahaszowana z nich to napis, któremu po drugiej stronie nic nie odpowiada.
Najczęściej dzieje się to wtedy, gdy pomocnicza funkcja haszująca zostaje zastosowana do całego obiektu danych użytkownika naraz – rozsądnie wyglądający kawałek kodu, błędny w dokładnie czterech polach. Funkcja haszująca po nazwach pól, a nie po obiekcie, to ta wersja, która przetrwa zmianę schematu.
Jak to wygląda z zewnątrz
# ten sam adres, trzy drogi
"  Max.Mustermann@Example.COM "   → 524d6368ceb086b2b1d8fed14ee75313…
"  max.mustermann@example.com "   → de4c5edc5348280eedb5b029d7851764…
"max.mustermann@example.com"      → dd432348e6c3373c5f646913fa94ae79…

# porównywany z czymkolwiek zostaje tylko trzeci
Żaden z nich nie daje błędu. Liczba zdarzeń w menedżerze zdarzeń jest we wszystkich trzech przypadkach ta sama, dostarczenie zostaje potwierdzone we wszystkich trzech, a jedyną wielkością, która się rusza, jest jakość dopasowania – w dół, powoli i w sposób, który wygodnie przypisać porze roku albo zmianie w zgodach.
Użyteczną kontrolą nie jest więc odpowiedź interfejsu, tylko porównanie ze znaną wartością. Wziąć jeden adres z bazy klientów, zahaszować go tak, jak robi to sklep, zahaszować tak, jak każe specyfikacja, i porównać oba napisy. Zgadzają się albo potok ma błąd normalizacji – a odpowiedź zajmuje minutę.
Gdzie należy normalizacja
Ostatnia decyzja dotyczy budowy. Normalizować da się w przeglądarce, w kontenerze serwerowym albo w systemie prowadzącym rekord klienta – i tylko ten ostatni ma pierwotną wartość w tej postaci, w jakiej trzyma ją baza klientów.
Robienie tego w kontenerze serwerowym to zwykła droga pośrednia i sprawdza się, o ile kontener dostaje wartość surową, a nie coś, co formularz już obrobił. Robienie tego w przeglądarce to jedyny układ, którego należy unikać: kładzie adres jawnie w żądaniu opuszczającym urządzenie odwiedzającego – dokładnie to, czemu haszowanie miało zapobiec.
Pytania i odpowiedzi
Czy haszowanie czyni dane klientów anonimowymi w rozumieniu przepisów o ochronie danych?
Nie. Skrót, który Meta może zestawić z własną bazą klientów, stanowi dane spseudonimizowane, a nie anonimowe, a takie dane pozostają według RODO danymi osobowymi; powiązanie wartości z osobą jest tu wręcz celem. Haszowanie zapobiega przesłaniu adresu jawnie, ale nie zastępuje ani podstawy prawnej, ani zgody.
Co się dzieje, gdy wartość zostaje zahaszowana dwukrotnie w drodze do Meta?
To samo co przy błędzie normalizacji: ładunek jest poprawny, interfejs zgłasza powodzenie, ale żadna osoba nie zostaje odnaleziona. Skrót ze skrótu to znowu napis z 64 znaków szesnastkowych, wygląda więc jak poprawny, a mimo to nie odpowiada mu żaden wpis po drugiej stronie.
Sytuacja ta powstaje tam, gdzie dwa etapy, każdy z osobna, postępują rozsądnie. System sklepu przekazuje adres do kontenera serwerowego już zahaszowany, a tag w kontenerze haszuje ponownie każde pole danych użytkownika. Żaden z etapów nie jest sam w sobie błędny, błędny jest dopiero łańcuch.
Typowym zabezpieczeniem jest kontrola przed haszowaniem: jeśli wartość składa się już z dokładnie 64 znaków z zakresu 0–9 i a–f, zostaje przekazana dalej, a nie haszowana ponownie. Adres e-mail nigdy nie spełnia tego wzorca, bo zawiera @, a numer telefonu też nie, bo E.164 dopuszcza najwyżej 15 cyfr. Resztę wychwytuje opisane w artykule porównanie ze znaną wartością, o ile obejmuje koniec łańcucha, czyli ładunek faktycznie wysyłany do Meta, a nie etap pośredni.
Jak traktować kod pocztowy i external_id, których brakuje w tabeli?
Kod pocztowy (zp) jest haszowany, a przedtem zapisywany małymi literami, bez spacji i bez łącznika: z 00-950 powstaje 00950, a z niderlandzkiego 1012 AB powstaje 1012ab. Dla Stanów Zjednoczonych Meta wymaga tylko pierwszych pięciu cyfr.
external_id to własny identyfikator sklepu, na przykład numer klienta. Meta zaleca jego haszowanie, ale go nie wymaga. Decyduje spójność: jeśli identyfikator jest wysyłany także przez piksel, musi docierać obiema drogami w tej samej postaci, zahaszowany lub nie, bo inaczej dla Meta są to dwa różne identyfikatory.
Źródła
Powiązane artykuły