English
 Deutsch
 Polski
Tutorial: Eine Docker-Compose-Datei für den unbeaufsichtigten Betrieb auf dem Raspberry Pi härten

Inhalt
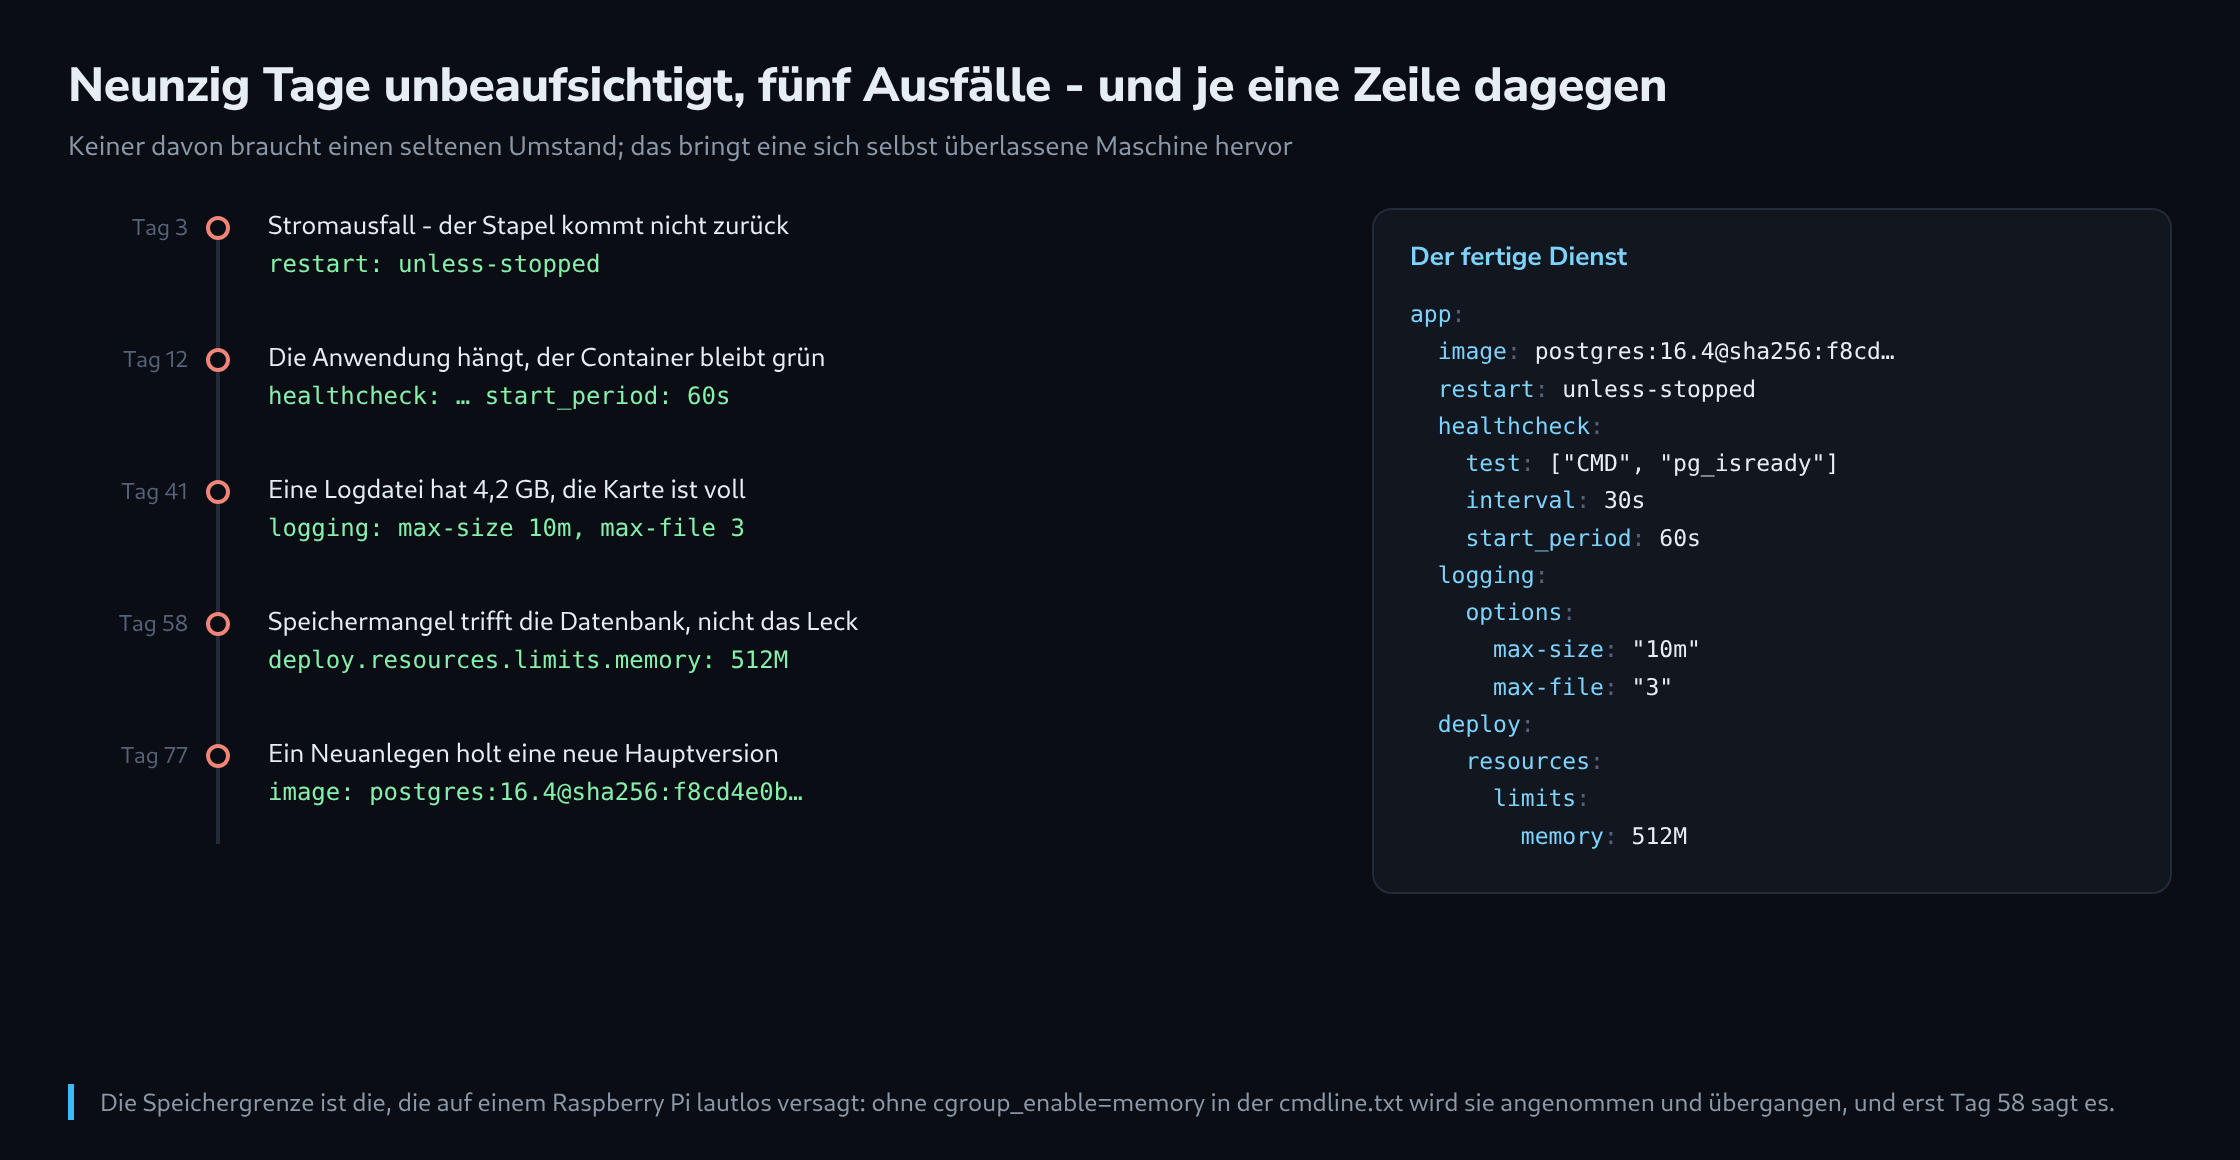
Eine Compose-Datei, die einen Stapel startet, ist in zehn Minuten geschrieben. Eine Compose-Datei, die den Stapel ein Jahr am Laufen hält, braucht etwa sechs Zeilen mehr je Dienst – und jede dieser Zeilen existiert wegen einer bestimmten Art, auf die Dinge umfallen.
Es folgt der Durchgang in der Reihenfolge, in der sie üblicherweise nötig werden – was ungefähr der Reihenfolge entspricht, in der eine sich selbst überlassene Maschine darauf stößt.
Die Zeile, die über die Rückkehr entscheidet
Ein Container, der stehen bleibt, bleibt stehen. Nach einem Stromausfall, nach einem Absturz, nach einem Neustart des Dienstes – solange keine Neustartregel etwas anderes sagt.
services:
  app:
    restart: unless-stopped
Drei Werte lohnen sich auseinanderzuhalten. no ist die Voreinstellung und heißt, dass nichts zurückkommt. always startet den Container in jedem Fall neu, auch nachdem er von Hand angehalten wurde und die Maschine danach neu startete – so erscheint ein absichtlich außer Betrieb genommener Container um drei Uhr nachts wieder. unless-stopped tut dasselbe außer in genau diesem Fall und ist die richtige Voreinstellung für eine Maschine, die niemand beobachtet.
Zwei Einzelheiten dahinter. Docker wartet zwischen Neustartversuchen zunehmend länger, von 100 Millisekunden verdoppelnd bis zu einer Minute – ein Container in einer Absturzschleife legt die Maschine also nicht lahm, hört aber auch nicht auf, und nichts weist darauf hin. Und die Neustartregel greift nur bei einem Container, der sich beendet. Ein Prozess, der hängt, während sein Container weiterläuft, ist genau der Fall des nächsten Abschnitts.
Eine Gesundheitsprüfung, die etwas prüft
Eine hängende Anwendung ist schlimmer als eine abgestürzte, denn alles ringsum hält sie für funktionierend. Der Container läuft, der Port ist offen, und die Anfragen laufen ins Leere.
    healthcheck:
      test: ["CMD", "curl", "-fsS", "http://localhost:8080/health"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 60s
Die letzte Zeile fehlt am häufigsten und stiftet die meiste Verwirrung. Während der start_period zählt eine fehlgeschlagene Prüfung nicht gegen retries. Ohne sie wird ein Dienst, der länger als drei Prüfintervalle, hier rund 90 Sekunden, zum Hochkommen braucht, unterwegs für krank erklärt, und Dienste, die per condition: service_healthy auf ihn warten, starten nicht. Neu gestartet wird ein kranker Container dabei nicht: Ohne Swarm ändert der Befund nur seinen Status, die Neustartregel greift weiterhin erst, wenn der Container sich beendet.
Was die Prüfung prüft, wiegt schwerer als dass es sie gibt. Eine Anfrage auf / belegt, dass der Webserver antwortet, und das tut er auch, während die Datenbankverbindung dahinter seit einer Stunde weg ist. Ein Endpunkt, der die ausfallgefährdeten Teile berührt, lohnt sich genau dafür zu schreiben – und er sollte schnell antworten, denn er läuft alle dreißig Sekunden, so lange die Maschine steht.
Eine Gesundheitsprüfung ermöglicht außerdem eine Aussage über die Reihenfolge, die depends_on allein nicht trifft. Ohne die Bedingung startet Compose die Abhängigkeit und macht sofort weiter; mit ihr wartet es.
  app:
    depends_on:
      db:
        condition: service_healthy
Eine Folge für schlanke Abbilder: curl ist oft nicht enthalten, und eine Prüfung, die sich nicht ausführen lässt, gilt als fehlgeschlagen. Entweder benutzt die Prüfung etwas, das im Abbild vorhanden ist – wget -q --spider oder einen Befehl der Anwendung selbst -, oder das Abbild bekommt ein Paket, das es sonst nicht bräuchte.
Protokolle, die die Karte nicht füllen
Der voreingestellte Protokolltreiber schreibt in eine JSON-Datei, die unbegrenzt wächst. Auf einem Server mit großer Platte ist das unordentlich; auf einem Pi mit Speicherkarte ist es ein Ausfallgrund, denn ein volles Dateisystem legt die ganze Maschine still statt nur des geschwätzigen Containers.
    logging:
      driver: json-file
      options:
        max-size: "10m"
        max-file: "3"
Dreißig Megabyte je Dienst sind für alles reichlich, was nicht gerade untersucht wird. Die Einstellung gehört an jeden Dienst und nicht nur an den geschwätzigen, denn der geschwätzige ist meist der Dienst, der irgendwann anfängt, jede Sekunde einen Fehlerbericht zu schreiben.
Dieselbe Grenze lässt sich einmal für die ganze Maschine in /etc/docker/daemon.json setzen, und das ist der bessere Ort dafür – allerdings gilt sie nur für danach erzeugte Container, ein bestehender Stapel muss also neu angelegt werden, damit sie greift.
{
  "log-driver": "json-file",
  "log-opts": { "max-size": "10m", "max-file": "3" }
}
Wo nicht der Platz, sondern die Schreibvorgänge das Problem sind, gewinnt eine Speicherkarte damit, die Protokolle ganz aus dem Dateisystem zu nehmen – driver: journald reicht sie an systemd weiter, dem sich sagen lässt, sie im Arbeitsspeicher zu halten.
Speichergrenzen und die Pi-eigene Falle
Eine Maschine mit vier Gigabyte und ohne Auslagerung hat keinen Puffer für ein Leck. Welcher Prozess bei Speichermangel stirbt, entscheidet der Kern – und es ist regelmäßig nicht der verursachende.
    deploy:
      resources:
        limits:
          memory: 512M
          cpus: "1.5"
Eine Grenze macht aus einem Ausfall der ganzen Maschine einen Ausfall eines Containers: Der schuldige Container wird beendet und von seiner Neustartregel wieder gestartet, alles andere läuft weiter. Das ist ein deutlich besserer Ausgang, und die Grenze lohnt sich auch dann, wenn die Zahl geraten ist – eine großzügige Grenze begrenzt den Schaden immer noch.
Und nun der Teil, der den Raspberry Pi allein betrifft. Unter Raspberry Pi OS ist die Speicher-Steuergruppe voreingestellt abgeschaltet, und eine Speichergrenze in der Compose-Datei wird dann klaglos angenommen und bleibt wirkungslos. Eine Warnung erscheint einmal beim Start des Dienstes und danach nie wieder.
# an die einzige Zeile in /boot/firmware/cmdline.txt anhaengen, dann neu starten
cgroup_enable=memory cgroup_memory=1

# danach muss diese Zeile verschwunden sein:
docker info 2>&1 | grep -i "no memory limit support"
Die Datei enthält genau eine Zeile, und ein von einem Editor angehängter Zeilenumbruch macht die Maschine unstartbar – der Zusatz gehört also an das Ende der bestehenden Zeile, durch ein Leerzeichen getrennt.
Das Abbild festnageln, damit ein Neustart keine Aktualisierung ist
Ein Tag ist ein wandernder Zeiger. postgres:16 bedeutet in diesem Monat etwas anderes als im letzten, und den Zeitpunkt des Wechsels wählt niemand – er ist der Moment, in dem der Container zufällig neu angelegt wird.
image: postgres:16.4@sha256:f8cd4e0b9b0d15b6bbbcbbdf8c5f8c8b6c6b3e9b7cbb4f2d1e3a5c7d9f0b2a46Ein Digest ist unveränderlich, und damit wird aus „Container neu anlegen” ein Vorgang mit bekanntem Ergebnis. Der Tag bleibt davor stehen, als Dokumentation – der Digest allein ist unlesbar, und eine Datei voller Prüfsummen sagt niemandem, was läuft.
Der Digest eines bereits benutzten Abbilds ist einen Befehl entfernt.
docker image inspect postgres:16.4 --format '{{index .RepoDigests 0}}'Eine Warnung zur Verbindung mit automatischen Aktualisierungen. Ein Werkzeug, das planmäßig neue Abbilder holt, und ein fester Digest sind Gegensätze – beides zusammen heißt, dass der Digest stillschweigend gewinnt, während das Aktualisierungswerkzeug Erfolg meldet. Entweder wandern die Versionen nach Plan, oder sie wandern, wenn jemand es entscheidet; beides ist vertretbar, eines davon versehentlich zu haben nicht.
Zwei weitere Zeilen gehören in denselben Block und kosten nichts. Ein Container, der nie in sein eigenes Dateisystem schreibt, darf das sagen, und einem, der nicht Wurzel werden muss, lässt sich mitteilen, dass er es nie wird.
    read_only: true
    tmpfs:
      - /tmp
    security_opt:
      - no-new-privileges:true
    user: "1000:1000"
Die Datei prüfen, bevor sie läuft
Compose löst Variablen auf, führt Ergänzungsdateien zusammen und setzt Voreinstellungen ein – und das Ergebnis ist oft nicht das, was die Datei zu sagen scheint. Ein Befehl gibt aus, was tatsächlich gestartet wird.
docker compose configDrei Dinge lohnen sich in dieser Ausgabe zu suchen. Ein leerer Wert, wo eine Variable stehen sollte – eine nicht gesetzte Variable wird ohne Fehlermeldung zur leeren Zeichenkette, und ein fehlendes Passwort liest sich oft als kein Passwort. Ein Abbild ohne Digest. Und ein Dienst ohne restart, ohne healthcheck oder ohne logging, worüber das Auge in einer Datei mit acht Diensten leicht hinwegliest.
Das Letzte lässt sich maschinell prüfen, und das lohnt sich, denn es ist genau die Art von Auslassung, die beim schnellen Hinzufügen eines Dienstes entsteht.
docker compose config --format json | python3 -c '
import json, sys
stack = json.load(sys.stdin)
for name, svc in stack["services"].items():
    fehlt = [f for f in ("restart", "healthcheck", "logging") if f not in svc]
    if "@sha256:" not in svc.get("image", ""):
        fehlt.append("digest")
    print(f"{name:20s} {\", \".join(fehlt) if fehlt else \"ok\"}")
'
Nach dem ersten Lauf gehört eine letzte Prüfung zur Routine, und sie braucht kein Werkzeug: die Maschine absichtlich neu starten und ansehen, was zurückkommt. Ein Stapel, der noch nie einen Neustart überstanden hat, ist nicht geprüft – und der Morgen nach einem Stromausfall ist nicht der Zeitpunkt, das herauszufinden.
Fragen und Antworten
Wie fällt eine Absturzschleife auf, wenn Docker selbst nichts meldet?
Über Angaben, die Docker ohnehin führt, nur nicht von sich aus meldet. Drei Stellen genügen:
- Die Statusspalte von
docker ps. Ein Container in der Schleife steht dort als „Restarting“ oder mit einer Laufzeit von wenigen Sekunden, obwohl die Maschine seit Tagen läuft. - Der Neustartzähler.
docker inspect --format '{{.RestartCount}}' <container>nennt, wie oft die Neustartregel schon eingegriffen hat. Ein Wert, der zwischen zwei Abfragen wächst, ist ein eindeutiges Zeichen. - Der Gesundheitszustand. Mit einer Gesundheitsprüfung zeigt dieselbe Statusspalte zusätzlich „healthy“ oder „unhealthy“. Ein Container, der läuft und als unhealthy markiert ist, ist der hängende Fall aus dem Artikel.
Ein kleines Skript, das diese Werte regelmäßig abfragt und bei einer Änderung eine Nachricht verschickt, macht aus der stillen Schleife eine gemeldete.
Was geht verloren, wenn journald die Protokolle nur im Arbeitsspeicher hält?
Alles, was vor dem letzten Neustart geschrieben wurde, also ausgerechnet die Meldungen, die einen Absturz oder Stromausfall erklären könnten. Mit Storage=volatile liegt das Journal unter /run/log/journal und übersteht keinen Neustart; wer die Karte schonen und trotzdem nachsehen können will, schickt die Protokolle zusätzlich an eine zweite Maschine.
Welcher Digest gehört in die Datei, wenn ein Abbild für mehrere Architekturen gebaut ist?
Der Digest des Index, also der Liste, die auf die Fassungen für die einzelnen Architekturen verweist. Den liefert der Befehl aus dem Artikel, wenn das Abbild zuvor über seinen Tag geholt wurde, und mit ihm bekommt jede Maschine weiterhin die Fassung, die zu ihr passt: der Pi die für ARM, ein Testrechner die für x86.
Die Falle liegt in der Weboberfläche der Registry. Dort stehen neben dem Index oft auch die Digests der einzelnen Fassungen, und wer den Wert für amd64 kopiert, nagelt den Pi auf ein Abbild für eine fremde Architektur fest. Docker holt und startet es trotzdem und meldet nur eine Warnung über die abweichende Plattform; ohne installierte Emulation bricht der Prozess im Container dann mit „exec format error“ ab.
Ob ein Digest der richtige ist, zeigt docker buildx imagetools inspect mit dem Tag: Die Ausgabe nennt oben den Digest des Index und darunter die einzelnen Plattformen mit ihren eigenen Digests.
Warum startet ein Dienst nach read_only: true oder einem festen user nicht mehr?
Weil viele Abbilder beim Start mehr tun, als ihr Dienst im Betrieb braucht. Häufig schreibt ein Einstiegsskript eine Konfigurationsdatei aus Umgebungsvariablen, legt eine PID-Datei unter /run ab oder richtet Verzeichnisse ein, bevor der eigentliche Prozess läuft. Mit read_only: true scheitert jeder dieser Schreibvorgänge außerhalb von /tmp und den eingebundenen Volumes. Die Fehlermeldung nennt in der Regel den Pfad, und der gehört dann als weiterer Eintrag unter tmpfs oder in ein Volume.
Beim festen Benutzer liegt der Grund meist in den Dateirechten. Daten in einem Volume oder einem eingebundenen Verzeichnis, die früher als root angelegt wurden, darf der Benutzer mit der Kennung 1000 nicht beschreiben. Dazu kommen Abbilder, die bewusst als root starten, die Rechte ihrer Datenverzeichnisse selbst anpassen und erst danach zu einem eigenen Benutzer wechseln; ein fest gesetztes user nimmt ihnen diesen ersten Schritt, und die Anpassung muss vorab auf dem Host erfolgen.
Die beiden Zeilen kosten also keine Leistung, wohl aber einen Probelauf je Dienst. Am sichersten ist es, sie Dienst für Dienst einzuführen und nach jedem den Neustarttest aus dem Artikel zu wiederholen.
Passend dazu