English
 Deutsch
 Polski
Koszty BigQuery przy eksporcie GA4: które tabele i kolumny czyta zapytanie oraz bezpłatny dry run

Spis treści
Eksport GA4 rozlicza się po bajtach, a liczba bajtów nie ma z odpowiedzią prawie nic wspólnego. Zapytanie zwracające czterdzieści wierszy i zapytanie zwracające cztery miliony mogą odczytać dokładnie tyle samo – bo rozlicza się to, co trzeba było po drodze otworzyć, a nie to, co na końcu wróciło.
Rozstrzygają dwa szczegóły: ile tabel dziennych trzeba otworzyć i ile kolumn w nich odczytać. Jedno i drugie jest przesądzone, zanim powstanie choć jeden wiersz, i jedno i drugie da się wcześniej odczytać.
Płaci się za czytanie, nie za zwracanie
Najdroższe nieporozumienie w tym obszarze nazywa się LIMIT. Ograniczenie działa po odczytaniu danych; przycina zbiór wyników i nie zmienia kosztu o nic. To samo dotyczy ORDER BY i wszystkiego innego, co dzieje się, gdy wiersze już są.
Tym samym nawyk przeglądania przez SELECT * ... LIMIT 10 – rozsądny w niemal każdej innej bazie – jest najdroższym sposobem obejrzenia eksportu GA4. Dziesięć wierszy z każdej kolumny po każdej tabeli wieloznacznika to pełny przebieg z małym okienkiem na końcu.
Dlaczego event_date niczego nie przycina
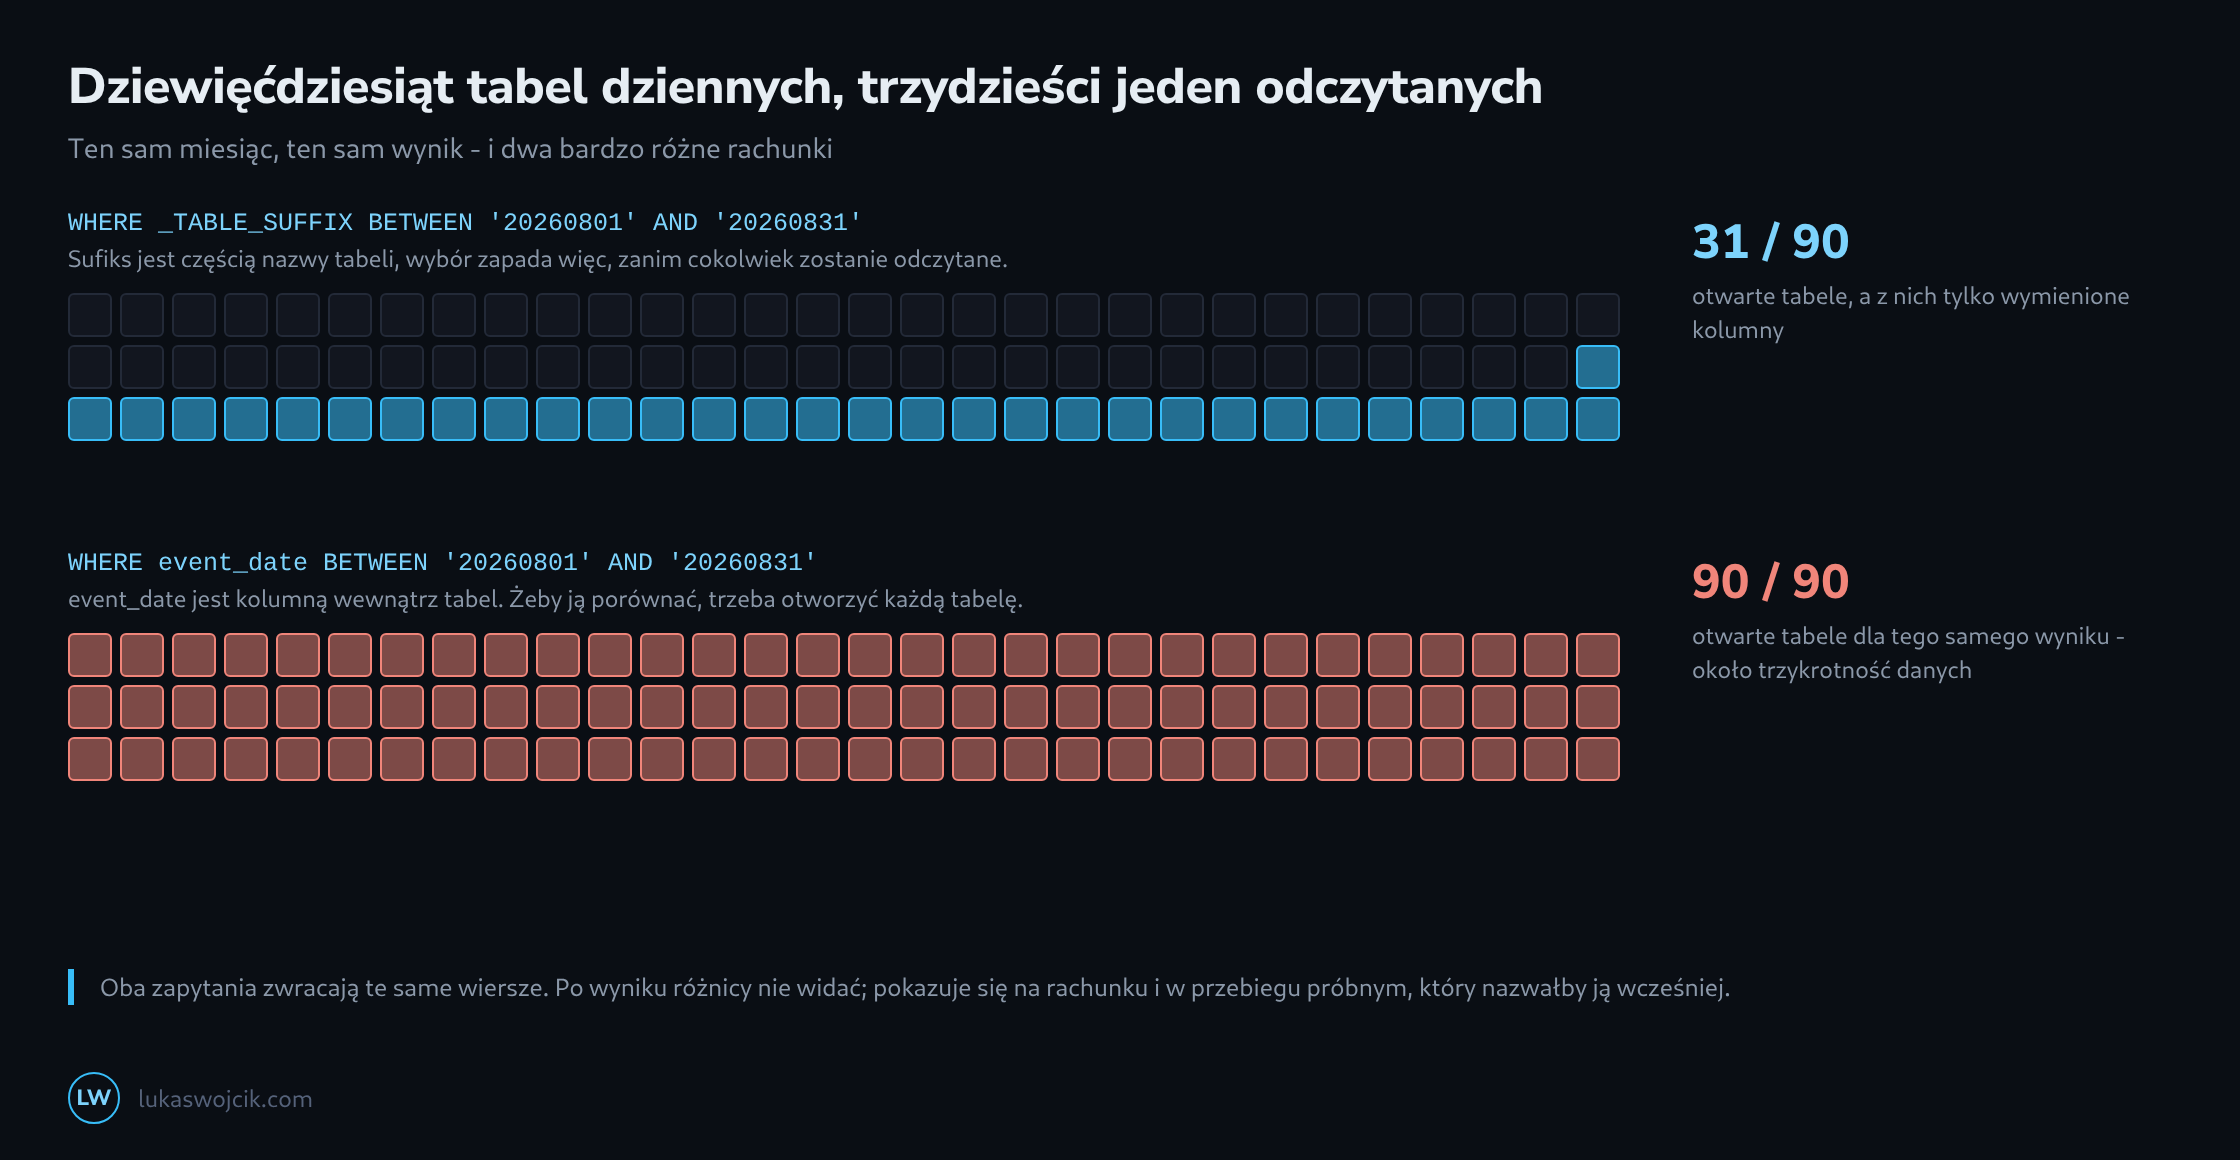
Tabele dzienne adresuje się wieloznacznikiem, a _TABLE_SUFFIX to ta część nazwy tabeli, która po nim następuje. Filtrowanie po nim wybiera tabele, a wybór następuje przed czytaniem – reszty maszyna po prostu nigdy nie otwiera.
event_date wygląda, jakby robiło to samo, a robi coś przeciwnego. Jest kolumną w każdej tabeli; żeby stwierdzić, czy tabela zawiera pasujące wiersze, trzeba ją otworzyć i tę kolumnę odczytać. Filtr działa poprawnie, wynik jest identyczny, a rachunek obejmuje cały wieloznacznik.
# przycina: sufiks jest częścią nazwy
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831'

# nie przycina: kolumna leży wewnątrz tabel
WHERE event_date BETWEEN '20260801' AND '20260831'

# oba zwracają te same wiersze
Ta sama logika tłumaczy, dlaczego wieloznacznik trafia również events_intraday_* i dlaczego filtr sufiksu je wyklucza: intraday_ sortuje się za każdą ośmiocyfrową datą, więc zakres kończący się datą zostawia je na zewnątrz. To skutek uboczny, który warto znać, a nie na nim polegać – bieżący dzień odpytuje się z tabeli intraday celowo i osobno.
Kolumny to druga dźwignia
Wewnątrz tabel, które faktycznie zostają otwarte, kosztem jest suma wymienionych kolumn. Tu zaczyna mieć znaczenie budowa eksportu: event_params to jedna zagnieżdżona kolumna, w której leży każdy parametr każdego zdarzenia, a zapytanie wyciągające z niej pojedynczy parametr czyta całą kolumnę.
Odczytanie z tej tablicy samego page_location nie jest możliwe. Nie przemawia to przeciw jej użyciu – przemawia za wymienianiem kolumn wprost zamiast sięgania po SELECT *, bo naprawdę duże kolumny to dokładnie te, których nikt nie potrzebuje: user_properties, items, collected_traffic_source oraz struktury urządzenia i geolokalizacji.
Co faktycznie zmienia każde działanie
| Działanie | Wpływ na odczytane bajty |
|---|---|
_TABLE_SUFFIX zamiast event_date |
z każdej tabeli zbioru do tych z zakresu |
wymienianie kolumn zamiast SELECT * |
proporcjonalnie – często największa pojedyncza oszczędność |
LIMIT 100 |
żaden |
| filtr po parametrze zdarzenia | żaden – event_params i tak czyta się w całości |
filtr po event_name |
zależy od klastrowania tabel – powie to przebieg próbny |
| wąska tabela zapisywana raz dziennie | ułamek, trwale, dla każdego kolejnego zapytania |
Wiersz o klastrowaniu celowo pozostaje tu bez odpowiedzi. To, czy filtr po event_name oszczędza bajty, zależy od zbioru, a snucie domysłów jest zbędne, gdy dokładna odpowiedź leży o jedno naciśnięcie klawisza dalej.
Przebieg próbny jest darmowy i dokładny
BigQuery wylicza oszacowanie bajtów z metadanych tabel, nie wykonując niczego – jest więc darmowe i dokładne. Edytor pokazuje je w rogu przed wysłaniem zapytania; w wierszu poleceń to samo dostępne jest jako przełącznik.
bq query --use_legacy_sql=false --dry_run 'SELECT ...'

Query successfully validated.
Assuming the tables are not modified,
this query will process 41 203 847 552 bytes of data.
Czterdzieści jeden gigabajtów to liczba, o której da się zdecydować. Uruchomienie zapytania najpierw i dowiedzenie się potem to ta sama informacja w gorszym momencie, a między tymi nawykami leży jeden wiersz przed instrukcją.
Co się powtarza, należy do wąskiej tabeli
Ostatnia dźwignia jest budowlana, a nie językowa. Analiza uruchamiana każdego ranka na dziewięćdziesięciu dniach czyta na nowo osiemdziesiąt dziewięć dni, które od wczoraj się nie zmieniły.
Zaplanowane zapytanie zapisujące raz dziennie tych kilka faktycznie używanych pól do własnej tabeli zamienia to w: odczytać jeden dzień, a potem odpytywać coś małego. Dzienny przebieg kosztuje tyle, ile kosztuje jeden dzień; wszystko dalsze kosztuje ułamek dotychczasowego. To ta sama sztuczka co widok zmaterializowany i opłaca się, gdy tylko zapytanie zostało uruchomione ręcznie trzy razy.
Klastrowanie wąskiej tabeli
Wąską tabelę da się nie tylko partycjonować, lecz także posortować. Tabela klastrowana sortuje swoje bloki pamięci według wartości w kolumnach klastrowania, a gdy zapytanie filtruje po tych kolumnach, BigQuery na podstawie filtra i metadanych bloków pomija bloki, które nie mogą pasować. Dla tabeli zasilanej z eksportu GA4 naturalnymi kandydatami są event_name i user_pseudo_id, bo większość dalszych pytań zaczyna się od jednego typu zdarzenia albo jednego użytkownika.
CREATE TABLE IF NOT EXISTS `project.analytics_12345.daily_user_metrics`
(
  event_date DATE,
  event_name STRING,
  user_pseudo_id STRING,
  total_events INT64
)
PARTITION BY event_date
CLUSTER BY event_name, user_pseudo_id;
Kolejność ma znaczenie. Dozwolone są maksymalnie cztery kolumny klastrowania, a dane są sortowane w kolejności, w jakiej zostały wymienione. Zapytanie filtrujące wyłącznie po user_pseudo_id nie korzysta z klastrowania tak jak zapytanie z filtrem po event_name, dlatego kolumna, po której filtruje większość zapytań, stoi na początku.
Dla przebiegu próbnego wynika z tego jedno zastrzeżenie: przy tabeli klastrowanej nie wie on z góry, ile bloków zostanie pominiętych. Podaje wtedy liczbę bez tej oszczędności, a faktycznie rozliczone bajty są znane dopiero po wykonaniu zapytania i mogą być niższe. Partycjonowanie po dacie zachowuje w oszacowaniu stałą część, bo partycje są przycinane przed wykonaniem.
Pytania i odpowiedzi
Czy da się zapobiec temu, żeby zbyt drogie zapytanie w ogóle się uruchomiło?
Tak, za pomocą górnej granicy rozliczanych bajtów, ustawianej w konsoli w ustawieniach zapytania, a w wierszu poleceń jako --maximum_bytes_billed. Zapytanie, które odczytałoby więcej, kończy się wtedy błędem bez naliczenia kosztów, a inaczej niż przy przebiegu próbnym nikt nie musi wcześniej sprawdzać. Dla całego projektu da się dodatkowo ustawić dzienne limity odpytywanych bajtów, obowiązujące dla każdego zapytania w tym projekcie.
Co dzieje się z wąską tabelą, gdy GA4 później uzupełnia tabelę dzienną?
Wąska tabela niepostrzeżenie się dezaktualizuje, jeśli zaplanowane zapytanie każdego ranka tylko dopisuje poprzedni dzień. Tabela dzienna nie musi być gotowa wraz z pierwszym zapisem: GA4 uzupełnia ją o zdarzenia, które docierają z opóźnieniem, ale noszą datę tego dnia, a Google podaje dla tego okres do 72 godzin. Wąska tabela zachowuje wtedy stan z pierwszego ranka, a każda analiza na jej podstawie liczy nieco mniej niż sam eksport.
Rozwiązaniem jest przebieg, który nie dopisuje, lecz zastępuje: każdego ranka odczytuje z eksportu ostatnie cztery dni i zapisuje je w wąskiej tabeli od nowa, na przykład przez DELETE i INSERT dla tego zakresu albo jednym MERGE. Oznacza to codzienne czytanie czterech dni zamiast jednego, ale to wciąż cztery dni wobec dziewięćdziesięciu, które analiza czytała dotąd każdego ranka.
Jeśli wąska tabela jest partycjonowana po dacie, również zastępowanie pozostaje tanie: usuwanie i ponowny zapis dotyczą tylko partycji z ostatnich dni, a dalsze zapytania z filtrem daty czytają tylko partycje ze swojego zakresu. To to samo przycinanie co przez _TABLE_SUFFIX, tylko wewnątrz jednej tabeli.
Powiązane artykuły