English
 Deutsch
 Polski
BigQuery-Kosten beim GA4-Export: Welche Tabellen und Spalten eine Abfrage liest und der kostenlose Probelauf

Inhalt
Der GA4-Export wird nach Bytes abgerechnet, und die Byte-Zahl hat mit der Antwort fast nichts zu tun. Eine Abfrage, die vierzig Zeilen liefert, und eine, die vier Millionen liefert, können genau gleich viel lesen – denn abgerechnet wird, was unterwegs geöffnet werden musste, und nicht, was am Ende zurückkam.
Zwei Feinheiten entscheiden darüber: wie viele der Tagestabellen geöffnet werden müssen und wie viele Spalten darin zu lesen sind. Beides steht fest, bevor eine einzige Zeile entsteht, und beides lässt sich vorher ablesen.
Bezahlt wird das Lesen, nicht das Zurückgeben
Das teuerste Missverständnis in diesem Bereich heißt LIMIT. Eine Begrenzung greift, nachdem die Daten gelesen wurden; sie deckelt die Ergebnismenge und ändert an den Kosten nichts. Dasselbe gilt für ORDER BY und für alles andere, was geschieht, wenn die Zeilen erst einmal da sind.
Damit ist die Gewohnheit, mit SELECT * ... LIMIT 10 zu stöbern – in fast jeder anderen Datenbank vernünftig -, die teuerste Art, einen GA4-Export anzusehen. Zehn Zeilen aus jeder Spalte über jede Tabelle des Platzhalters sind ein vollständiger Durchlauf mit einem kleinen Fenster am Ende.
Warum event_date nichts beschneidet
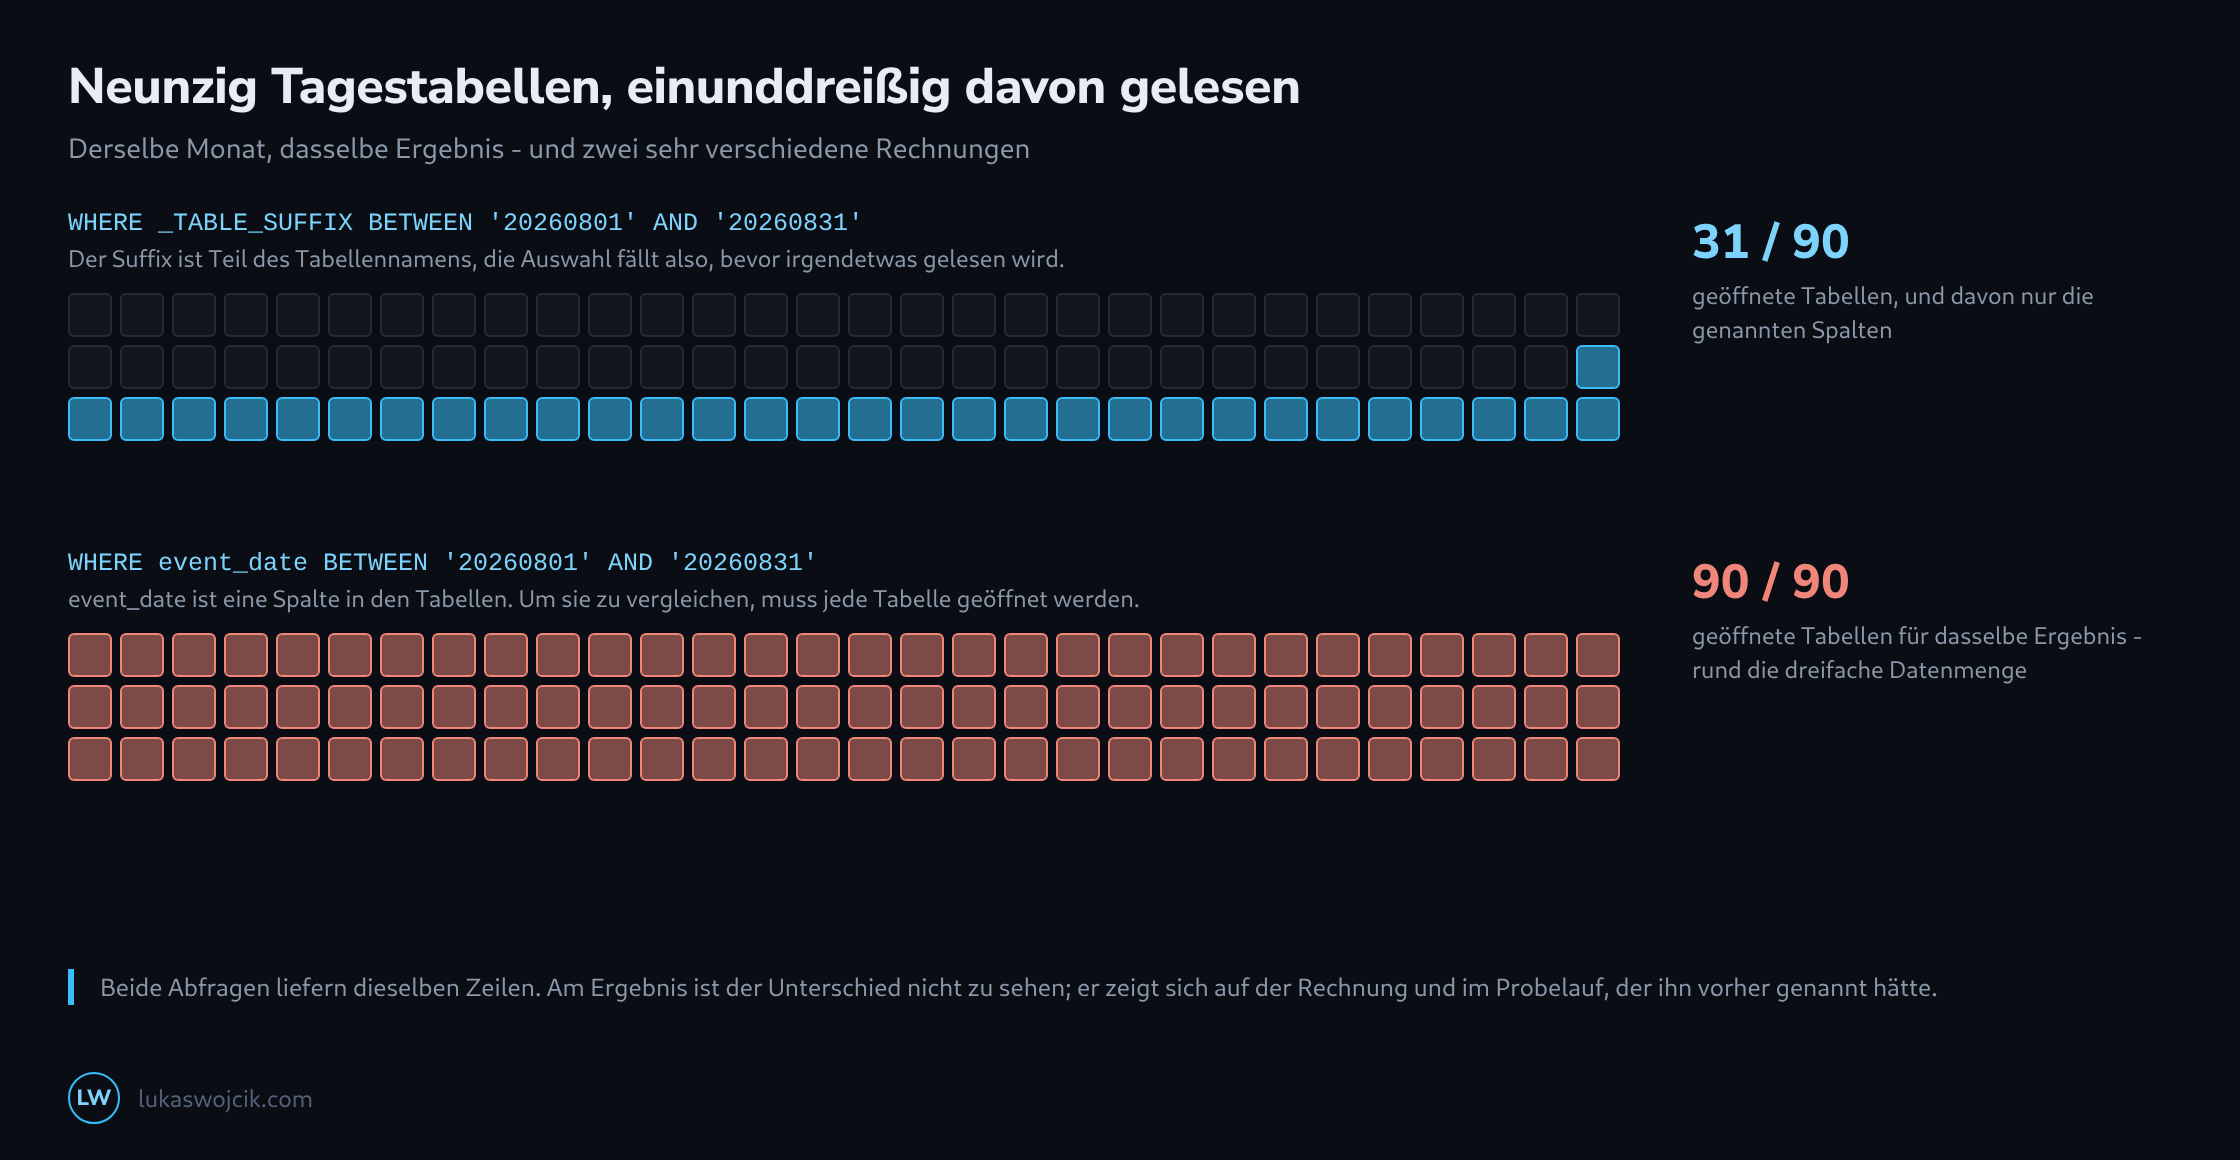
Die Tagestabellen werden über einen Platzhalter angesprochen, und _TABLE_SUFFIX ist der Teil des Tabellennamens, der darauf folgt. Danach zu filtern, wählt Tabellen aus, und Auswählen geschieht vor dem Lesen – den Rest öffnet die Maschine schlicht nie.
event_date sieht aus, als täte es dasselbe, und tut das Gegenteil. Es ist eine Spalte in jeder Tabelle; um herauszufinden, ob eine Tabelle passende Zeilen enthält, muss sie geöffnet und die Spalte gelesen werden. Der Filter wirkt korrekt, das Ergebnis ist identisch, und die Rechnung umfasst den ganzen Platzhalter.
# beschneidet: der Suffix ist Teil des Namens
WHERE _TABLE_SUFFIX BETWEEN '20260801' AND '20260831'

# beschneidet nicht: die Spalte liegt in den Tabellen
WHERE event_date BETWEEN '20260801' AND '20260831'

# beide liefern dieselben Zeilen
Dieselbe Logik erklärt, warum der Platzhalter auch events_intraday_* trifft und warum der Suffixfilter sie ausschließt: intraday_ sortiert hinter jedem achtstelligen Datum, ein Bereich, der auf ein Datum endet, lässt sie also draußen. Das ist eine Nebenwirkung, die zu kennen ist, ohne darauf zu bauen – für den laufenden Tag wird die Intraday-Tabelle absichtlich und getrennt abgefragt.
Spalten sind der zweite Hebel
Innerhalb der Tabellen, die tatsächlich geöffnet werden, sind die Kosten die Summe der genannten Spalten. Hier wird die Bauform des Exports wichtig: event_params ist eine einzige verschachtelte Spalte, in der jeder Parameter jedes Ereignisses liegt, und eine Abfrage, die einen einzelnen Parameter herauszieht, liest die ganze Spalte.
Aus diesem Feld nur page_location zu lesen, ist nicht möglich. Das spricht nicht gegen seine Verwendung – es spricht dafür, Spalten ausdrücklich zu benennen statt zu SELECT * zu greifen, denn die wirklich großen Spalten sind genau die, die niemand braucht: user_properties, items, collected_traffic_source und die Geräte- und Geostrukturen.
Was jede Maßnahme tatsächlich ändert
| Maßnahme | Wirkung auf die gelesenen Bytes |
|---|---|
_TABLE_SUFFIX statt event_date |
von jeder Tabelle des Datensatzes auf die im Zeitraum |
Spalten benennen statt SELECT * |
anteilig – oft die größte einzelne Ersparnis |
LIMIT 100 |
keine |
| ein Filter auf einen Ereignisparameter | keine – event_params wird so oder so ganz gelesen |
ein Filter auf event_name |
hängt an der Clusterung der Tabellen – der Probelauf sagt es |
| eine einmal je Tag geschriebene schmale Tabelle | ein Bruchteil, dauerhaft, für jede folgende Abfrage |
Die Zeile zur Clusterung bleibt hier absichtlich unbeantwortet. Ob ein Filter auf event_name Bytes spart, hängt am Datensatz, und darüber zu mutmaßen erübrigt sich, wenn die genaue Antwort einen Tastendruck entfernt liegt.
Der Probelauf ist kostenlos und genau
BigQuery berechnet die Byte-Schätzung aus den Tabellenmetadaten, ohne etwas auszuführen – damit ist sie kostenlos und exakt. Der Editor zeigt sie in der Ecke, bevor die Abfrage abgeschickt wird; auf der Befehlszeile gibt es dasselbe als Schalter.
bq query --use_legacy_sql=false --dry_run 'SELECT ...'

Query successfully validated.
Assuming the tables are not modified,
this query will process 41.203.847.552 bytes of data.
Einundvierzig Gigabyte sind eine Zahl, über die sich entscheiden lässt. Die Abfrage erst laufen zu lassen und es danach zu erfahren, ist dieselbe Auskunft zum schlechteren Zeitpunkt, und zwischen beiden Gewohnheiten liegt eine Zeile vor der Anweisung.
Was sich wiederholt, gehört in eine schmale Tabelle
Der letzte Hebel ist ein baulicher und kein sprachlicher. Eine Auswertung, die jeden Morgen über neunzig Tage läuft, liest neunundachtzig Tage erneut, die sich seit gestern nicht geändert haben.
Eine geplante Abfrage, die einmal je Tag die wenigen tatsächlich verwendeten Felder in eine eigene Tabelle schreibt, macht daraus: einen Tag lesen und danach etwas Kleines abfragen. Der tägliche Lauf kostet, was ein Tag kostet; alles Nachgelagerte kostet einen Bruchteil des Bisherigen. Es ist derselbe Kniff wie eine materialisierte Sicht und lohnt sich, sobald eine Abfrage dreimal von Hand gelaufen ist.
Die schmale Tabelle clustern
Die schmale Tabelle lässt sich nicht nur partitionieren, sondern auch sortieren. Eine geclusterte Tabelle sortiert ihre Speicherblöcke nach den Werten in den Clusterspalten, und filtert eine Abfrage auf diese Spalten, nutzt BigQuery den Filter und die Blockmetadaten, um Blöcke zu überspringen, die nicht passen können. Für eine Tabelle aus dem GA4-Export liegen event_name und user_pseudo_id nahe, weil die meisten nachgelagerten Fragen bei einem Ereignistyp oder einem Nutzer ansetzen.
CREATE TABLE IF NOT EXISTS `project.analytics_12345.daily_user_metrics`
(
  event_date DATE,
  event_name STRING,
  user_pseudo_id STRING,
  total_events INT64
)
PARTITION BY event_date
CLUSTER BY event_name, user_pseudo_id;
Die Reihenfolge zählt. Erlaubt sind bis zu vier Clusterspalten, und sortiert wird in der Reihenfolge, in der sie genannt sind. Eine Abfrage, die nur auf user_pseudo_id filtert, profitiert von der Clusterung nicht so wie eine Abfrage mit Filter auf event_name; die Spalte, auf die die meisten Abfragen filtern, gehört deshalb nach vorn.
Für den Probelauf folgt daraus eine Einschränkung: Bei einer geclusterten Tabelle weiß er vorher nicht, wie viele Blöcke übersprungen werden. Er nennt dann die Zahl ohne diese Ersparnis, und die tatsächlich abgerechneten Bytes stehen erst nach dem Lauf fest und können niedriger liegen. Die Partitionierung nach Datum hält einen festen Teil in der Schätzung, weil Partitionen vor der Ausführung beschnitten werden.
Fragen und Antworten
Lässt sich verhindern, dass eine zu teure Abfrage überhaupt läuft?
Ja, mit einer Obergrenze für abgerechnete Bytes, in der Konsole in den Abfrageeinstellungen, auf der Befehlszeile als --maximum_bytes_billed. Eine Abfrage, die mehr lesen würde, scheitert dann, ohne dass Kosten entstehen, und anders als beim Probelauf muss dafür niemand vorher hinsehen. Für ein ganzes Projekt lassen sich zusätzlich Tageskontingente für abgefragte Bytes festlegen, die für jede Abfrage in diesem Projekt gelten.
Was geschieht mit der schmalen Tabelle, wenn GA4 eine Tagestabelle nachträglich ergänzt?
Die schmale Tabelle veraltet unbemerkt, wenn die geplante Abfrage jeden Morgen nur den Vortag anhängt. Eine Tagestabelle ist mit ihrem ersten Schreiben nicht zwingend fertig: GA4 ergänzt sie um Ereignisse, die verspätet eintreffen und das Datum dieses Tages tragen, und Google nennt dafür bis zu 72 Stunden. Die schmale Tabelle hält dann den Stand des ersten Morgens fest, und jede Auswertung darauf zählt etwas weniger als der Export selbst.
Abhilfe schafft ein Lauf, der nicht anhängt, sondern ersetzt: jeden Morgen die letzten vier Tage aus dem Export lesen und in der schmalen Tabelle neu schreiben, etwa mit DELETE und INSERT für diesen Zeitraum oder in einem einzigen MERGE. Damit liest der Lauf jeden Morgen vier Tage statt eines; gegenüber den neunzig Tagen, die die Auswertung bisher jeden Morgen gelesen hat, bleibt das ein kleiner Bruchteil.
Ist die schmale Tabelle nach Datum partitioniert, bleibt auch das Ersetzen günstig: Löschen und Neuschreiben betreffen nur die Partitionen der letzten Tage, und nachgelagerte Abfragen mit Datumsfilter lesen nur die Partitionen ihres Zeitraums. Das ist dieselbe Beschneidung wie über _TABLE_SUFFIX, nur innerhalb einer einzigen Tabelle.
Passend dazu