English
 Deutsch
 Polski
Bezserwerowe mikrousługi: Skalowanie w Google Cloud Run z GitHub Actions

Spis treści
- 1. Architektura rozwiązania: Skalowanie do zera i CI/CD bez kluczy
- 2. Konfiguracja Workload Identity Federation krok po kroku
- 3. Konfiguracja przepływu pracy GitHub Actions krok po kroku
- 4. Inżynieria skalowania i współbieżności krok po kroku
- 5. Podsumowanie i wartość architektoniczna
- Pytania i odpowiedzi
- Źródła
Utrzymywanie mikrousług na statycznych maszynach wirtualnych lub stale działających klastrach Kubernetes generuje ciągłe koszty infrastrukturalne, nawet w okresach zerowego natężenia ruchu. Wdrożenie bezstanowych (stateless) interfejsów API w kontenerach na platformie Google Cloud Run umożliwia stworzenie w pełni zarządzanej, bezserwerowej architektury, która automatycznie skaluje się od zera instancji w godzinach nocnych do tysięcy równolegle pracujących kontenerów podczas nagłych skoków ruchu. Połączenie tego modelu wdrożeniowego z systemem GitHub Actions oraz mechanizmem Workload Identity Federation tworzy bezobsługowy, wysoce bezpieczny potok CI/CD bez konieczności przechowywania długoterminowych kluczy JSON kont serwisowych w zewnętrznych repozytoriach.
1. Architektura rozwiązania: Skalowanie do zera i CI/CD bez kluczy
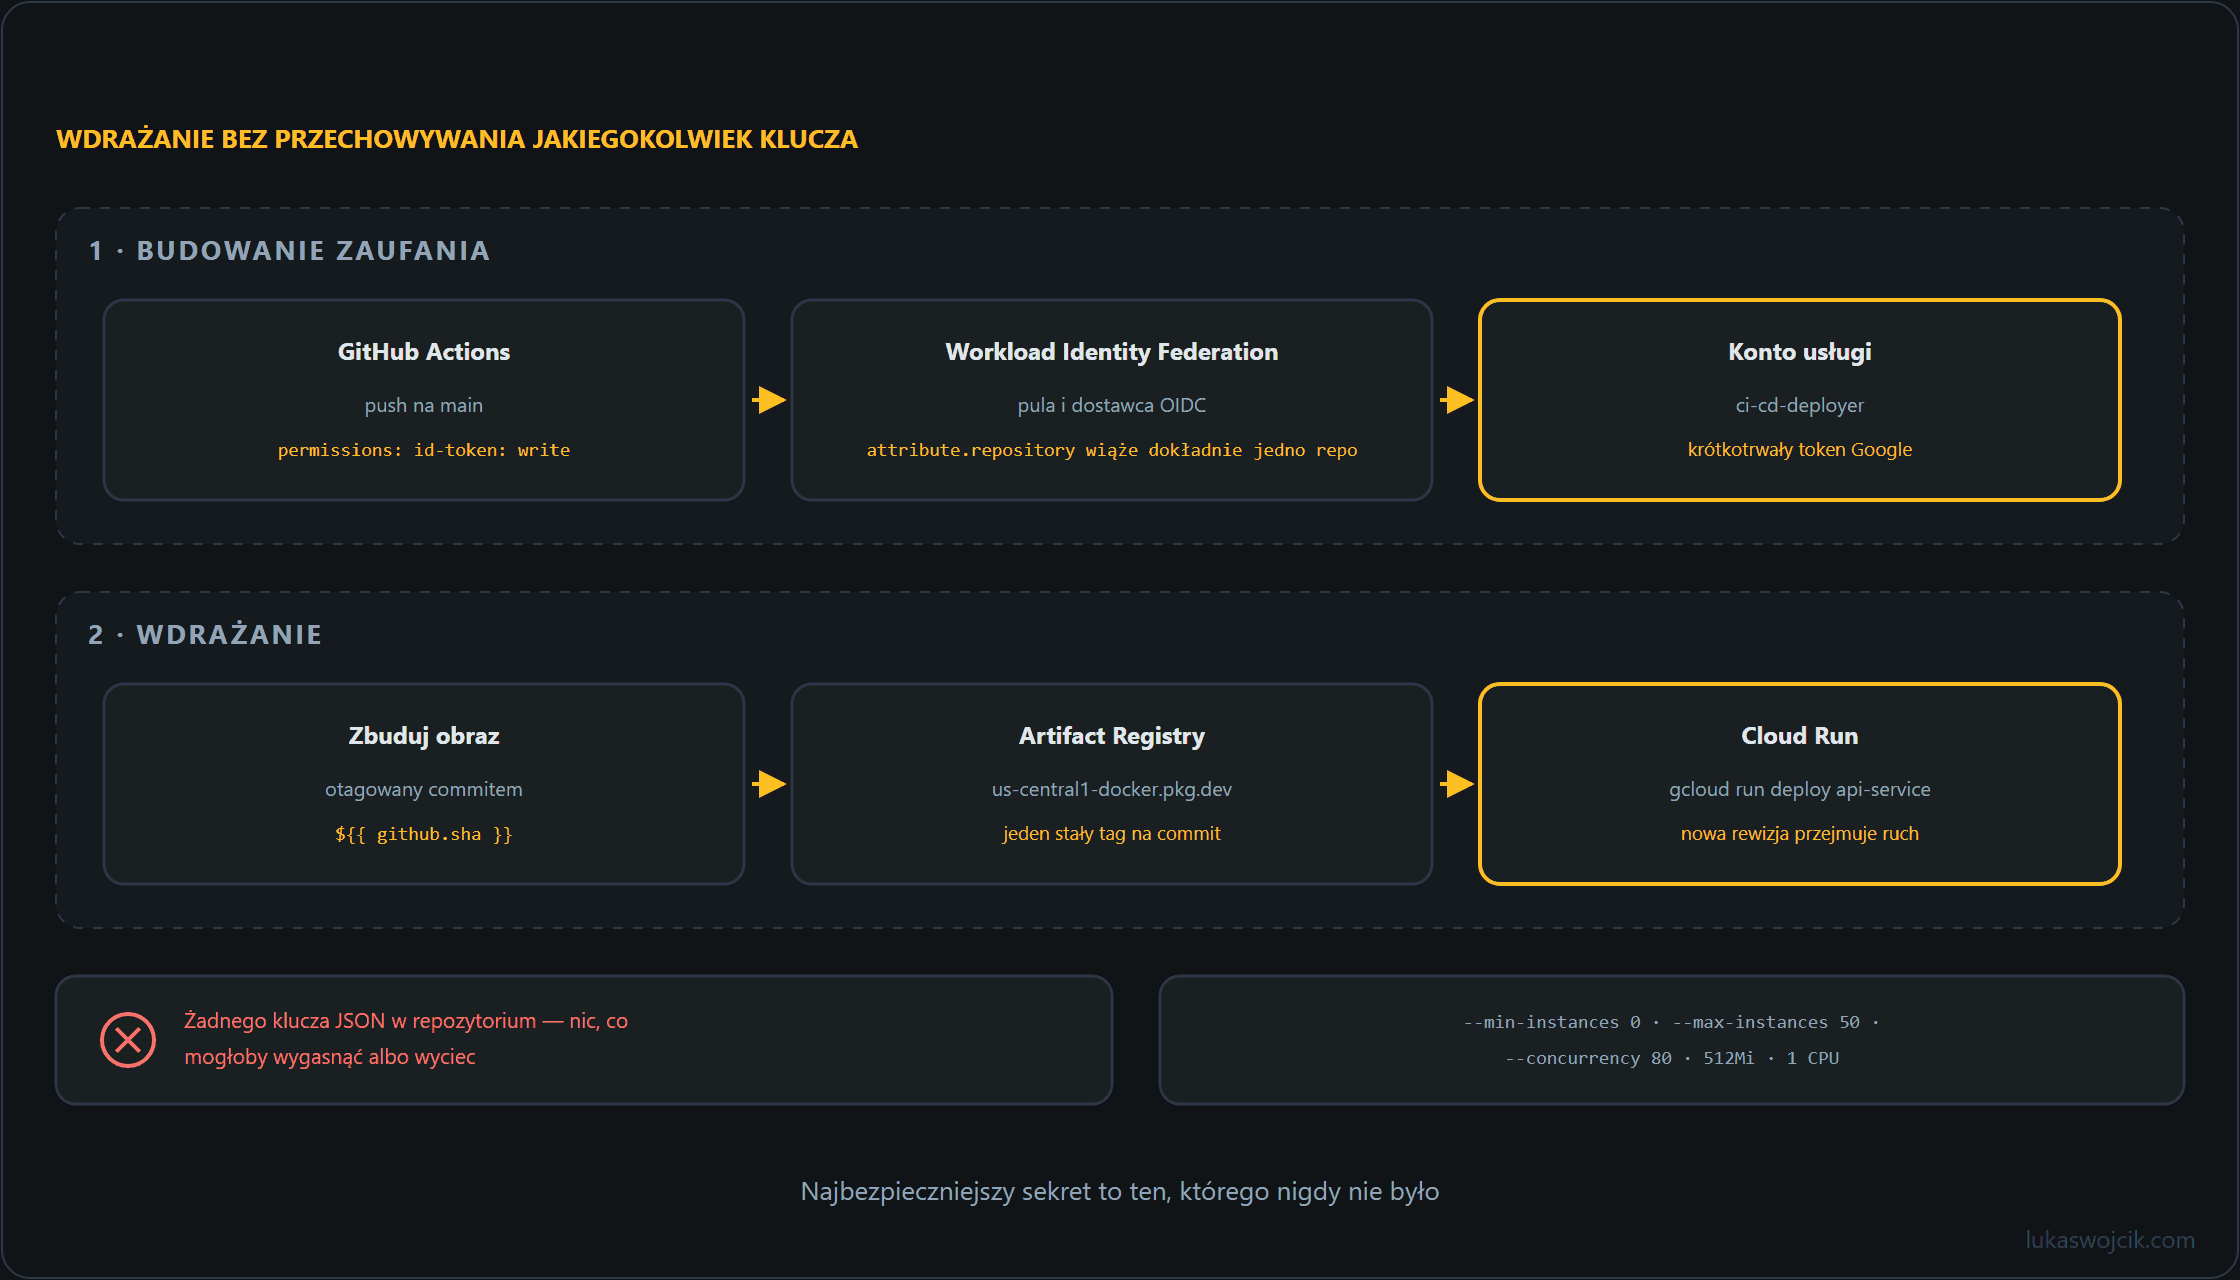
Profesjonalna architektura bezserwerowa w Google Cloud opiera się na współpracy trzech niezależnych elementów:
- Środowisko wykonawcze Google Cloud Run: Bezstanowe kontenery są uruchamiane na żądanie na podstawie przychodzących zapytań HTTP. Ustawienia współbieżności (Concurrency) pozwalają pojedynczej instancji kontenera na obsługę do 80 równoległych żądań (wartość domyślna, z możliwością zwiększenia do 1000) przed wyzwoleniem skalowania poziomego.
- Workload Identity Federation (WIF): Zastępuje statyczne, eksportowalne klucze JSON kont serwisowych wymianą tokenów OpenID Connect (OIDC) pomiędzy GitHubem a usługą IAM Google Cloud, eliminując ryzyko wycieku poświadczeń.
- Potok GitHub Actions: Zautomatyzowany przepływ pracy buduje obraz Docker aplikacji, przesyła go do Google Artifact Registry i wdraża nową rewizję usługi w Cloud Run z zerowym czasem niedostępności (Zero Downtime).
2. Konfiguracja Workload Identity Federation krok po kroku
W celu włączenia uwierzytelniania bezkluczowego dla GitHub Actions należy utworzyć pulę i dostawcę tożsamości za pomocą interfejsu wiersza poleceń Google Cloud CLI:
# 1. Utworzenie puli Workload Identity Pool
gcloud iam workload-identity-pools create "github-actions-pool" \
  --project="enterprise-ai-project" \
  --location="global" \
  --display-name="GitHub Actions Pool"

# 2. Utworzenie dostawcy tożsamości OIDC dla GitHuba
gcloud iam workload-identity-pools providers create-oidc "github-provider" \
  --project="enterprise-ai-project" \
  --location="global" \
  --workload-identity-pool="github-actions-pool" \
  --display-name="GitHub Provider" \
  --attribute-mapping="google.subject=assertion.sub,attribute.actor=assertion.actor,attribute.repository=assertion.repository" \
  --attribute-condition="assertion.repository_owner == 'enterprise-org'" \
  --issuer-uri="https://token.actions.githubusercontent.com"

# 3. Powiązanie konta serwisowego z repozytorium GitHub
gcloud iam service-accounts add-iam-policy-binding "ci-cd-deployer@enterprise-ai-project.iam.gserviceaccount.com" \
  --project="enterprise-ai-project" \
  --role="roles/iam.workloadIdentityUser" \
  --member="principalSet://iam.googleapis.com/projects/1234567890/locations/global/workloadIdentityPools/github-actions-pool/attribute.repository/enterprise-org/microservice-repo"
3. Konfiguracja przepływu pracy GitHub Actions krok po kroku
Zautomatyzowany potok wdrożeniowy wymaga zdefiniowania pliku YAML w ścieżce .github/workflows/deploy.yml. Przepływ ten uwierzytelnia się przez OIDC, buduje obraz kontenera i wdraża go w Cloud Run z precyzyjnie określonymi parametrami skalowania i współbieżności:
name: Deploy to Google Cloud Run

on:
  push:
    branches:
      - main

permissions:
  contents: 'read'
  id-token: 'write'

jobs:
  build-and-deploy:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout Code
        uses: actions/checkout@v4

      - name: Authenticate to Google Cloud
        uses: google-github-actions/auth@v2
        with:
          workload_identity_provider: 'projects/1234567890/locations/global/workloadIdentityPools/github-actions-pool/providers/github-provider'
          service_account: 'ci-cd-deployer@enterprise-ai-project.iam.gserviceaccount.com'

      - name: Set up Cloud SDK
        uses: google-github-actions/setup-gcloud@v2

      - name: Configure Docker for Artifact Registry
        run: gcloud auth configure-docker us-central1-docker.pkg.dev

      - name: Build and Push Docker Image
        run: |
          docker build -t us-central1-docker.pkg.dev/enterprise-ai-project/services/api-service:${{ github.sha }} .
          docker push us-central1-docker.pkg.dev/enterprise-ai-project/services/api-service:${{ github.sha }}

      - name: Deploy to Cloud Run
        run: |
          gcloud run deploy api-service \
            --image us-central1-docker.pkg.dev/enterprise-ai-project/services/api-service:${{ github.sha }} \
            --region us-central1 \
            --platform managed \
            --allow-unauthenticated \
            --min-instances 0 \
            --max-instances 50 \
            --concurrency 80 \
            --memory 512Mi \
            --cpu 1
4. Inżynieria skalowania i współbieżności krok po kroku
W celu zapewnienia optymalnego wykorzystania zasobów i ograniczenia opóźnień zimnego startu (Cold Start), parametry wykonawcze usługi Cloud Run muszą zostać precyzyjnie dostrojone:
- Weryfikacja skalowania do zera (
--min-instances=0): Pozwala Cloud Run zredukować usługę do zera instancji przy braku ruchu; bezczynne instancje mogą być utrzymywane do 15 minut, ale przy domyślnym rozliczaniu opartym na żądaniach nie są za nie naliczane opłaty, co obniża koszty obliczeniowe w okresach spoczynku dokładnie do 0,00 PLN. - Dostrajanie współbieżności (
--concurrency=80): Pozwala jednemu wirtualnemu procesorowi kontenera na równoległą obsługę do 80 żądań, co znacznie zmniejsza zapotrzebowanie na pamięć i zapobiega ciągłemu uruchamianiu nowych instancji. - Zarządzanie dławieniem procesora: Domyślnie procesor jest dławiony poza czasem obsługi aktywnego żądania HTTP. Jeśli wymagane jest wykonywanie zadań w tle po wysłaniu odpowiedzi, należy zastosować flagę `–no-cpu-throttling` w połączeniu z `–min-instances=1`.
5. Podsumowanie i wartość architektoniczna
Co da się osiągnąć dzięki temu poradnikowi: Wdrożenie w pełni zautomatyzowanego, bezkluczowego potoku CI/CD dla mikrousług w kontenerach na platformie Google Cloud Run przy użyciu GitHub Actions oraz mechanizmu Workload Identity Federation.
Wynikająca z tego wartość: Koszty utrzymania infrastruktury zostają zminimalizowane dzięki spadkowi wydatków na serwery do zera w okresach braku ruchu, przy jednoczesnym zachowaniu zdolności do natychmiastowego skalowania poziomego podczas skoków obciążenia. Wyeliminowanie statycznych kluczy JSON zapobiega ryzyku wycieku poświadczeń, a odpowiednio skonfigurowana współbieżność maksymalizuje wydajność kontenerów w całkowicie bezobsługowym środowisku backendowym.
Pytania i odpowiedzi
Czy usługa skalowana do zera instancji naprawdę nic nie kosztuje?
Czas działania nic nie kosztuje, reszta łańcucha już tak. Każdy przebieg potoku zapisuje w Artifact Registry nowy obraz oznaczony hashem commita, a ta przestrzeń jest rozliczana według objętości, niezależnie od tego, czy usługa działa. Reguła czyszczenia w Artifact Registry, która usuwa stare obrazy, a zostawia kilka nowszych, żeby powrót do wcześniejszej rewizji pozostał możliwy, utrzymuje tę pozycję na niskim poziomie.
Jakich ról potrzebuje konto serwisowe ci-cd-deployer poza powiązaniem Workload Identity?
Powiązanie z roles/iam.workloadIdentityUser pozwala GitHubowi jedynie występować jako to konto. To, co konto może potem robić, określają kolejne role, a przepływ pracy potrzebuje trzech z nich:
- Prawa zapisu do repozytorium w Artifact Registry, zwykle
roles/artifactregistry.writer; bez niegodocker pushkończy się błędem. - Roli Cloud Run do wdrażania.
roles/run.developerwystarcza dogcloud run deploy, ale nie do--allow-unauthenticated: ta flaga zmienia politykę IAM usługi, a do tego potrzebna jestroles/run.admin. roles/iam.serviceAccountUserna koncie serwisowym, pod którym działa usługa; bez osobnego ustawienia jest to domyślne konto serwisowe Compute Engine w projekcie. Bez tej roli konto wdrażające nie utworzy rewizji działającej pod inną tożsamością.
Rozsądnie jest nadawać te role możliwie wąsko, na jedno repozytorium i jedną usługę zamiast na cały projekt. Wyciek klucza jest wykluczony, błędny przepływ pracy już nie, a role decydują o tym, jak daleko sięgnie wyrządzona przez niego szkoda.
Czy powiązanie z repozytorium wystarcza, czy wdrażać może każda gałąź?
Powiązanie obejmuje całe repozytorium. Przepływ pracy startuje wprawdzie tylko po pushu do main, ale każdy inny plik przepływu pracy w tym samym repozytorium, także na innej gałęzi, może z id-token: write zażądać tokenu, a Google go przyjmie, bo atrybut repository się zgadza.
Zawęża to dopiero gałąź, którą token OIDC z GitHuba niesie w polu ref. Warunek przy dostawcy tożsamości, na przykład assertion.ref == 'refs/heads/main' (dołączony do --attribute-condition przez &&), albo dodatkowo zmapowany atrybut, do którego zostaje przypięte konto serwisowe, przepuszcza już tylko przebiegi z main. Ustawiony w sekcji 2 warunek na assertion.repository_owner zapewnia ponadto, że pula w ogóle nie przyjmuje tokenów z obcych organizacji.
Ile kosztuje połączenie –no-cpu-throttling z –min-instances=1?
Kosztuje zaletę, od której zaczyna się artykuł. Minimalna instancja ze stale przydzielonym procesorem działa całą dobę i jest rozliczana także wtedy, gdy nie przychodzi żadne żądanie, więc koszty obliczeniowe w okresach spoczynku przestają spadać do zera. Do pracy wykonywanej po odpowiedzi tańszym wyborem bywa dlatego osobna kolejka albo zadanie Cloud Run (Cloud Run job), dzięki czemu sama usługa sieciowa nadal skaluje się do zera.
Powiązane artykuły