English
 Deutsch
 Polski
Aktuelle AI-Modelle im Vergleich: GPT, Claude und Gemini gegen DeepSeek und Qwen

Inhalt
Ein Vergleich aktueller AI-Modelle braucht mehr als eine Rangliste. Ein Chatprodukt, eine Modell-API und herunterladbare Gewichte eröffnen unterschiedliche Möglichkeiten. Stand dieses Überblicks ist der 6. Oktober 2026. Die Einordnung beruht auf offiziellen Dokumentationen; eigene Leistungsmessungen liegen nicht vor.
Welche Modelle tatsächlich zum Vergleich gehören
OpenAI führt GPT-6 Astra, GPT-6.1 Sol und GPT-6 Luna. Anthropic nennt Claude Fable 5.1, Opus 5.5 und Sonnet 5.5. Google dokumentiert Gemini 3.8 Flash als stabiles Modell. Für die offene Seite dienen DeepSeek V4.1 Flash und Qwen3.8-27B als konkrete Referenzen. Zugriff über eine dokumentierte API bedeutet allerdings keine Freischaltung jedes Modells in jedem Chatabo. [1, 3, 6, 7, 8]
Zugang und Kontrolle unterscheiden sich
| Familie | Konkrete Auswahl | Betriebsweg | Entscheidender Prüfpunkt |
|---|---|---|---|
| GPT | Astra / 6.1 Sol / Luna | Gehostete API | Qualitätsbedarf und Aufwand |
| Claude | Fable 5.1 / Opus 5.5 / Sonnet 5.5 | Gehostete API | Agentenablauf und Werkzeugzugang |
| Gemini | 3.8 Flash | Gehostete API | Dokumente und Eingabemodalitäten |
| DeepSeek | V4.1 Flash | API oder veröffentlichte Gewichte | Vollmodell und Speicherbedarf |
| Qwen | 3.8-27B | Gewichte / geeigneter Serving-Dienst | Artefakt, Runtime und Quantisierung |
Die Gewichte von DeepSeek V4.1 Flash stehen unter MIT, Qwen3.8-27B unter Apache 2.0. Diese konkrete Lizenzangabe ersetzt keine Prüfung anderer Varianten. „Offen“ beschreibt hier die Verfügbarkeit der Gewichte, nicht sämtliche Trainingsdaten oder automatisch kostenfreien Betrieb. [7, 8]
Ollama gehört zur Ausführung
Ollama ist kein weiteres Basismodell. Die Software verwaltet und startet Modelle und bietet eine API. Ein sinnvoller Vergleich lautet daher GPT-6.1 Sol gegen einen exakt benannten Qwen- oder DeepSeek-Checkpoint, ausgeführt mit einer dokumentierten Ollama-Version. Modelltag, Quantisierung und Kontext gehören ins Protokoll. Zusätzlich unterstützt Ollama Cloud-Funktionen; der Produktname allein belegt keinen rein lokalen Datenweg. [9]
Eine brauchbare Vorauswahl
Für anspruchsvolle Cloud-Aufgaben bilden Astra und Opus einen sinnvollen Kandidatenkreis; Sol und Sonnet ergänzen den Vergleich bei knapperem Budget. Gemini ist besonders bei gemischten Eingaben prüfenswert. Das ist eine redaktionelle Vorauswahl nach dokumentiertem Funktionsumfang, kein gemessener Qualitätsvorsprung. Für lokalen Betrieb ist ein kleinerer Qwen-Checkpoint meist der praktischere Ausgangspunkt als ein vollständiges DeepSeek-Großmodell.
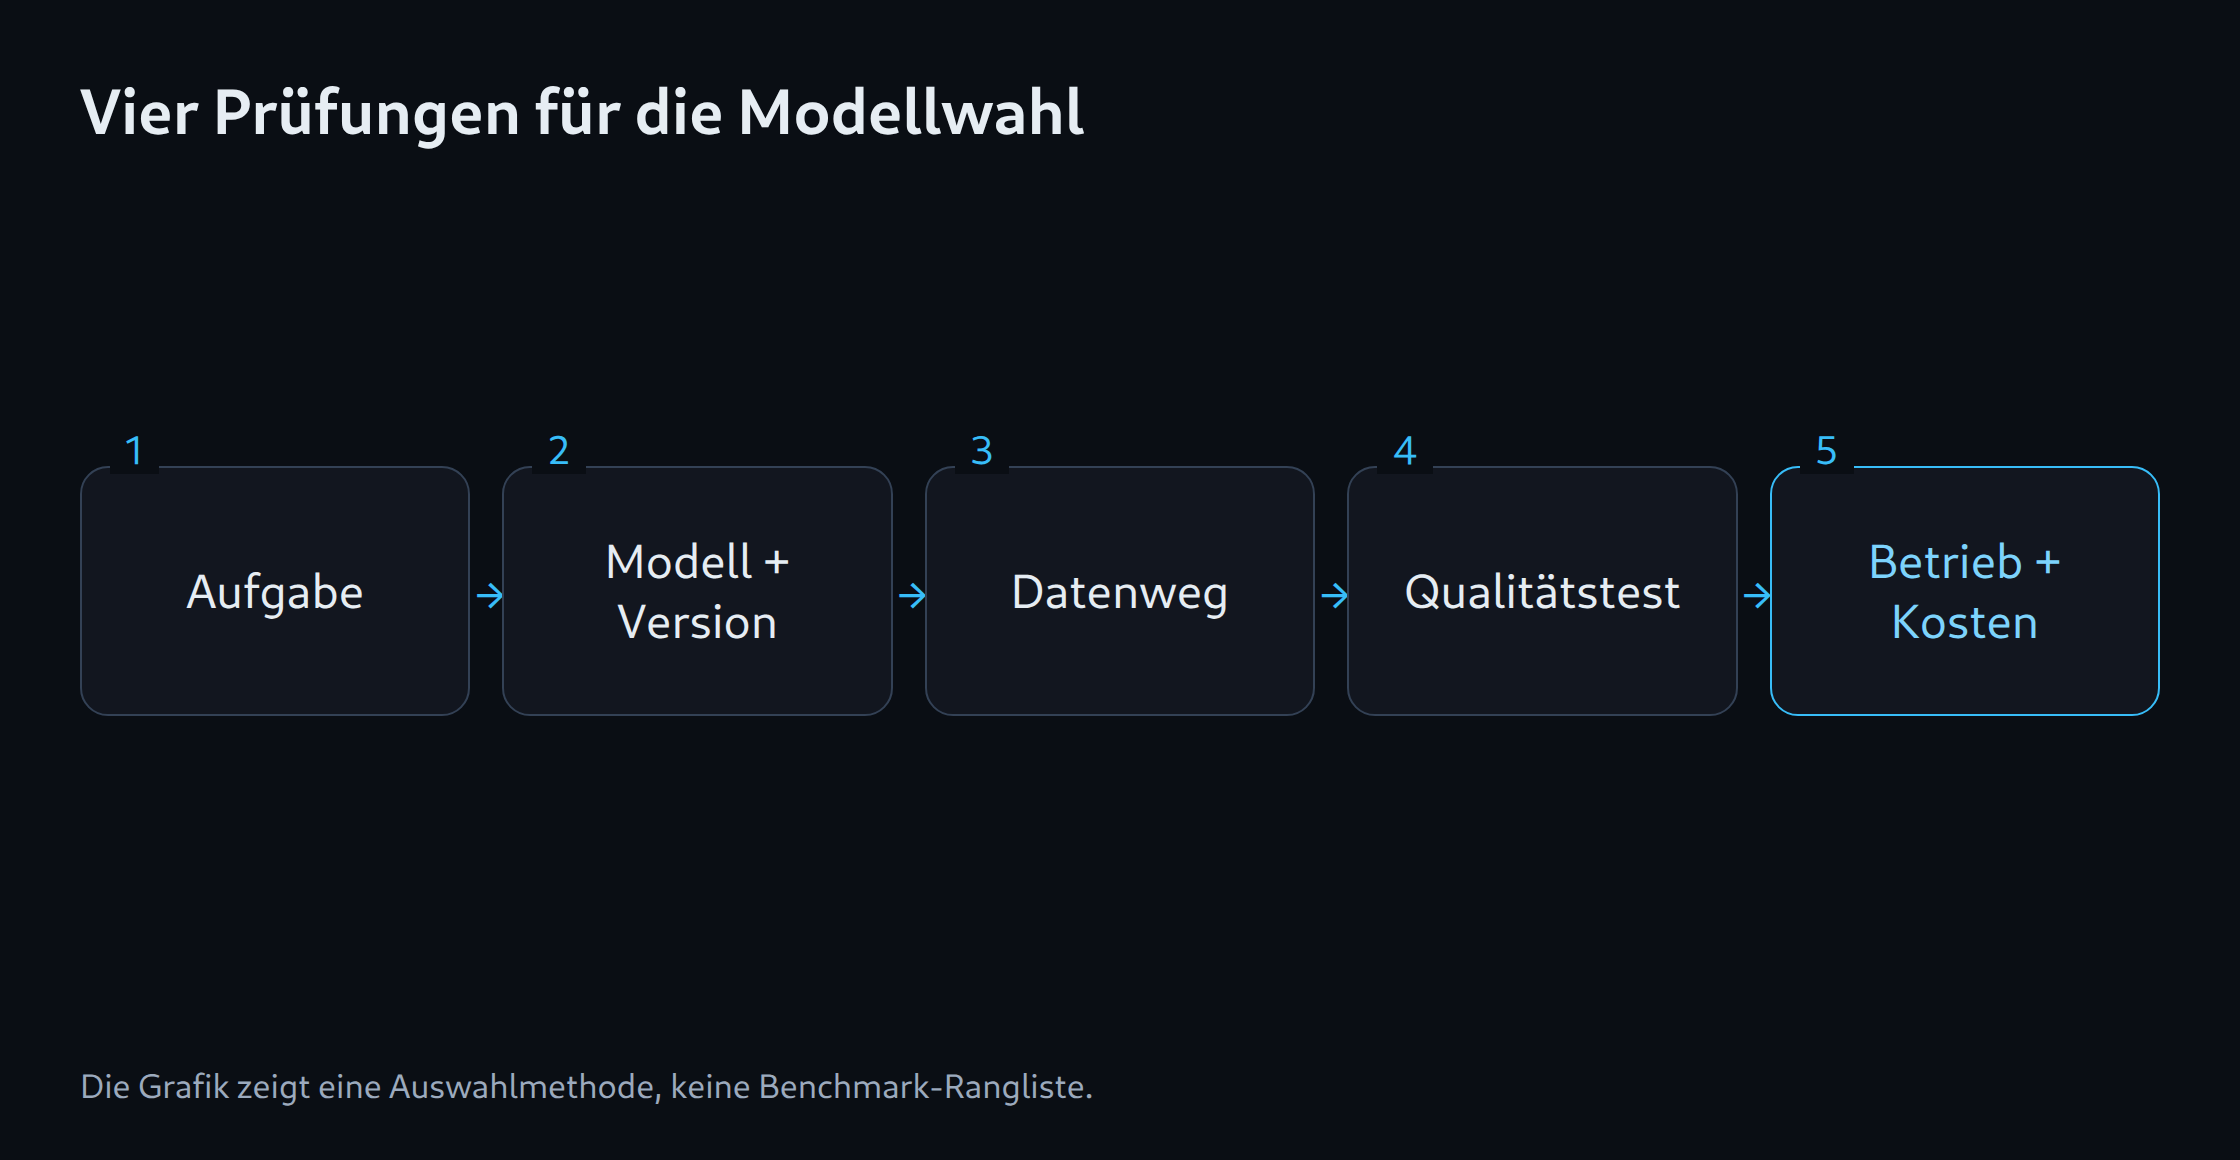
Ein Pilot umfasst dieselben Aufgaben, eindeutige Akzeptanzkriterien und mehrere Wiederholungen. Getrennt erfasst werden Fehler, Nachbearbeitung, Laufzeit und Kosten. Der Modellvergleich endet dadurch bei der passenden Kombination aus Qualität, Datenweg und Betrieb statt bei einer einzigen vermeintlich besten Marke.
Passende Werkzeuge
Fragen und Antworten
Ist Ollama ein Konkurrent von GPT oder Claude?
Ollama ist eine Laufzeit und Modellverwaltung. Vergleichbar sind konkrete Modelle samt Betriebsbedingungen; die Software allein besitzt keine eigene Modellqualität.
Sind offene Modelle automatisch lokal einsetzbar?
Herunterladbare Gewichte schaffen eine Voraussetzung. Architekturunterstützung, Speicher, Quantisierung und Lizenz bleiben eigenständige Prüfungen.
Quellen
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
Quellen geprüft: 6. Oktober 2026.
Passend dazu