English
 Deutsch
 Polski
Zautomatyzowane raportowanie korporacyjne: Generowanie PDF z Pythonem i OpenAI API

Spis treści
Ręczne tworzenie tygodniowych lub miesięcznych raportów biznesowych pochłania znaczne zasoby administracyjne i jest podatne na błędy ludzkie. Połączenie możliwości przetwarzania danych języka Python z API OpenAI umożliwia stworzenie w pełni zautomatyzowanych, inteligentnych raportów w formacie PDF. Surowe dane z baz lub plików CSV są przekształcane w ustrukturyzowane kluczowe wskaźniki efektywności (KPI), podczas gdy duży model językowy (LLM) formułuje precyzyjne, analityczne podsumowanie menedżerskie. Zautomatyzowany potok gwarantuje spójne i terminowe dostarczanie raportów.
1. Architektura rozwiązania: Zautomatyzowany potok raportowania
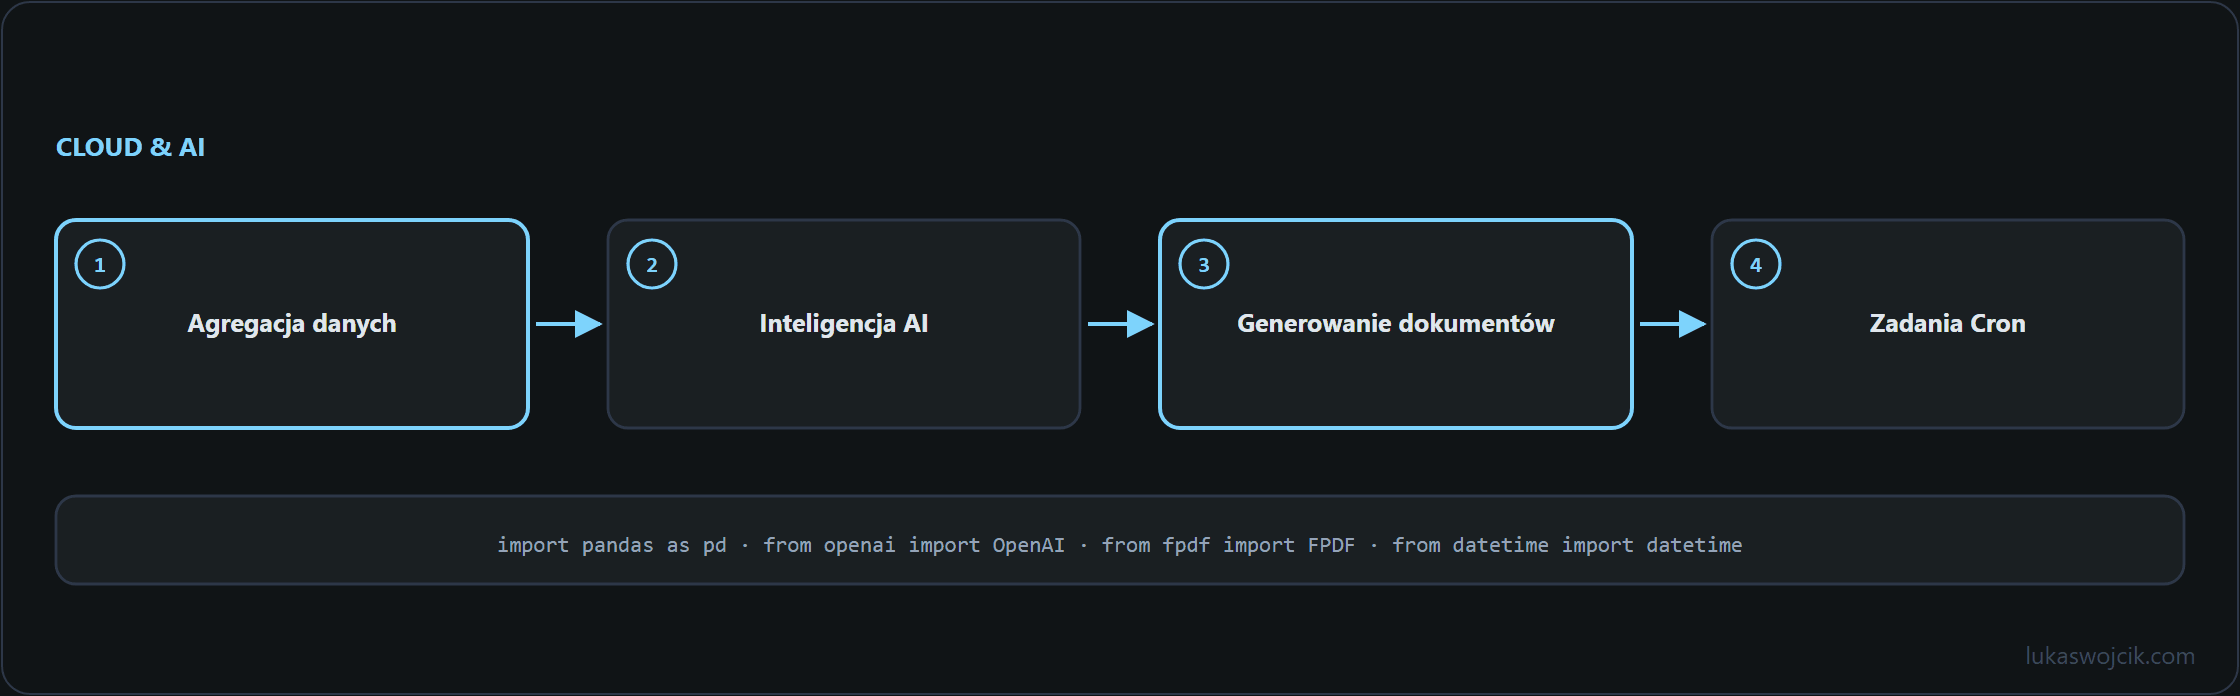
Profesjonalny system automatycznego raportowania opiera się na trzystopniowej architekturze technicznej:
- Agregacja danych (Pandas): Surowe metryki są pobierane z systemów źródłowych, czyszczone i agregowane do głównych wskaźników KPI.
- Inteligencja AI (OpenAI API): Zagregowane metryki są przekazywane do modelu LLM (np.
gpt-4o) poprzez rygorystyczną strukturę monitu w celu wygenerowania czytelnego, analitycznego podsumowania dla zarządu. - Generowanie dokumentów (FPDF / ReportLab): Dane liczbowe oraz tekst wygenerowany przez AI są kompilowane i renderowane w sformatowany dokument PDF zgodny z identyfikacją wizualną firmy.
2. Wdrożenie w języku Python krok po kroku
W celu skonfigurowania potoku raportowania wymagana jest instalacja odpowiednich bibliotek (pandas, openai, fpdf). Poniższy skrypt w języku Python demonstruje pełny proces od pobrania danych po końcowy zapis pliku PDF:
import pandas as pd
from openai import OpenAI
from fpdf import FPDF
from datetime import datetime

# 1. Agregacja danych za pomocą Pandas
# W środowisku produkcyjnym dane są zazwyczaj pobierane z SQL lub hurtowni danych
data = {'Metric': ['Przychody', 'Nowe Leady', 'Wskaźnik Rezygnacji'], 'Value': [145000, 850, '1.2%']}
df = pd.DataFrame(data)

przychody_val = df.loc[df['Metric'] == 'Przychody', 'Value'].values[0]
leady_val = df.loc[df['Metric'] == 'Nowe Leady', 'Value'].values[0]

# 2. Generowanie podsumowania menedżerskiego AI
client = OpenAI()  # klucz jest odczytywany ze zmiennej środowiskowej OPENAI_API_KEY

prompt = f"""
Działaj jako starszy analityk biznesowy. Napisz zwięzłe podsumowanie wykonawcze (maks. 3 zdania)
na podstawie poniższych tygodniowych KPI. Oceń wyniki w sposób neutralny.
Przychody: {przychody_val} PLN
Nowe Leady: {leady_val}
Wskaźnik Rezygnacji: 1.2%
"""

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": prompt}]
)
ai_summary = response.choices[0].message.content

# 3. Generowanie dokumentu PDF
pdf = FPDF()
pdf.add_page()
pdf.set_font("Arial", 'B', 16)

# Nagłówek dokumentu
current_date = datetime.now().strftime("%Y-%m-%d")
pdf.cell(200, 10, txt=f"Zautomatyzowany Raport Tygodniowy - {current_date}", ln=True, align='C')
pdf.ln(10)

# Wstawianie wskaźników KPI
pdf.set_font("Arial", 'B', 12)
pdf.cell(200, 10, txt="Kluczowe wskaźniki efektywności (KPI):", ln=True)
pdf.set_font("Arial", '', 12)
for index, row in df.iterrows():
    pdf.cell(200, 10, txt=f"- {row['Metric']}: {row['Value']}", ln=True)
pdf.ln(10)

# Wstawianie podsumowania AI
pdf.set_font("Arial", 'B', 12)
pdf.cell(200, 10, txt="Podsumowanie Menedżerskie (Generowane przez AI):", ln=True)
pdf.set_font("Arial", '', 12)
pdf.multi_cell(0, 10, txt=ai_summary)

# Eksport pliku
pdf.output("Automated_Weekly_Report.pdf")
3. Automatyzacja harmonogramu krok po kroku
Gdy skrypt działa bezbłędnie, ręczne wykonywanie staje się zbędne. Potok da się w pełni zautomatyzować przy użyciu systemowych harmonogramów zadań:
- Zadania Cron (Linux/macOS): Dodanie wpisu poprzez
crontab -eumożliwia wykonanie skryptu w każdy poniedziałek o godzinie 08:00 (np.0 8 * * 1 /usr/bin/python3 /sciezka/do/skryptu.py). - Wykonanie w chmurze (Cloud Execution): W środowiskach korporacyjnych skrypt może zostać wdrożony jako Google Cloud Function lub AWS Lambda i uruchamiany przez Cloud Scheduler.
- Dystrybucja e-mail: Rozszerzenie skryptu Python o bibliotekę
smtplibpozwala na automatyczne dołączanie wygenerowanego pliku PDF i wysyłanie go na zdefiniowaną listę mailingową zarządu.
4. Podsumowanie i wartość architektoniczna
Co da się osiągnąć dzięki temu poradnikowi: Pomyślne wdrożenie zautomatyzowanego potoku raportowania, który dynamicznie agreguje surowe metryki bazodanowe, wzbogaca je o podsumowanie menedżerskie wygenerowane przez sztuczną inteligencję za pośrednictwem API OpenAI i generuje gotowy dokument PDF.
Wynikająca z tego wartość: Wielogodzinna, ręczna praca z arkuszami kalkulacyjnymi zostaje trwale wyeliminowana. Osoby decyzyjne natychmiast po zakończeniu cyklu raportowania otrzymują wysoce precyzyjne, spójnie sformatowane analizy. Przeniesienie obciążenia z ręcznego zestawiania danych na zautomatyzowaną ewaluację AI pozwala na uwolnienie zasobów przedsiębiorstwa do realizacji krytycznych inicjatyw strategicznych.
Pytania i odpowiedzi
Dlaczego generowanie PDF przerywa się, gdy tylko podsumowanie zawiera polskie litery albo znak euro?
Bo wbudowane czcionki FPDF, takie jak Arial, znają tylko 8-bitowy zestaw znaków, w zasadzie Latin-1. Niemieckie umlauty się w nim mieszczą, ale znak euro, litery takie jak ł, ą czy ę, typograficzne cudzysłowy i półpauza już nie. W polskiej wersji skryptu problem jest niemal pewny: monit jest po polsku, więc model pisze podsumowanie z polskimi znakami, a zależnie od wersji biblioteki przebieg kończy się wtedy błędem kodowania.
Rozwiązaniem jest czcionka TrueType obsługująca Unicode, na przykład DejaVu Sans, dołączona przez add_font() i ustawiona zamiast Arial. W utrzymywanej bibliotece fpdf2 jest to proste; starszy pakiet fpdf w PyPI nie jest już rozwijany. Oba importuje się przez from fpdf import FPDF, dlatego w skrypcie różnicy nie widać.
Jak nie dopuścić, by podsumowanie podawało liczby, których nie ma w danych?
Całkowicie wykluczyć się tego nie da, da się to jedynie wychwycić. Model językowy formułuje tekst, a nie liczy niezawodnie, i zdanie w rodzaju „wzrost o 12% względem poprzedniego tygodnia” może się pojawić, choć żadnej wartości porównawczej nie przekazano. Ryzyko zmniejszają trzy środki:
- Przekazywanie wyłącznie gotowych wartości. Zmiany wobec poprzedniego tygodnia oblicza Pandas i wpisuje je do monitu; model ma je opisać, a nie wyprowadzać.
- Dołączanie wartości porównawczych. Skrypt przekazuje tylko wartości jednego tygodnia; bez poprzedniego okresu albo celu ocena nie ma podstaw, a to, co model o tym napisze, jest zgadywaniem.
- Sprawdzenie odpowiedzi, zanim trafi do PDF. Krótkie porównanie wyciąga z tekstu wszystkie liczby i zestawia je z przekazanymi; jeśli któraś się tam nie pojawia, raport wychodzi ze stałym fragmentem tekstu zamiast podsumowania albo zostaje wstrzymany.
Trzeci krok jest najważniejszy, bo jako jedyny nie zależy od tego, czy model trzyma się poleceń.
Źródła
Powiązane artykuły