English
 Deutsch
 Polski
AI-Modelle fürs Coding: GPT und Claude gegen DeepSeek und Qwen

Inhalt
Ein Coding-Modell liefert erst dann Nutzen, wenn eine Änderung im bestehenden Projekt funktioniert. Kurze Codebeispiele, Repository-Reparaturen und mehrstufige Agentenarbeit sind unterschiedliche Aufgaben. Der Vergleich vom 6. Oktober 2026 betrachtet GPT-6 Astra und 6.1 Sol, Claude Opus und Sonnet 5.5, Gemini 3.8 Flash sowie DeepSeek V4.1 Flash und Qwen3.8-27B.
Cloud-Kandidaten und offene Gewichte
Die dokumentierten Cloud-Modelle bieten Textverarbeitung und Werkzeuganbindung. OpenAI positioniert Astra für anspruchsvolle Aufgaben; Anthropic beschreibt Opus 5.5 ausdrücklich für längere agentische Coding-Abläufe. Gemini 3.8 Flash dokumentiert unter anderem Funktionsaufrufe und Codeausführung. Diese Produktmerkmale liefern Kandidaten für einen Test, aber keine direkt vergleichbare Erfolgsquote. [1, 4, 6]
DeepSeek und Qwen veröffentlichen Modellgewichte. Qwens Modellkarte nennt mehrere Serving-Engines und dokumentiert die Bedingungen der veröffentlichten Coding-Evaluationen. Ein lokaler Qwen-Lauf mit anderer Quantisierung und anderem Agentenframework reproduziert diese Bedingungen nicht automatisch. [7, 8]
Was der Vergleich messen sollte
| Aufgabe | Cloud: GPT / Claude / Gemini | Offen: DeepSeek / Qwen |
|---|---|---|
| Kleine Funktion | API-Latenz und korrekte Ausgabe | Startzeit und lokale Latenz |
| Repository-Fehler | Patch plus bestandene Tests | Gleiche Tests, exakt benannter Checkpoint |
| Agentenarbeit | Werkzeugschritte und Gesamtkosten | Framework, Speicher und Abbrüche |
| Review | Relevante Fehler statt Textmenge | Gleiche Fehlerliste und Fehlalarme |
Ein konkreter Repository-Test
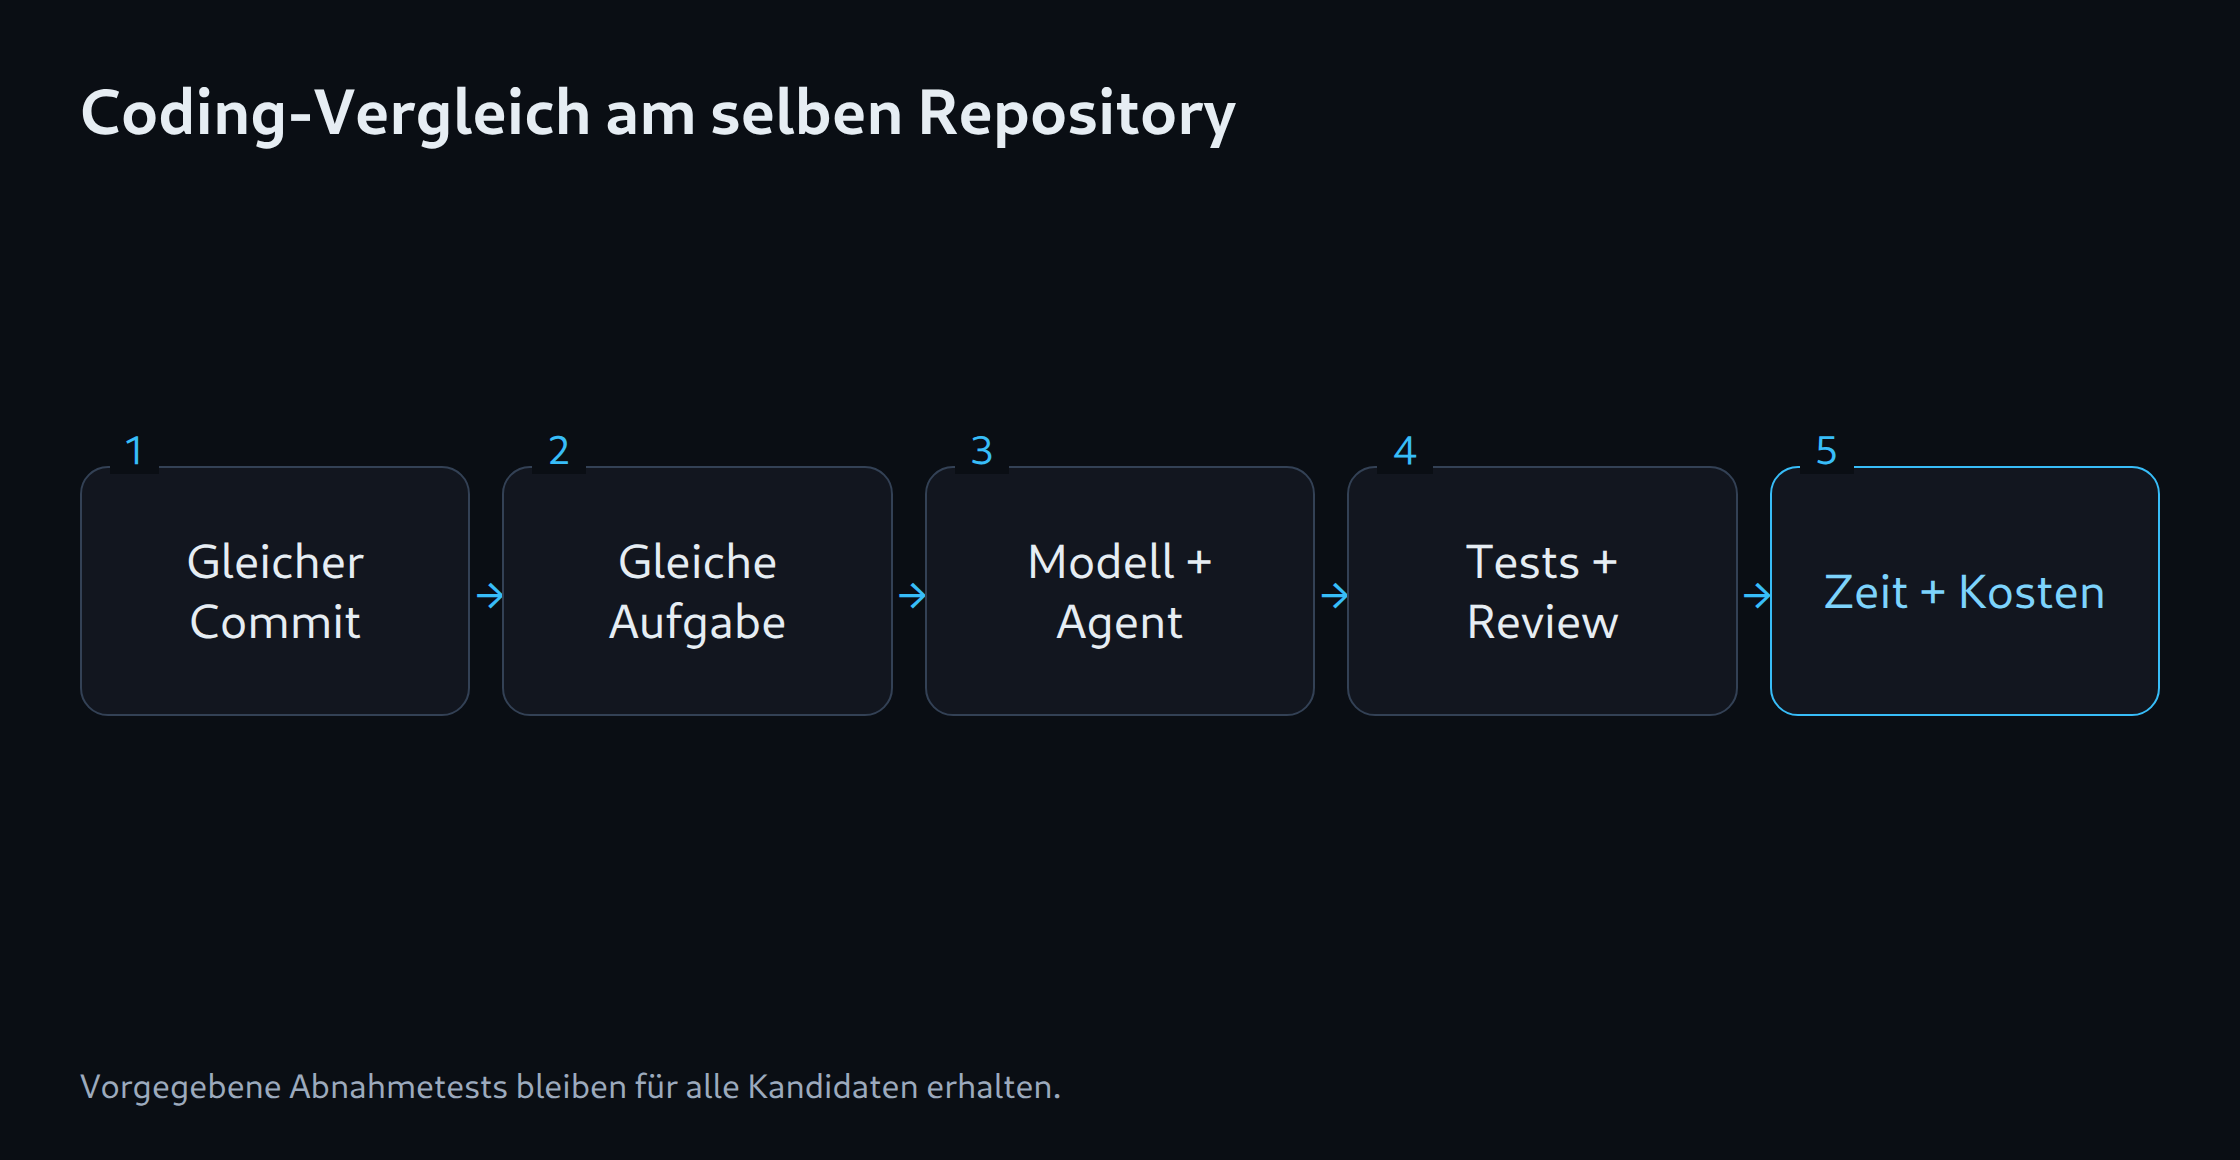
Als redaktionelles Prüfprotokoll dienen sechs Aufgaben: ein reproduzierbarer Bug, eine kleine neue Funktion, eine API-Anpassung, ein Refactoring, eine Testergänzung und ein Review mit bekannten Fehlern. Jeder Durchlauf beginnt vom selben Commit. Abnahmetests bleiben vorgegeben; ein Modell darf den Testumfang nicht verkleinern, um eine Änderung scheinbar erfolgreich abzuschließen.
Erfasst werden bestandene Aufgaben, neue Regressionen, unnötige Dateien, verbrauchte Tokens und Minuten bis zum geprüften Ergebnis. Wiederholungen helfen, einen zufälligen Treffer von verlässlicher Arbeitsqualität zu unterscheiden. Ergebnisse aus unterschiedlichen Agentenoberflächen erhalten zusätzlich einen gesonderten Systemvergleich.
Wann lokal besonders sinnvoll ist
Eine lokale Qwen-Variante ist prüfenswert, wenn Code im eigenen Betrieb bleiben soll und die vorhandene Hardware den gewünschten Kontext trägt. Ollama vereinfacht den Ausführungsweg, ersetzt jedoch weder Architekturunterstützung noch korrekte Werkzeugintegration. Bei DeepSeek gehört die vollständige Modellgröße in die Planung; wenige aktive MoE-Parameter sind kein Beleg für einen ebenso kleinen Speicherbedarf. [7, 9]
Für schwierige Änderungen bleiben Cloud-Modelle mögliche Eskalationskandidaten. Der Wechsel folgt einer dokumentierten Fehlergrenze statt einer Markenpräferenz. Dieser Artikel beschreibt den Vergleichsaufbau; konkrete Erfolgsraten benötigen tatsächlich ausgeführte Tests.
Passende Werkzeuge
Fragen und Antworten
Ist eine hohe Coding-Benchmarkzahl genug?
Zusätzlich zählen Testbedingungen, Agentenframework, Wiederholungen und tatsächliche Repository-Aufgaben. Ein Herstellerscore ersetzt keinen Projekttest.
Bleibt Code mit Ollama automatisch lokal?
Der konkrete Modellaufruf und die eingebundenen Werkzeuge bestimmen den Datenweg. Ollama unterstützt auch Cloud-Funktionen; ein rein lokaler Aufbau muss entsprechend konfiguriert sein.
Quellen
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
Quellen geprüft: 6. Oktober 2026.
Passend dazu