English
 Deutsch
 Polski
Tutorial: Co dociera do page_location i dlaczego fragment nigdy nie trafia na serwer

Spis treści
Adres w pasku przeglądarki wygląda jak jeden ciąg znaków. W drodze do raportu przechodzi przez cztery systemy, a każdy z nich zachowuje inną jego część.
Większość tego jest spodziewana. Jedna część nie: wszystko za krzyżykiem w ogóle nigdy nie dociera do serwera WWW, a do usługi analitycznej dociera w całości – przeciwnie do tego, co zakłada większość, i to rozstrzyga, gdzie lądują trasy aplikacji jednostronicowej.
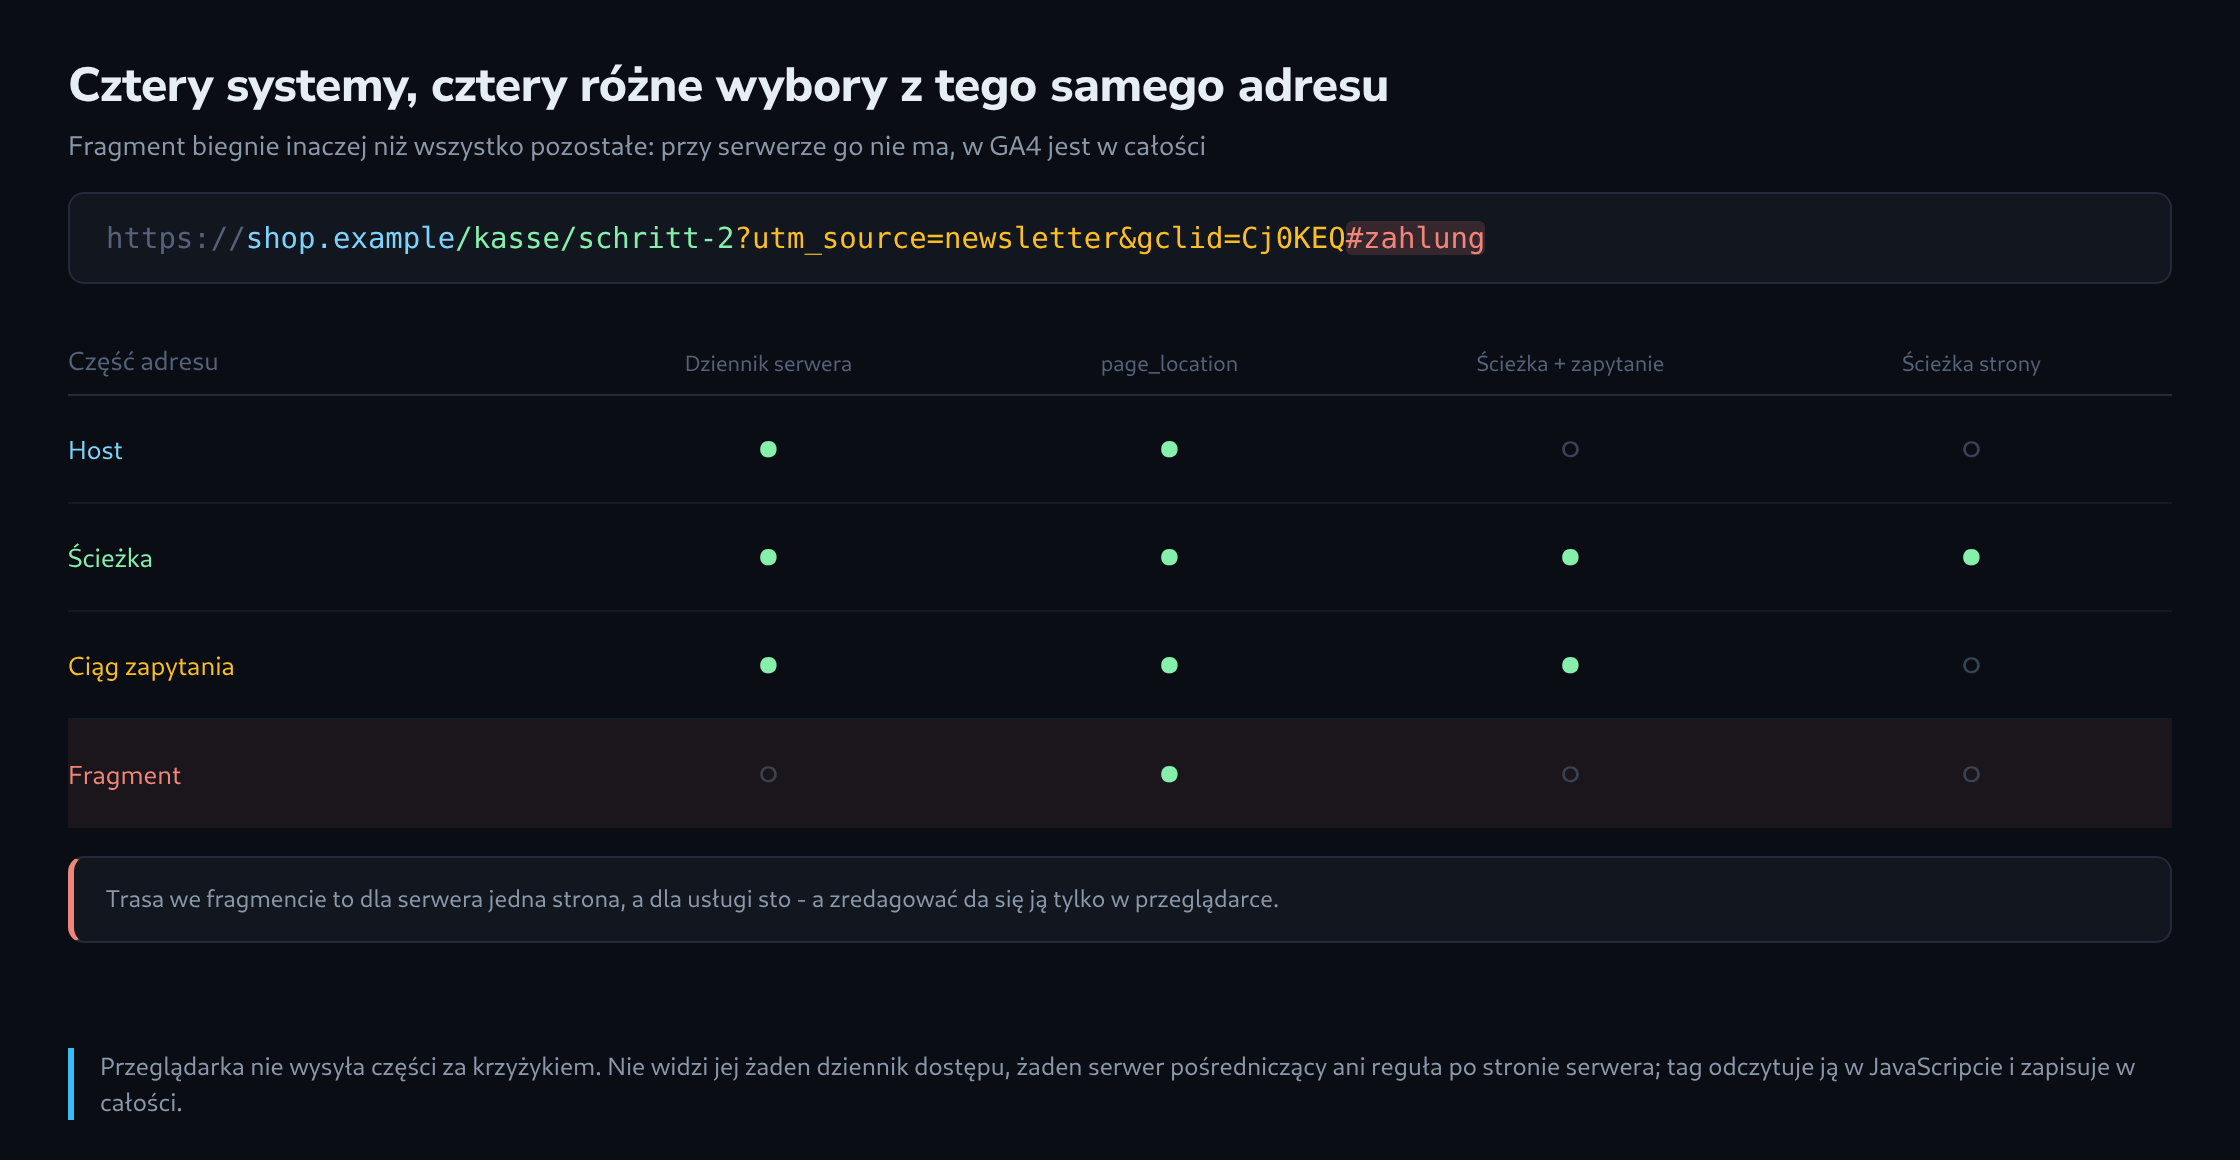
Części adresu i to, kto którą widzi
Adres składa się z pięciu kawałków, a rozdzielniki między nimi są tym, czego szuka parser.
https://shop.example/kasse/schritt-2?utm_source=newsletter&gclid=Cj0KEQ#zahlung
└─┬─┘   └────┬─────┘└──────┬───────┘└─────────────┬──────────────────┘└───┬──┘
Schemat    Host        Sciezka                Zapytanie              Fragment
Serwer WWW dostaje host w nagłówku, a ścieżkę i zapytanie w linii żądania. Fragmentu nie dostaje nigdy, bo przeglądarka go nie wysyła – ta część jest z założenia po stronie klienta i tam pozostaje. Nie widzi jej żaden dziennik dostępu, żaden serwer pośredniczący ani żadna reguła po stronie serwera.
Tag analityczny działa w przeglądarce, czyta document.location.href, a ten ciąg zawiera wszystko łącznie z fragmentem. Wartość w page_location jest przez to pełniejsza niż cokolwiek, co ma serwer.
Fragment i miejsce, w którym ląduje
Liczy się to najbardziej przy aplikacjach kładących nawigację we fragmencie. Ścieżka postaci /#/produkt/42 jest dla serwera jedną stroną – widzi on zawsze tylko / – podczas gdy usługa analityczna dostaje dla każdej trasy własne page_location.
Wynikają z tego trzy rzeczy i ciągną w różne strony.
Pomiar takiej aplikacji po stronie serwera jest bez pomocy niemożliwy: analiza dzienników widzi jedną stronę i sto tysięcy odsłon. To argument za pomiarem po stronie klienta, którego nic innego nie zastępuje.
Redakcja takiej aplikacji po stronie serwera jest równie niemożliwa. Fragmentu z numerem zamówienia albo adresem pocztowym nie usunie żaden serwer pośredniczący, bo nigdy go nie dostaje – jedynym miejscem usunięcia jest przeglądarka, zanim tag odczyta.
A wymiary raportowe traktują go niejednolicie, i to jest część praktyczna.
Co naprawdę zawiera każdy wymiar
GA4 zapisuje jeden parametr i wyprowadza z niego kilka wymiarów – a każde wyprowadzenie coś pomija.
| Wymiar | Zawartość dla powyższego przykładu |
|---|---|
| Adres strony | https://shop.example/kasse/schritt-2?utm_source=…&gclid=…#zahlung |
| Nazwa hosta | shop.example |
| Ścieżka strony i ciąg zapytania | /kasse/schritt-2?utm_source=newsletter&gclid=Cj0KEQ |
| Ścieżka strony | /kasse/schritt-2 |
Fragment pojawia się wyłącznie w pierwszym wierszu. Oznacza to, że raport pogrupowany po ścieżce strony pokazuje dla aplikacji prowadzonej krzyżykiem jeden wiersz, a ten sam raport pogrupowany po adresie strony pokazuje sto – i jedno, i drugie to te same dane.
Ciąg zapytania jest drugą rzeczą wymagającą uwagi. Stoi w dwóch z czterech wymiarów, a każdy parametr w nim staje się częścią wartości: strona osiągnięta z gclid i ta sama strona bez niego to dwa różne wiersze. W witrynie z ruchem kampanijnym samo to rozbija pojedynczą stronę na dziesiątki.
Ograniczenie długości
Większość parametrów zdarzeń w GA4 przyjmuje sto znaków. Adres strony jest przypadkiem szczególnym i przyjmuje tysiąc – hojnie, lecz nie bez granic.
Adres dłuższy zostaje skrócony, a skrócenie jest ciche. Boli dokładnie tam, gdzie adresy stają się długie: filtrowana strona kategorii z ośmioma cechami, wynik wyszukiwania z zapytaniem w adresie oraz aplikacja prowadzona krzyżykiem, której trasa niesie stan.
// sprawdzic przed tagiem, jak dlugi jest adres naprawde
console.log(document.location.href.length,
            document.location.href.slice(0, 120));
Tam, gdzie granica jest prawdziwym ryzykiem, odpowiedź brzmi: skracać celowo, zamiast pozwalać platformie ciąć. Zastępstwo page_location zachowujące ścieżkę i tylko ważne parametry jest zarazem krótsze i pożyteczniejsze, bo usuwa również parametry kampanijne rozbijające stronę na dziesiątki wierszy.
function () {
  var behalten = ["seite", "sortierung", "filter"];
  var u = new URL(document.location.href);
  var neu = new URL(u.origin + u.pathname);

  behalten.forEach(function (name) {
    if (u.searchParams.has(name)) {
      neu.searchParams.set(name, u.searchParams.get(name));
    }
  });
  return neu.href;          // bez fragmentu, bez parametrow kampanijnych
}
Ostrzeżenie co do tej zmiennej: należy ją przypiąć do tagu odsłony i do każdego tagu zdarzenia, inaczej usługa prowadzi dwa różne wyobrażenia tej samej strony. A parametry kampanijne trzeba odczytać, zanim zostaną usunięte – tag konfiguracyjny potrzebuje adresu pierwotnego, inaczej przypisanie znika razem z nimi.
Aplikacje jednostronicowe: odczyt we właściwej chwili
Wczytanie strony odczytuje adres raz. Zmiana trasy w aplikacji nie wczytuje niczego na nowo, więc nikt nie odczytuje go ponownie, dopóki nikomu się tego nie powie.
Powstaje z tego najczęstsza błędna liczba w całym tym obszarze: druga trasa sesji melduje adres pierwszej, bo tag zadziałał, zanim szkielet zaktualizował adres. Kolejność tych dwóch czynności jest właściwością szkieletu, a nie menedżera tagów.
// meldowac dopiero po zmianie adresu, nie przed
(function () {
  var alt = document.location.href;
  ["pushState", "replaceState"].forEach(function (name) {
    var original = history[name];
    history[name] = function () {
      var r = original.apply(this, arguments);
      melde();
      return r;
    };
  });
  window.addEventListener("popstate", melde);
  window.addEventListener("hashchange", melde);

  function melde() {
    if (document.location.href === alt) { return; }
    alt = document.location.href;
    window.dataLayer.push({
      event: "seitenwechsel",
      seite_adresse: document.location.href,
      seite_titel: document.title
    });
  }
})();
Dwa szczegóły w tym fragmencie wykonują prawdziwą pracę. Porównanie z poprzednim adresem tłumi podwójne zdarzenia wytwarzane przez szkielet zastępujący stan bez zmiany trasy. A hashchange stoi osobno, bo sama zmiana krzyżyka nie zawsze idzie przez pushState – i to jest dokładnie przypadek aplikacji prowadzących trasy we fragmencie.
Tytuł warto przekazywać z tego samego powodu co adres: zmienia się po trasie, a tag odczytujący go zbyt wcześnie melduje tytuł poprzedniej strony do ścieżki bieżącej. Taka niezgodna para łatwo rzuca się w oczy w raporcie i bez tej wiedzy trudno ją wyjaśnić.
Rozstrzygnięcie, co należy do raportu
Wszystko powyższe opisuje to, co możliwe. Rozstrzygnięciem jest to, co ma tam stać, a wyjaśniają to trzy pytania.
Które parametry rozróżniają strony, a które jedynie oznaczają, jak ktoś przyszedł. Sortowanie i stronicowanie rozróżniają; gclid, fbclid i zestaw kampanijny nie – a pozostawienie ich w wymiarze strony rozbija każdą stronę wejścia na długi ogon wierszy po jednej odsłonie.
Czy fragment niesie informację, czy położenie. Trasa należy do raportu; kotwica do nagłówka jest szumem, a jedno i drugie wygląda w wartości tak samo.
Oraz czy cokolwiek w środku jest daną osobową. W tym miejscu wcześniejsze pytanie o redakcję wraca z ostrzejszą krawędzią: wartości we fragmencie nie wyłapie żadna reguła na serwerze WWW ani żaden serwer pośredniczący, a zanim opuści urządzenie, usunąć da się ją wyłącznie w przeglądarce – przez co tag jest ostatnią linią, a nie wygodą.
Pytania i odpowiedzi
Czy aplikację prowadzoną krzyżykiem da się przestawić na prawdziwe ścieżki przekierowaniem po stronie serwera?
Nie wyłącznie po stronie serwera. Żądanie /#/produkt/42 dociera do niego jako /, więc serwer nie wie, o którą trasę chodziło, i nie może dobrać pasującego przekierowania. Jeśli przekieruje / hurtowo na nowy adres, przeglądarka sama dołączy fragment z powrotem: standard HTTP stanowi, że cel przekierowania bez własnego fragmentu dziedziczy fragment adresu pierwotnego. Z /#/produkt/42 powstaje więc /app/#/produkt/42, a nie /app/produkt/42.
Przełożenie starych tras musi zatem nastąpić w przeglądarce: niewielki skrypt odczytuje location.hash i zastępuje adres nową ścieżką za pomocą history.replaceState albo location.replace. Powinno się to stać, zanim tag analityczny zgłosi pierwszą odsłonę, inaczej każdy stary adres pojawi się jeszcze raz jako osobna odsłona.
W raportach zmiana przerywa szereg czasowy. Wcześniej wszystkie trasy znajdowały się pod jedną ścieżką strony i różniły się tylko adresem strony, później rozkładają się na własne ścieżki. Porównanie okresów sprzed zmiany i po niej wymaga więc przyporządkowania starych fragmentów do nowych ścieżek.
Czy skrypt z artykułu zgłasza także skoki do kotwic na tej samej stronie?
Tak. Kliknięcie kotwicy zmienia document.location.href i wywołuje hashchange, a porównanie z poprzednim adresem przepuszcza zdarzenie, bo adres rzeczywiście się zmienił. Na stronach ze spisem treści każdy skok daje wtedy zmianę trasy. Zapobiega temu dodatkowy warunek, który liczy fragment tylko wtedy, gdy niesie trasę, na przykład gdy zaczyna się od #/.
Czy kontener po stronie serwera widzi fragment?
Tak, ale inną drogą niż serwer WWW. Kontener nie dostaje żądania strony, tylko żądanie pomiarowe tagu, a w nim page_location jako wartość, łącznie z fragmentem, dokładnie tak, jak tag odczytał ją z document.location.href. Tam wartość da się przepisać albo skrócić, zanim trafi dalej do usługi analitycznej.
Dla danych osobowych we fragmencie niewiele to zmienia: gdy kontener je usuwa, opuściły już przeglądarkę i dotarły na własny serwer, gdzie zależnie od konfiguracji mogą trafić także do dzienników. Jeśli wartość w ogóle nie ma opuścić urządzenia, nadal trzeba ją usunąć w przeglądarce, zanim tag ją odczyta.
Źródła
Powiązane artykuły