

 English
 Deutsch
 Polski
Die Evolution des Web-Trackings: Von Logfiles zur serverseitigen Zukunft
Teil 1 von 5 der Reihe Vom Pixel zum Server: Tracking, das hält

Management Summary
Web-Tracking erfasst die Nutzung von Websites, um Inhalte, Angebote und Werbung auszuwerten. Aus Serverprotokollen entwickelten sich zusätzliche Messungen im Browser und Daten aus Geschäftssystemen, etwa bestätigte Bestellungen. Der Beitrag erklärt, warum diese Verfahren nebeneinander bestehen: Jede Quelle erfasst einen anderen Teil des Geschehens. Das hilft bei der Einordnung von Berichten und der Auswahl passender Daten. Ein Server ersetzt weder fehlende Beobachtungen automatisch noch die Datenschutzprüfung.
Inhalt
Web-Analyse hat mehrere Datenquellen: Anfragen im Serverprotokoll, Ereignisse aus dem Browser und Geschäftsvorgänge im Backend, etwa Bestellungen im Serversystem eines Shops. Im Laufe der Zeit kamen neue Verfahren hinzu. Die älteren verschwanden dadurch nicht. Serverseitiges Tracking ergänzt heute häufig die Browsermessung; eine vollständige Rückkehr zu Logdateien ist damit nicht gemeint.
Logdateien: Anfragen zählen, Nutzung einordnen
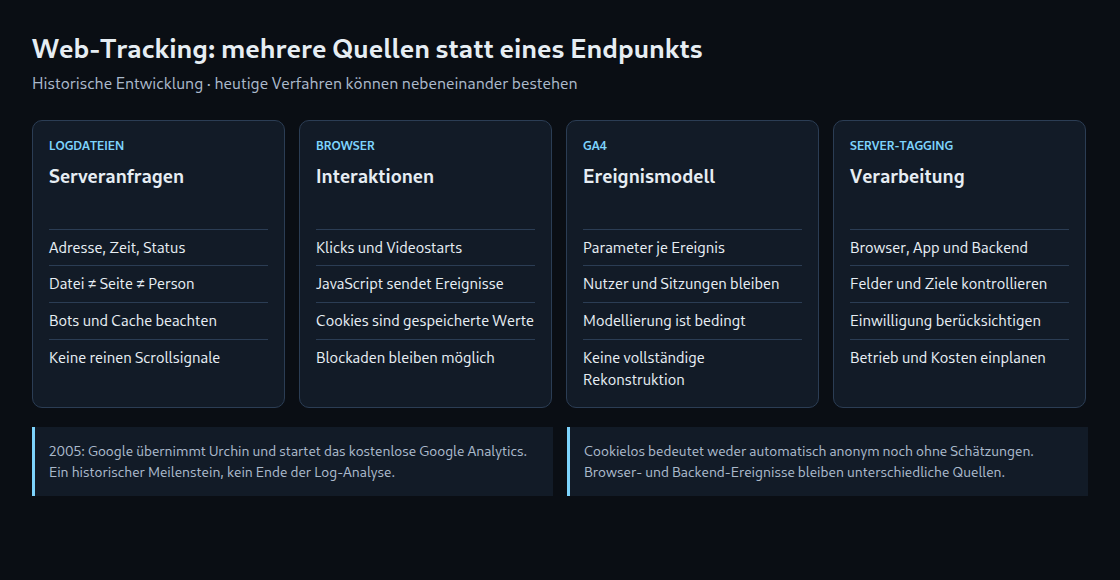
Serverprotokolle waren eine wichtige Grundlage früher Web-Statistiken und bleiben für Betrieb und Fehleranalyse nützlich. Ein Access-Log kann beispielsweise Zeitpunkt, angeforderte Adresse, Antwortstatus und IP-Adresse enthalten. Welche Anfragen und Felder gespeichert werden, bestimmt die Konfiguration.
Eine Anfrage ist jedoch kein Besucher und nicht automatisch ein Seitenaufruf. Eine einzelne Seite lädt oft mehrere Dateien; Bots erzeugen ebenfalls Anfragen. Inhalte aus Browser- oder vorgeschalteten Caches können den Ursprungsserver umgehen. Ein Scrollvorgang ohne zusätzliche Anfrage erscheint dort überhaupt nicht. Log-Analyse braucht deshalb passende Filter und klar definierte Kennzahlen.
Urchin bereitete Web-Daten für Berichte auf. Google übernahm das Unternehmen 2005 und stellte Google Analytics am 14. November 2005 kostenlos bereit. Damit wurde eine gehostete Analyse für viele Websites leichter zugänglich.
Browsermessung: Ereignisse zusätzlich erfassen
JavaScript kann Interaktionen wie Videostarts oder Klicks erkennen und als Ereignis senden. Ein Tracking-Pixel bezeichnet je nach Zusammenhang eine Bildanfrage oder allgemeiner einen Messaufruf. Cookies sind gespeicherte Werte, kein ausführbarer Programmcode.
Google Analytics verwendet hauptsächlich First-Party-Cookies, die unter der eigenen Domain der Website gespeichert werden. Eine Verbindung zu einem fremden Analyseserver ist daher nicht gleichbedeutend mit einem Drittanbieter-Cookie. Universal Analytics wertete Seitenaufrufe, Ereignisse, Nutzer und Sitzungen aus. Die inzwischen eingestellte Produktgeneration dient hier der historischen Einordnung.
Mehrere Anbieter und Betriebsmodelle
Die Entwicklung verlief nicht nur entlang der Google-Produkte. Adobe übernahm Omniture 2009. Webtrekk ging 2019 an Mapp. Matomo hieß bis 2018 Piwik und bietet unter anderem einen Betrieb auf eigener Infrastruktur. Auch etracker gehört zum Spektrum der Web-Analyse.
Für die Auswahl zählen konkrete Funktionen, Datenflüsse, Verträge, Speicherorte und Betriebskosten. Ein europäischer Anbieter, Open Source oder eigenes Hosting allein belegt keine datenschutzkonforme Einrichtung. Maßgeblich sind die aktuelle Einrichtung und die tatsächliche Verarbeitung.
Browser-Schutz und das Ereignismodell von GA4
Safari mit Intelligent Tracking Prevention und Firefox mit Enhanced Tracking Protection begrenzen bestimmte Trackingverfahren. Je nach Browser, Kontext und Einstellung werden beispielsweise Zugriffe blockiert oder Speicherbereiche voneinander getrennt. Daraus folgt kein allgemeines Verbot sämtlicher Cookies.
GA4 organisiert die Erhebung um Ereignisse mit zusätzlichen Parametern. Nutzer- und Sitzungskennzahlen bleiben Teil der Auswertung. Modellierung kann unter bestimmten Voraussetzungen fehlende Informationen statistisch ergänzen: Beobachtete Muster dienen dazu, Werte zu schätzen, für die keine direkte Messung vorliegt. Eine Rekonstruktion aller verlorenen Ereignisse ist damit nicht zugesagt; auch ausreichende Datenmengen garantieren die Eignung einer Property nicht.
Serverseitiges Tagging: ein zusätzlicher Verarbeitungsschritt
Bei serverseitigem Tagging empfängt ein Server Messdaten über eine kontrollierte Empfangsadresse, den sogenannten Endpunkt. Der Server verarbeitet die Ereignisse oder leitet Ereignisdaten weiter. Quellen können Browser, Apps und Backend-Systeme sein. Bei Google Tag Manager wird für den Produktivbetrieb eine eigene First-Party-Domain empfohlen. Eine gemeinsame Hauptdomain ist jedoch keine allgemeine Definition von Server-to-Server-Kommunikation.
Der Nutzen liegt in einem prüfbaren Datenweg: Welche Felder gehen an welches Ziel? Welche Ereignisse werden verworfen? Welche Einwilligung gilt? Eine richtige Konfiguration kann Browserarbeit reduzieren. Zusätzliche Infrastruktur verursacht allerdings Kosten und benötigt Überwachung, Zugriffsschutz und Wartung.
Ein Server erkennt einen reinen Scrollvorgang nicht ohne ein Signal aus dem Browser. Eine bestätigte Bestellung kann dagegen direkt aus dem Bestellsystem kommen. Bei paralleler Browser- und Backend-Übermittlung ist eine passende Deduplizierung nötig. Wird dieselbe Bestellung über beide Wege gemeldet, darf daraus beispielsweise nur ein Kauf statt zwei Käufen entstehen. Blockierte, nicht erhobene oder unzulässige Daten werden durch den Serverweg nicht automatisch verfügbar.
Der Anteil fehlender Ereignisse muss für die konkrete Website untersucht werden. Unterschiedliche Quellen erfassen verschiedene Teile eines Besuchs; eine Abweichung ist deshalb nicht automatisch ein Messfehler. Sinnvoll ist die passende Kombination der Datenquellen mit dokumentierten Grenzen.
Fragen und Antworten
Bedeutet cookielos auch ohne Modellierung?
Nein. „Cookielos“ beschreibt zunächst den Verzicht auf Cookies in einem bestimmten Erhebungsweg. Das sagt noch nichts über andere Kennungen, die Bildung von Sitzungen oder eine spätere statistische Schätzung aus. Auch eine Zuordnung anhand kurzlebiger Anfrage-Merkmale kann ungenau sein. Ein gezähltes Ereignis und eine daraus abgeleitete Personenzahl sind unterschiedliche Aussagen.
Cookielose Erhebung und Modellierung können zusammen vorkommen. Bei GA4 ist zwischen beobachteten und modellierten Berichtswerten zu unterscheiden. Eine fehlende dauerhafte Kennung schränkt die Wiedererkennung ein; ob Kennzahlen zu Rückkehrern möglich sind, hängt von weiteren zulässigen Signalen und der konkreten Methode ab.
Ersetzt ein eigener Server die Datenschutzprüfung?
Nein. Cookielose Verfahren können weiterhin personenbezogene Daten verarbeiten oder unter Regeln zum Zugriff auf Endgeräte fallen. Zweck, Rechtsgrundlage, mögliche Einwilligung und Ausnahmen sind anhand des tatsächlichen Verfahrens zu prüfen. Hashing, First-Party-Domain und eigener Server sind für sich genommen keine Anonymitätsgarantie.
Quellen
- Apache: Zugriffsprotokolle
- Google: Übernahme von Urchin 2005
- Start von Google Analytics am 14. November 2005
- Google Analytics: Cookies und Kennungen
- Google Analytics: Kennzahlen von UA und GA4 vergleichen
- Universal Analytics: Dokumentation des eingestellten Produkts
- Adobe-Geschäftsbericht 2009: Omniture
- Mapp: Übernahme von Webtrekk 2019
- Matomo: Umbenennung von Piwik 2018
- etracker Analytics
- WebKit: Schutz vor Tracking
- Firefox: Enhanced Tracking Protection
- GA4: Verhaltensmodellierung
- Serverseitiges Tagging: Einführung
- Serverseitiges Tagging: eigene Domain
- Serverseitiges Tagging: Überblick
- EDSA-Leitlinien 2/2023, Version 2.0
Vom Pixel zum Server: Tracking, das hält
- Die Evolution des Web-Trackings: Von Logfiles zur serverseitigen Zukunft
- GA4 & Server-Side GTM: Die “Migrate from JavaScript Managed Client ID” Funktion in GA4 erklärt
- Server-Side GTM auf GCP Cloud Run: Architektur, Auto-Scaling und Kostenoptimierung
- GA4 Measurement Protocol: Serverseitige CRM-Offline-Conversion-Integration
- Meta Conversions API: Maximierung der Event Match Quality (EMQ) und Deduplizierung
Passend dazu


