English
 Deutsch
 Polski
Filtr nazwy hosta w GA4: usuwanie spamu z Measurement Protocol i właściwa kolejność kroków

Spis treści
Identyfikator pomiaru stoi w kodzie źródłowym każdej strony, która go używa. Kto odczyta go stamtąd, może wysyłać trafienia wprost do punktu zbiorczego, nigdy nie otwierając witryny – punkt zbiorczy, do którego wysyła też tag w przeglądarce, nie wymaga dowodu, że wizyta się odbyła; Measurement Protocol wymagałby dodatkowo klucza api_secret, którego nie ma w kodzie źródłowym. Trafienia te pojawiają się potem w raportach jak wizyty, a nazwa hosta w nich jest dowolnie zmyślona.
Od 11 czerwca 2026 istnieje przeciw temu narzędzie w sekcji administracyjnej: filtr nazwy hosta, nowy rodzaj filtra danych wykluczający zdarzenia na podstawie ich nazwy hosta. Pomaga, ale ma dwie właściwości, które warto znać przed włączeniem.
Skąd biorą się obce nazwy hostów
Każde zdarzenie docierające do GA4 niesie nazwę hosta – domenę, z której rzekomo pochodzi. Przy prawdziwej wizycie ustawia ją przeglądarka i jest prawdziwa. Przy trafieniu wysłanym wprost ustawia ją nadawca, i wtedy stoi tam to, co wpisał.
Zwykłym przypadkiem jest tępa reklama: nazwa hosta przypominająca cudzą domenę, umieszczona w nadziei, że ktoś zobaczy ją w raporcie i sprawdzi. Przypadkiem uciążliwym jest rozsiew, bo tacy nadawcy rozdzielają często ten sam identyfikator na wiele zbiorów. W obu razach szkodą nie jest treść, lecz rozwodnienie: współczynniki konwersji spadają, bo rośnie mianownik, a raporty kanałów dostają wiersze, których nikt nie umie umiejscowić.
Dwa pozostałe stopnie są domowej roboty
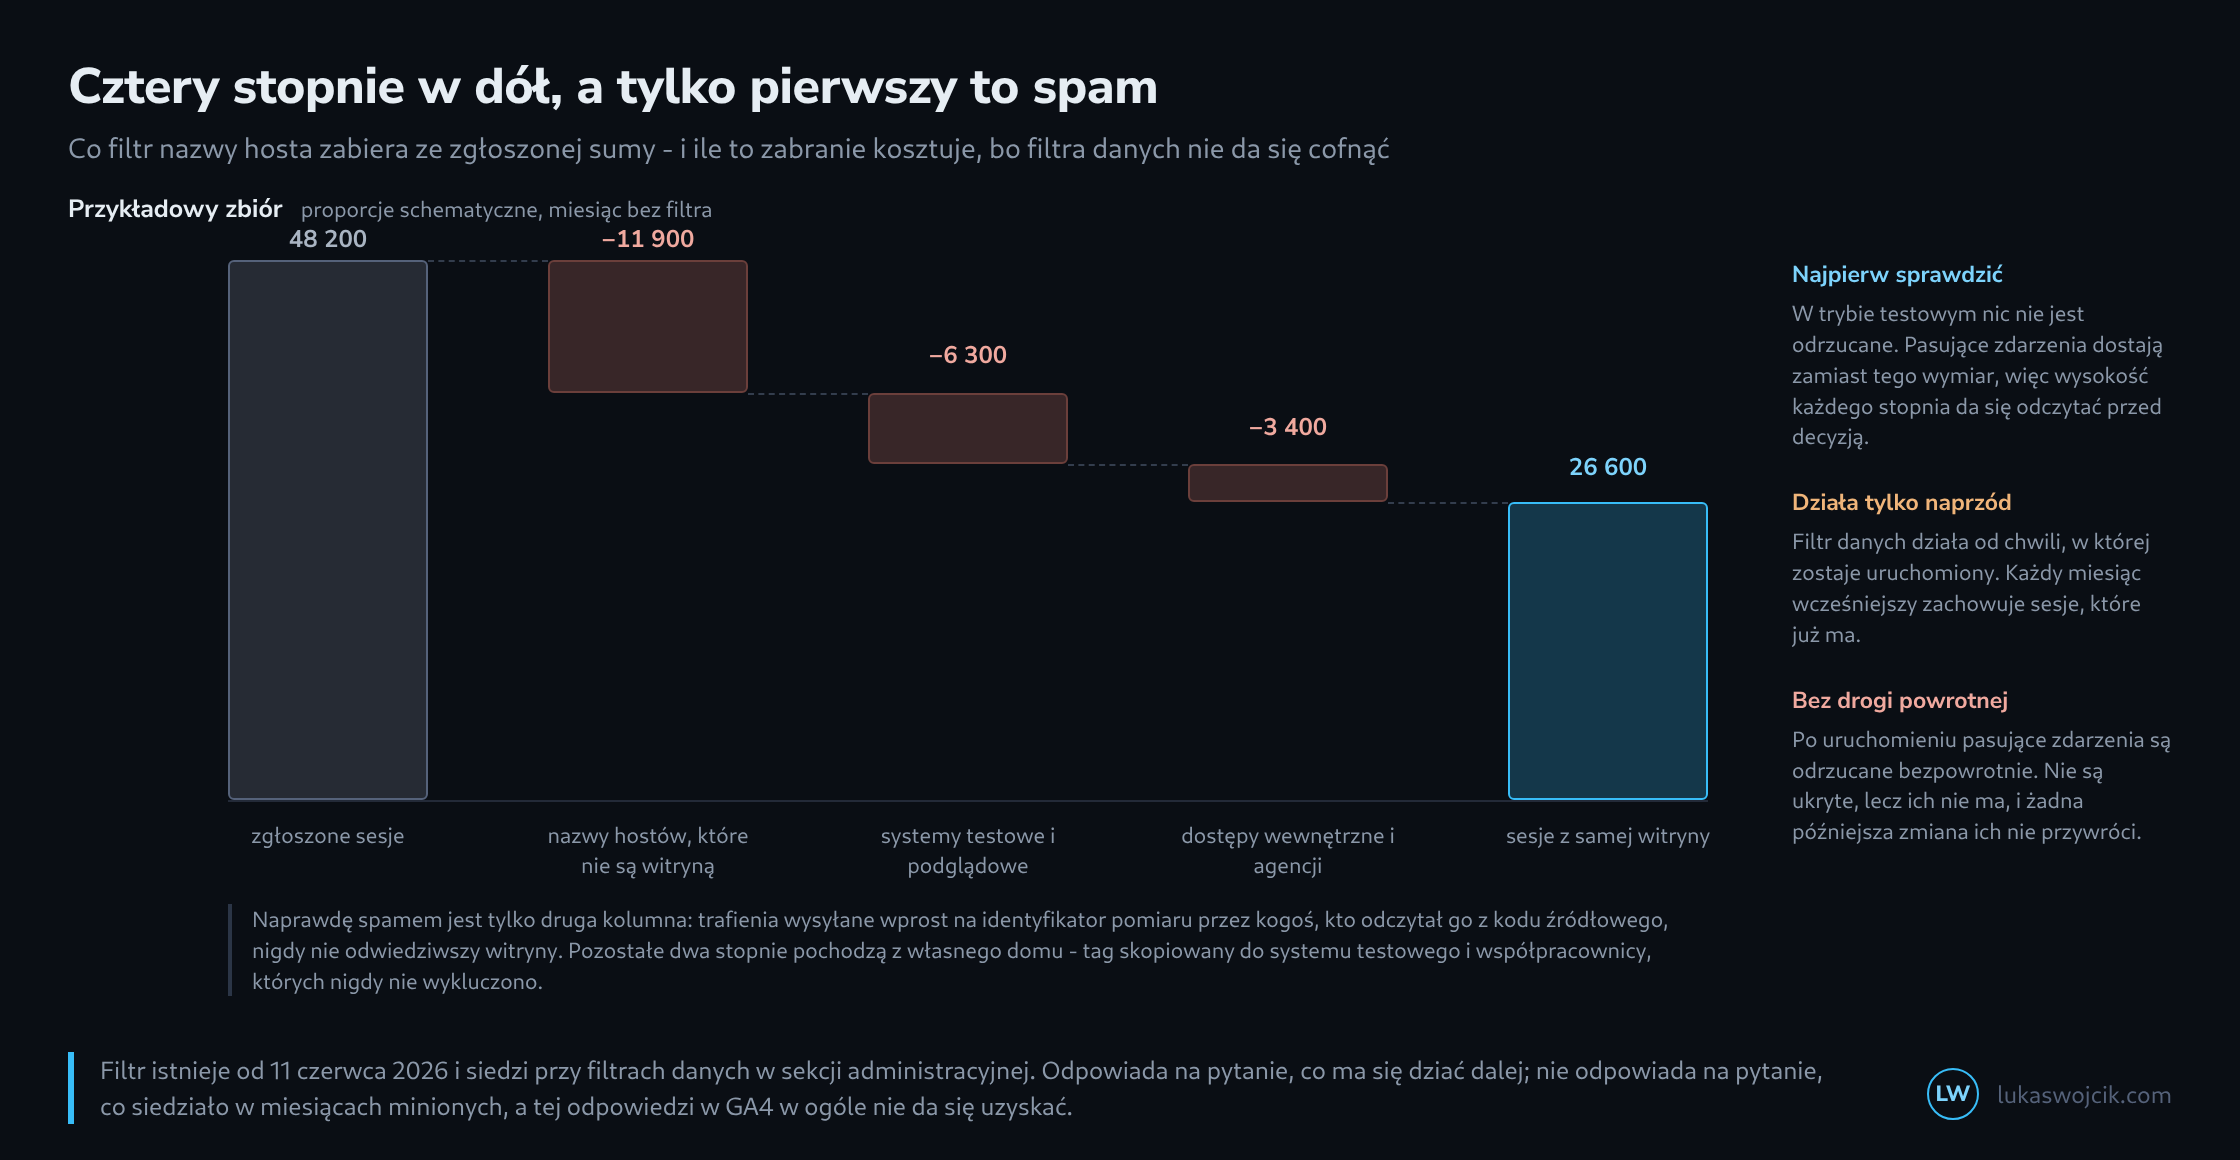
W praktyce spam rzadko bywa największą pozycją. Częstsze są dwa inne źródła. Pierwsze to środowisko testowe: gdy witryna zostaje sklonowana na potrzeby prac, kontener wędruje razem z nią i odtąd system pod nazwą w rodzaju test.przyklad.pl melduje sesje do tego samego zbioru. Drugie to dostępy wewnętrzne – redakcja, agencja, przebiegi kontrolne – których nigdy nie wykluczono.
Oba wyglądają w raporcie jak ruch prawdziwy, bo są ruchem prawdziwym. Tylko nie tym, o który chodzi. Filtr nazwy hosta chwyta pierwsze z tych źródeł pewnie, bo nosi ono własną nazwę; drugie nadal wymaga filtra po pochodzeniu albo oznaczenia w kontenerze.
Właściwość pierwsza: filtr działa tylko naprzód
Filtr danych chwyta od chwili, w której zostaje uruchomiony. Wszystko zebrane wcześniej stoi w raportach dokładnie tak, jak stało. To nie jest ograniczenie, które dałoby się obejść – GA4 nie zna filtrowania istniejącego zbioru po fakcie.
Praktycznie oznacza to stopień w każdym szeregu czasowym sięgającym poza dzień włączenia. Kto uruchomi filtr we wtorek, ma od środy mniej sesji, a żaden raport nic o tym nie mówi. Tam, gdzie liczy się porównywalność, ten dzień należy odnotować, najlepiej tam, gdzie notuje się też kampanie.
Właściwość druga: nie ma drogi powrotnej
Uruchomiony filtr danych odrzuca pasujące zdarzenia bezpowrotnie. Nie są ukrywane i nie leżą w koszu – nie wchodzą do zbioru. Filtr zakreślony zbyt szeroko usuwa więc po cichu i trwale dane prawdziwe, a błąd wychodzi na jaw być może dopiero po tygodniach.
Właśnie po to jest tryb testowy i to jest właściwy powód, by ten filtr w ogóle polubić. W trybie testowym nic nie jest odrzucane; pasujące zdarzenia dostają zamiast tego wymiar z nazwą filtra. Pozwala to odczytać przed decyzją, ile filtr by objął – i czy nie ma wśród tego czegoś, co ma zostać.
Kolejność, która oszczędza usunięcia

  1  otworzyć raport z wymiarem nazwy hosta i wypisać wszystkie
     wartości z minionych miesięcy
  2  przypisać każdą nazwę do jednej z czterech grup:
     własna witryna, system testowy, wewnętrzne, obce
  3  założyć filtr w trybie testowym i puścić na tydzień
  4  sprawdzić przez wymiar "Test data filter name", co by
     zostało objęte
  5  dopiero potem uruchomić i odnotować dzień

  Krok 1 waży najwięcej: nazwa hosta, której nikt nie rozpoznaje,
  nie jest jeszcze spamem - strony docelowe, witryny kampanijne
  i systemy sklepowe chodzą często pod własnymi nazwami.
Czego filtr nie robi
Minione miesiące zostają, jakie są. Oczyszczonego szeregu czasowego za dłuższy okres nie da się dostać z interfejsu, a jedynie z eksportu do BigQuery – nazwa hosta stoi tam przy każdym zdarzeniu i tam da się filtrować wstecz, ile razy się zechce.
To jest właściwy podział pracy. Filtr w sekcji administracyjnej dba o to, by od dziś wchodziło mniej bzdur. Na pytanie, ile bzdur siedziało tam wcześniej, nie odpowiada, a dla tego pytania nie ma drogi obok danych surowych.
Od 21 września 2026 filtr nazwy hosta ma dodatkowo tryb Include (informacje o wersjach Google Analytics). Zamiast wykluczać pojedyncze nazwy, przepuszcza wyłącznie zdarzenia z zatwierdzonych domen i dzięki temu zatrzymuje także nazwy hostów ze spamu, które pojawią się dopiero później. Odrzuca przy tym również zdarzenia bez nazwy hosta, a do zdarzeń z Measurement Protocol nie jest stosowany. Co to oznacza dla konfiguracji, opisuje artykuł o trybie Include.
Pytania i odpowiedzi
Dlaczego tydzień w trybie testowym, a nie tylko jeden dzień?
Ponieważ cztery grupy nie rozkładają się równomiernie na cały tydzień. Dostępy wewnętrzne i systemy testowe często zależą od dni roboczych i terminów wdrożeń, witryny kampanijne od pojedynczych akcji. Tydzień obejmuje każdy dzień tygodnia raz; przy rzadkich okazjach, takich jak comiesięczny newsletter, nawet on jest za krótki.
Które obco wyglądające nazwy hostów mimo to należą do prawdziwych wizyt?
Obok stron docelowych, witryn kampanijnych i systemów sklepowych z kroku 1 należą do nich przede wszystkim usługi tłumaczeniowe, które serwują stronę razem z tagiem pod własnym adresem. Znanym przykładem jest serwer pośredniczący Tłumacza Google, którego nazwy hostów kończą się na translate.goog i zawierają domenę witryny z łącznikami, na przykład www-przyklad-pl.translate.goog. Stoją za nimi ludzie czytający witrynę w innym języku.
Czy takie wizyty mają trafiać do zbioru, jest kwestią decyzji, a nie przypadkiem spamu. Tryb testowy pokazuje, ile ich jest, zanim filtr odrzuci je bezpowrotnie.
Jak w praktyce wygląda oczyszczanie wstecz w eksporcie do BigQuery?
Nazwa hosta znajduje się w eksporcie w polu device.web_info.hostname. Oczyszczanie przebiega w dwóch krokach, które odpowiadają dwóm pierwszym krokom kolejności z artykułu:
- Wypisać wszystkie występujące nazwy hostów wraz z częstością:
SELECT device.web_info.hostname AS host, COUNT(*) AS events FROM `project.analytics_XXXXXXXXX.events_*` WHERE _TABLE_SUFFIX BETWEEN '20260601' AND '20260927' GROUP BY host ORDER BY events DESC. Tak powstaje lista, którą przypisuje się do czterech grup. - Każdą dalszą analizę ograniczyć do nazw, które mają zostać, na przykład przez
WHERE device.web_info.hostname IN ('www.przyklad.pl', 'sklep.przyklad.pl'). Taka lista nazw dozwolonych wyłapuje także nazwy hostów ze spamu, które pojawią się dopiero później; lista nazw zablokowanych tego nie potrafi.
Jedna granica pozostaje: „wstecz” oznacza tu tylko do dnia, w którym utworzono połączenie z BigQuery. Eksport nie uzupełnia historii, a kto włączy go dopiero w dniu uruchomienia filtra, nie ma danych surowych za czas wcześniejszy.
Powiązane artykuły