English
 Deutsch
 Polski
Floodlight w Tag Managerze po stronie serwera: zmiana z czerwca 2026 i gdzie znajduje się kontrola zgody

Spis treści
Większość zmian w interfejsie pomiarowym jest nudna, a notatki o nich jeszcze nudniejsze. Jedna z czerwca 2026 nie jest: tagi Floodlight w Tag Managerze po stronie serwera zaczynają przesyłać żądania bez zgody, z serwera na serwer.
Jako powód podano dokładność modelowanych konwersji, i ten powód się trzyma. Rzuca się w oczy, gdzie stoi to zdanie: w notatce o wydaniu, między aktualizacjami obrazu bazowego, a nie w zapowiedzi z własną stroną.
Co notatka mówi dosłownie
Mieszczą się w niej trzy stwierdzenia. Pierwsze: zmiana ma odzyskać konwersje liczone w konfiguracjach serwerowych zbyt nisko, bo brakowało kontekstu ciasteczka z przeglądarki. Drugie: tagi Floodlight w Tag Managerze po stronie serwera będą odtąd przesyłać także żądania bez zgody, z serwera na serwer. Trzecie: dane serwerowe są scalane z obecnymi sygnałami przeglądarki, gdy dostępna jest GCLID.
Trzecie jest technicznie najciekawsze, a pierwsze to prawdziwe ulepszenie. Drugie jest tym, które zmienia konfigurację.
Dlaczego zgoda w przeglądarce nie dosięga drogi serwerowej
Tryb zgody działa tam, gdzie siedzi: w przeglądarce. Tag, któremu odmówiono ad_storage, nie wysyła trafienia albo wysyła je bez identyfikatorów. Kontener po stronie serwera pracuje natomiast na własnej infrastrukturze, a o tym, co z niego wychodzi, rozstrzyga szablon w kontenerze – nie brama na stronie.
Aby serwer w ogóle wiedział, jak wypadło rozstrzygnięcie, sygnał zgody musi zostać do niego przekazany i tam oceniony. Dokładnie w tym miejscu zmiana chwyta: żądanie wychodzi odtąd również wtedy, gdy sygnał mówi o odmowie.
Dwie drogi, jedna brama

  przeglądarka -> Google         brama: tryb zgody
    ad_storage denied   trafienie zostaje wstrzymane albo bez
                        identyfikatorów

  przeglądarka -> własny serwer -> Google
    ad_storage denied   żądanie wychodzi (nowe od czerwca 2026)
                        scalenie tylko tam, gdzie jest GCLID

  Brama stoi na drodze górnej. Dolna biegnie obok niej, a to nie
  luka, lecz budowa: serwer jest własny, a kto z niego wysyła,
  ten to sam urządził.
Co scalenie naprawdę daje
Część z GCLID warto mieć niezależnie od wszystkiego innego. Konwersja zgłaszana zarówno przez przeglądarkę, jak i przez serwer była dotąd trudna do rozwiązania: bez wspólnego zaczepu strona odbierająca widzi dwa zdarzenia i musi zgadywać, czy to dwie konwersje. Identyfikator kliknięcia jest takim zaczepem, a scalenie po nim jest właśnie tym, co kończy podwójne liczenie.
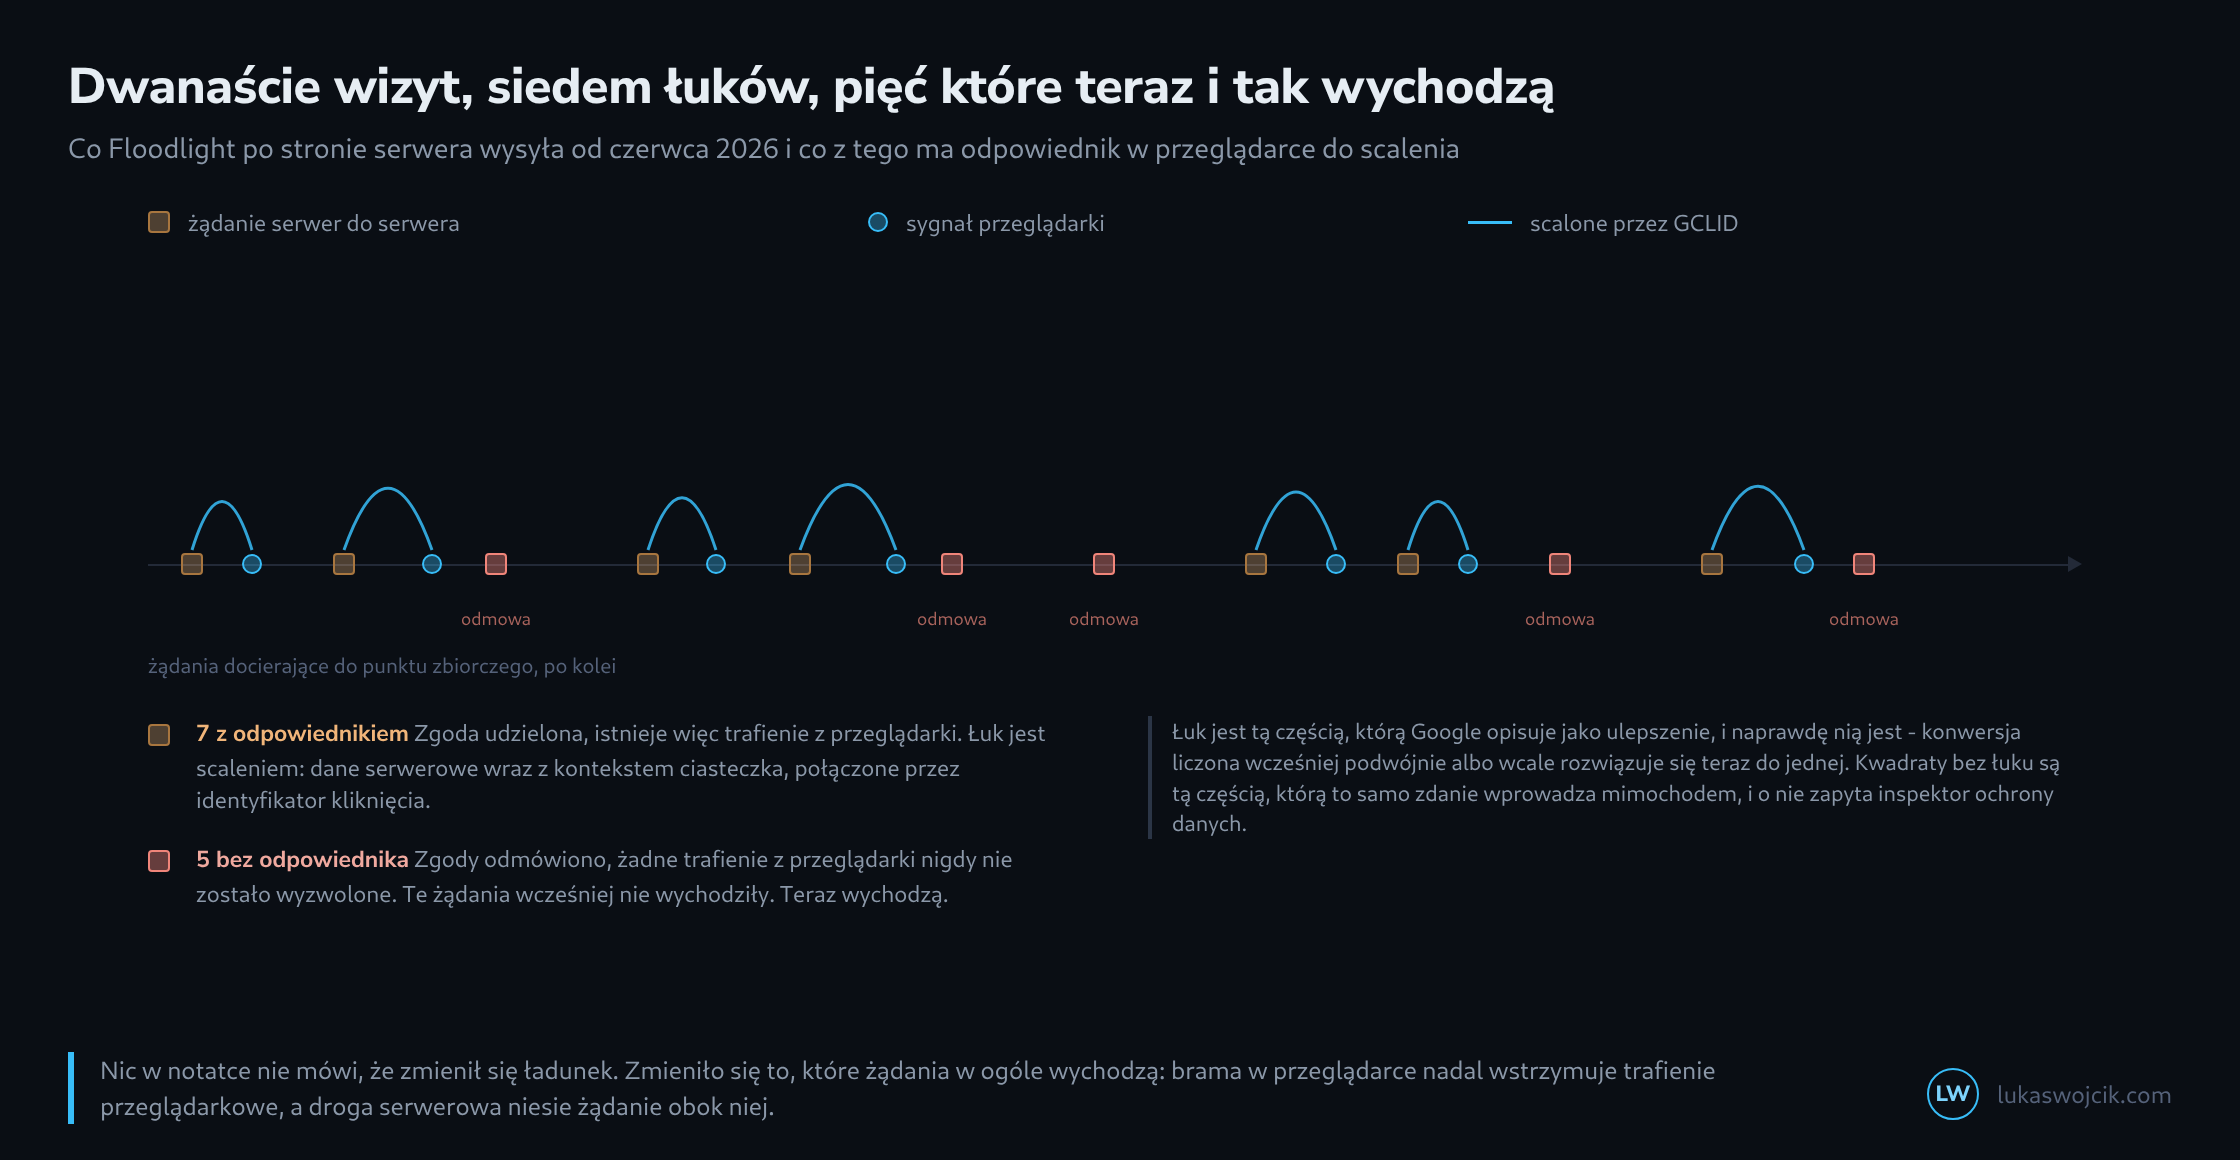
Kto zgłasza równolegle po stronie serwera i w przeglądarce, dostaje przez to czystsze liczby. To ulepszenie bez posmaku i dotyczy siedmiu łuków na obrazku.
Pytanie, na które notatka nie odpowiada
Dla pięciu żądań bez łuku podstawa prawna pozostaje otwarta, i to w obie strony. Artykuł 5 ustęp 3 dyrektywy ePrivacy reguluje dostęp do urządzenia końcowego – przesył między dwoma serwerami żadnego urządzenia końcowego nie dotyka, dlatego brama tego przepisu na dolnej drodze faktycznie nie musi się odnaleźć. RODO obowiązuje natomiast bez zmian, a dane pochodziły pierwotnie właśnie z urządzenia końcowego.
Stoją zatem obok siebie dwie wykładnie warte poważnego traktowania i obie mają swoich rzeczników. Jedna mówi, że bez dostępu do urządzenia brakuje zaczepu dla obowiązku zgody. Druga mówi, że odmowa załatwiona objazdem przez własną infrastrukturę nie jest odmową. Która przeważy, nie jest rozstrzygnięte, a ten artykuł tego nie rozstrzyga. To, co tu stoi, jest opisem mechanizmu, a nie poradą prawną.
Notatka pozostawia równie otwarte, czy to zachowanie da się wyłączyć. To pierwsze pytanie, na które da się odpowiedzieć na działającej konfiguracji, i da się na nie odpowiedzieć bez czekania na wykładnię.
Co da się sprawdzić we własnym kontenerze
Trzy rzeczy, w tej kolejności. Po pierwsze, czy w kontenerze serwerowym leżą w ogóle tagi Floodlight – bez nich zmiana konfiguracji nie dotyka. Po drugie, czy sygnał zgody dociera do serwera, bo serwer, który go nigdy nie dostaje, i wcześniej nie mógł na tej podstawie rozróżniać. Po trzecie, co szablon tagu oferuje, by przy odmowie nie wysyłać.
Ustalenie da się odczytać w podglądzie. Przejście w trybie diagnostycznym kontenera serwerowego sesji z odmówioną pamięcią reklamową i odczytanie wychodzących żądań pokazuje od razu, co wychodzi. Takie sprawdzenie kosztuje pół godziny i jest jedyną podstawą, na której da się tę kwestię w ogóle omawiać – wszystko inne jest domysłem o własnej konfiguracji.
Pytania i odpowiedzi
Czy w podstawowym trybie zgody żądanie bez zgody w ogóle dociera do serwera?
Zwykle nie. W trybie podstawowym (Basic) tagi Google ładują się dopiero po udzieleniu zgody; kto odmawia, nie wytwarza w przeglądarce żadnego żądania pomiarowego, a kontener po stronie serwera nie ma niczego, co tag Floodlight mógłby przekazać dalej. W takiej konfiguracji zmiana z czerwca 2026 trafia w próżnię, dopóki żadne inne tagi nie wysyłają danych na własny serwer bez zgody.
W trybie zaawansowanym (Advanced) tagi ładują się od razu i przy odmowie wysyłają żądania bez ciasteczek i identyfikatorów. Te docierają na własny serwer i to właśnie one są żądaniami bez zgody, które według notatki tag Floodlight w kontenerze będzie odtąd przekazywał dalej. To samo dotyczy żądań, które własny skrypt wysyła do kontenera bez względu na zgodę.
Tryb działający na stronie współdecyduje więc o tym, czy zmiana w ogóle dotyka konfiguracji. Da się to odczytać w zakładce sieci przeglądarki: jeśli po odmowie nadal wychodzą żądania do własnego serwera tagowania, w grę wchodzi tryb zaawansowany albo inna droga.
Czy zmiana dotyczy także innych tagów Google w kontenerze po stronie serwera?
Notatka wymienia tylko tagi Floodlight i nic więcej nie da się z niej wyprowadzić. Czy inne tagi w tym samym kontenerze, na przykład dla Google Ads albo GA4, zachowują się podobnie, pokazuje to samo sprawdzenie co w artykule: przejście w trybie diagnostycznym sesji z odmówioną pamięcią reklamową i przejrzenie wychodzących żądań tag po tagu.
Powiązane artykuły