English
 Deutsch
 Polski
AI-Modelle nach Kosten vergleichen: Cloud-API oder DeepSeek und Qwen lokal?

Inhalt
Der günstigste Tokenpreis bestimmt nicht automatisch die günstigste fertige Aufgabe. Wiederholungen, Denkbudget, Werkzeuge und Korrekturen verändern die Rechnung. Der Vergleich vom 6. Oktober 2026 verbindet aktuelle API-Tarife mit einer getrennten Betrachtung lokaler DeepSeek- und Qwen-Varianten.
Ein transparenter Tarifvergleich
Das Beispiel rechnet mit insgesamt einer Million ungecachten Eingabetokens und 200.000 abrechenbaren Ausgabetokens, verteilt auf kurze Einzelanfragen. Denk-Tokens müssen in der abrechenbaren Ausgabe enthalten sein. Angegeben sind USD ohne Steuern, Werkzeuge, Cache, Batch- oder Sonderrabatte. Bei OpenAI gilt die Standard-Spalte für kurzen Kontext. [10]
| Modell | Input / Output je Million | Beispielsumme |
|---|---|---|
| GPT-6 Astra | 10 / 50 USD | 20 USD |
| GPT-6.1 Sol | 2 / 10 USD | 4 USD |
| Claude Opus 5.5 | 4 / 20 USD | 8 USD |
| Claude Sonnet 5.5 | 2 / 10 USD | 4 USD |
| Gemini 3.8 Flash | 0,75 / 3,75 USD | 1,50 USD |
| DeepSeek V4.1 Flash, Peak | 0,30 / 1,20 USD | 0,54 USD |
| DeepSeek V4.1 Flash, Off-Peak | 0,15 / 0,60 USD | 0,27 USD |
Die Claude-Werte stammen aus der Modellübersicht. Googles aufgeführter Standardtarif gilt laut Preisseite bis Ende 2026. DeepSeek unterscheidet Peak und Off-Peak; ein echter Lauf benötigt die passende Tarifzeit. Die Rechnung vergleicht identische Tokenmengen, keine identische Qualität oder reale Geschwindigkeit. [3, 11, 13]
Offene Gewichte haben keinen Einheitstarif
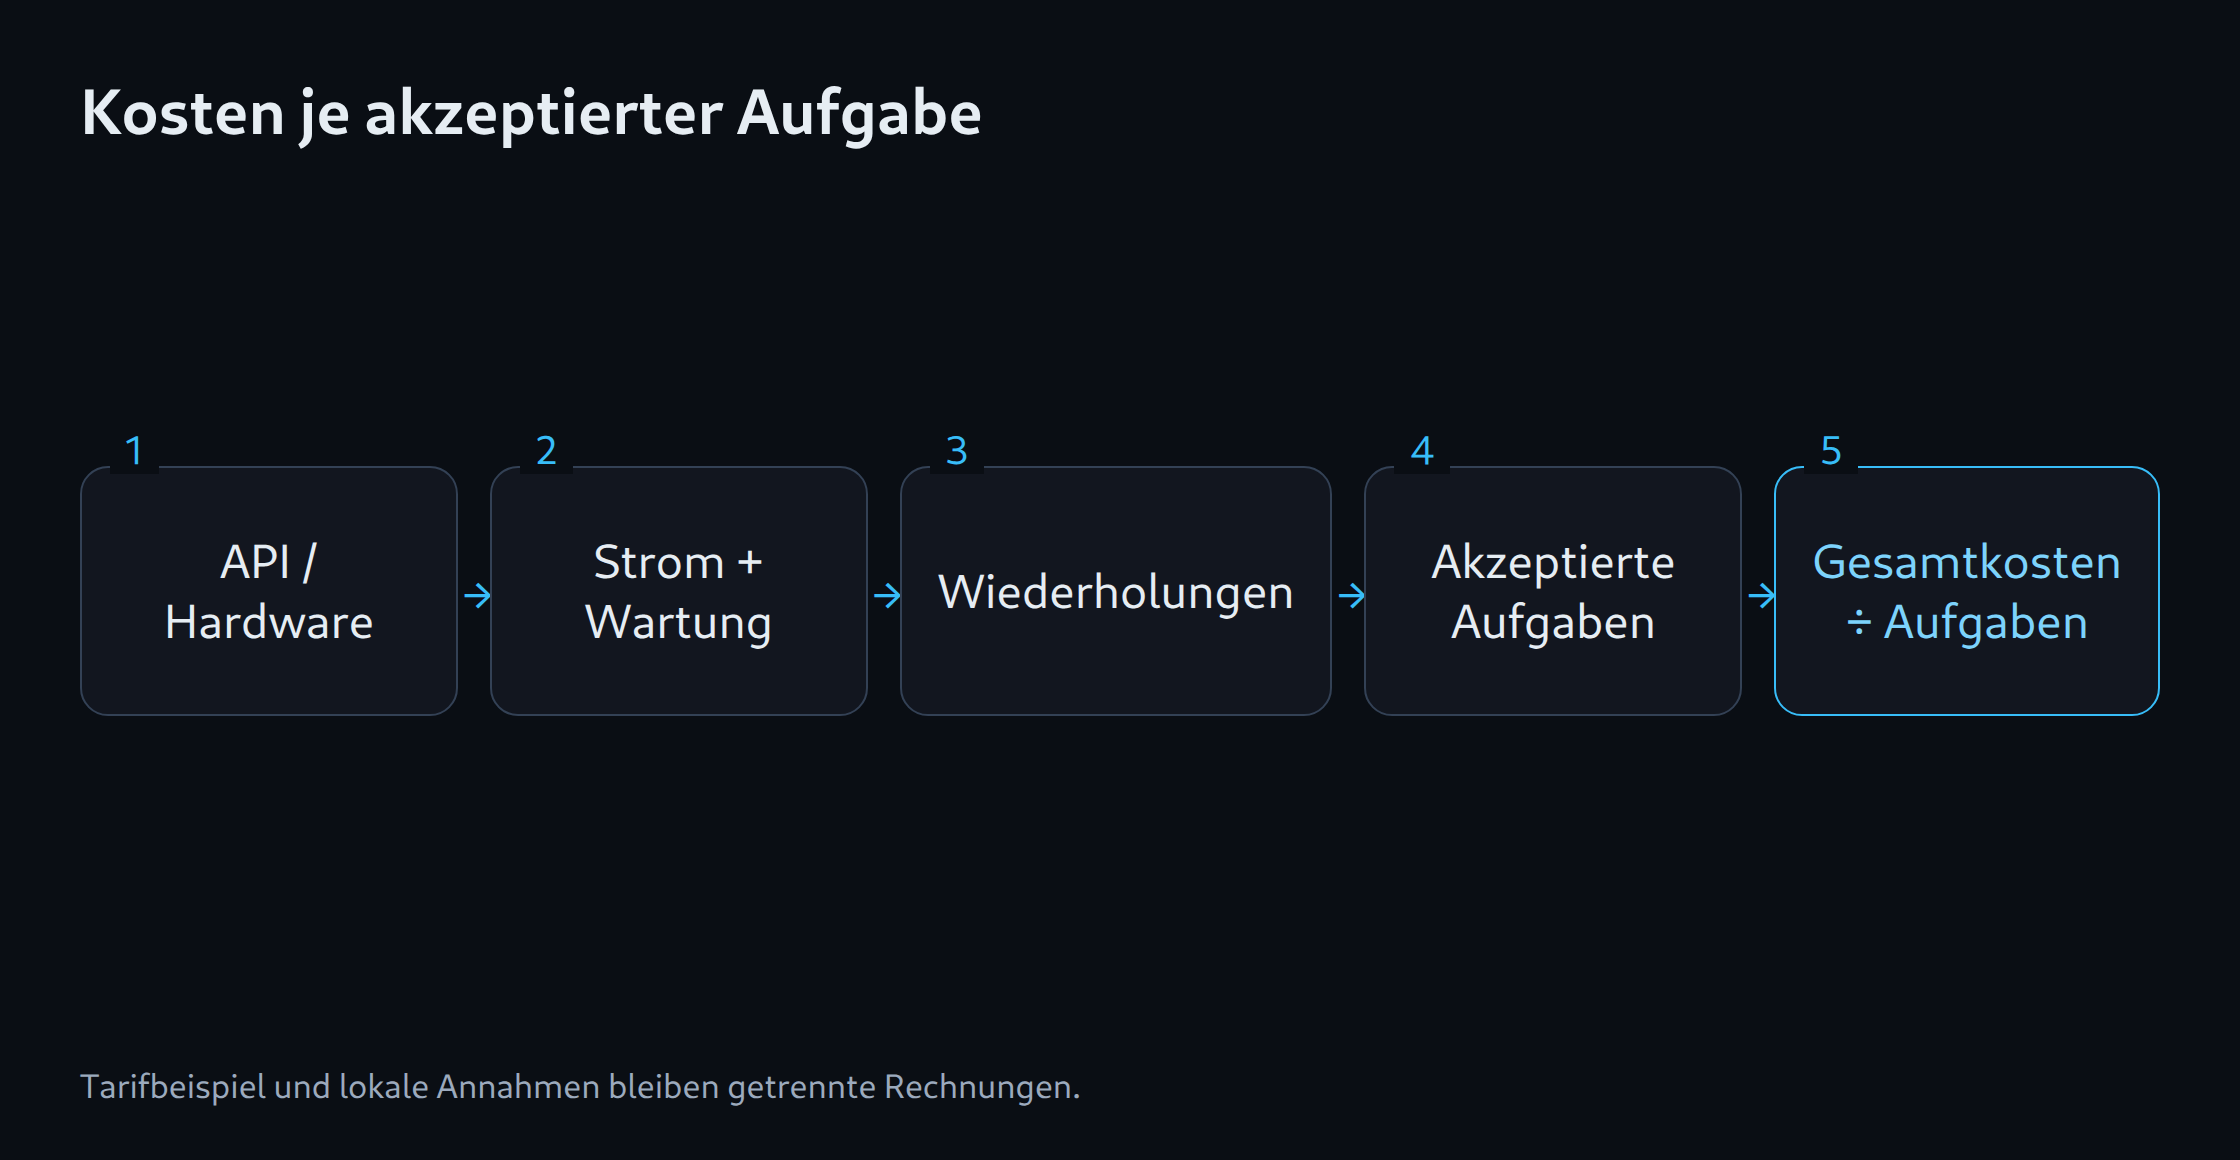
Ein lokales Qwen-Modell besitzt keinen festen API-Tokenpreis. Die Rechnung umfasst anteilige Anschaffung, Strom, Wartung und gegebenenfalls Ausfallkosten. DeepSeek-Gewichte sind ebenfalls verfügbar; die vollständige Modellgröße kann jedoch eine andere Infrastrukturklasse erfordern. Ein herunterladbares MoE-Modell wird durch wenige aktive Parameter nicht zu einem kleinen Desktop-Modell. [7, 8]
Ein ausdrücklich angenommenes Beispiel setzt 50 Euro monatliche Hardwarekosten, 20 Euro Strom und 30 Euro Wartungsaufwand an. Bei 1.000 akzeptierten Aufgaben entstehen 0,10 Euro je Aufgabe. Ohne gleiche Qualitäts- und Aufgabenbedingungen lässt sich dieser Euro-Wert nicht direkt gegen die USD-Tariftabelle stellen.
Qualität in die Rechnung aufnehmen
Die Kennzahl lautet Gesamtkosten geteilt durch akzeptierte Aufgaben. Scheitern viele Antworten, steigen Wiederholungen und Korrekturzeit. Ein teurerer Kandidat kann dadurch wirtschaftlicher werden. Umgekehrt kann ein kleiner lokaler Checkpoint bei einfachen, häufigen Aufgaben ausreichend sein. Das ist eine zu prüfende Betriebshypothese, keine gemessene Preis-Leistungs-Rangfolge.
Ein gemischter Betrieb
Ein Pilot kann Routineaufgaben lokal bearbeiten und definierte schwierige Fälle an eine Cloud-API geben. Das Routing gehört ins Protokoll. Ollamas Cloud-Funktionen zeigen zusätzlich, weshalb Laufzeitname und Datenort getrennt zu prüfen sind. [9]
Der vorhandene Kostenrechner unterstützt die lokalen Annahmen; das Modell-Testprotokoll dokumentiert Akzeptanz und Fehler. Zusammen entsteht eine überprüfbare Entscheidung. Tarife und Modellversionen benötigen vor einer späteren Veröffentlichung einen erneuten Abgleich.
Passende Werkzeuge
Fragen und Antworten
Sind die Beispielsummen monatliche Abopreise?
Die Summen beschreiben angenommene API-Tokenmengen mit den genannten Tarifbedingungen. Chatabos und lokale Betriebskosten folgen anderen Rechnungen.
Wann ist ein lokales Modell günstiger?
Entscheidend sind Auslastung, Hardwareanteil, Strom, Wartung und akzeptierte Ergebnisse. Ein niedriger Strompreis allein reicht für einen Kostenvergleich nicht aus.
Quellen
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
- Google: Gemini API pricing
Quellen geprüft: 6. Oktober 2026.
Passend dazu