English
 Deutsch
 Polski
Modele AI do programowania: GPT i Claude wobec DeepSeek i Qwen

Spis treści
Model do programowania przynosi korzyść dopiero wtedy, gdy zmiana działa w istniejącym projekcie. Krótkie fragmenty kodu, naprawy repozytorium i wieloetapowa praca agenta to różne zadania. Porównanie z 6 października 2026 obejmuje GPT-6 Astra i 6.1 Sol, Claude Opus i Sonnet 5.5, Gemini 3.8 Flash, DeepSeek V4.1 Flash oraz Qwen3.8-27B.
Kandydaci chmurowi i otwarte wagi
Udokumentowane modele chmurowe zapewniają przetwarzanie tekstu i integrację narzędzi. OpenAI pozycjonuje Astra do wymagających zadań; Anthropic opisuje Opus 5.5 jako model do długiej agentowej pracy nad kodem. Gemini 3.8 Flash dokumentuje wywołania funkcji i wykonywanie kodu. Te cechy wyznaczają kandydatów do testu, bez bezpośrednio porównywalnej skuteczności. [1, 4, 6]
DeepSeek i Qwen publikują wagi modeli. Karta Qwen wymienia silniki inferencji i warunki opublikowanych ocen programistycznych. Lokalny test z inną kwantyzacją lub innym frameworkiem agenta nie odtwarza automatycznie tych warunków. [7, 8]
Zakres pomiaru
| Zadanie | Chmura: GPT / Claude / Gemini | Otwarte: DeepSeek / Qwen |
|---|---|---|
| Mała funkcja | Opóźnienie API i poprawność | Start i lokalne opóźnienie |
| Błąd repozytorium | Poprawka i zaliczone testy | Te same testy, dokładny checkpoint |
| Praca agenta | Kroki narzędziowe i koszt całkowity | Framework, pamięć i przerwania |
| Przegląd kodu | Istotne błędy zamiast objętości | Te same usterki i fałszywe alarmy |
Konkretny protokół repozytorium
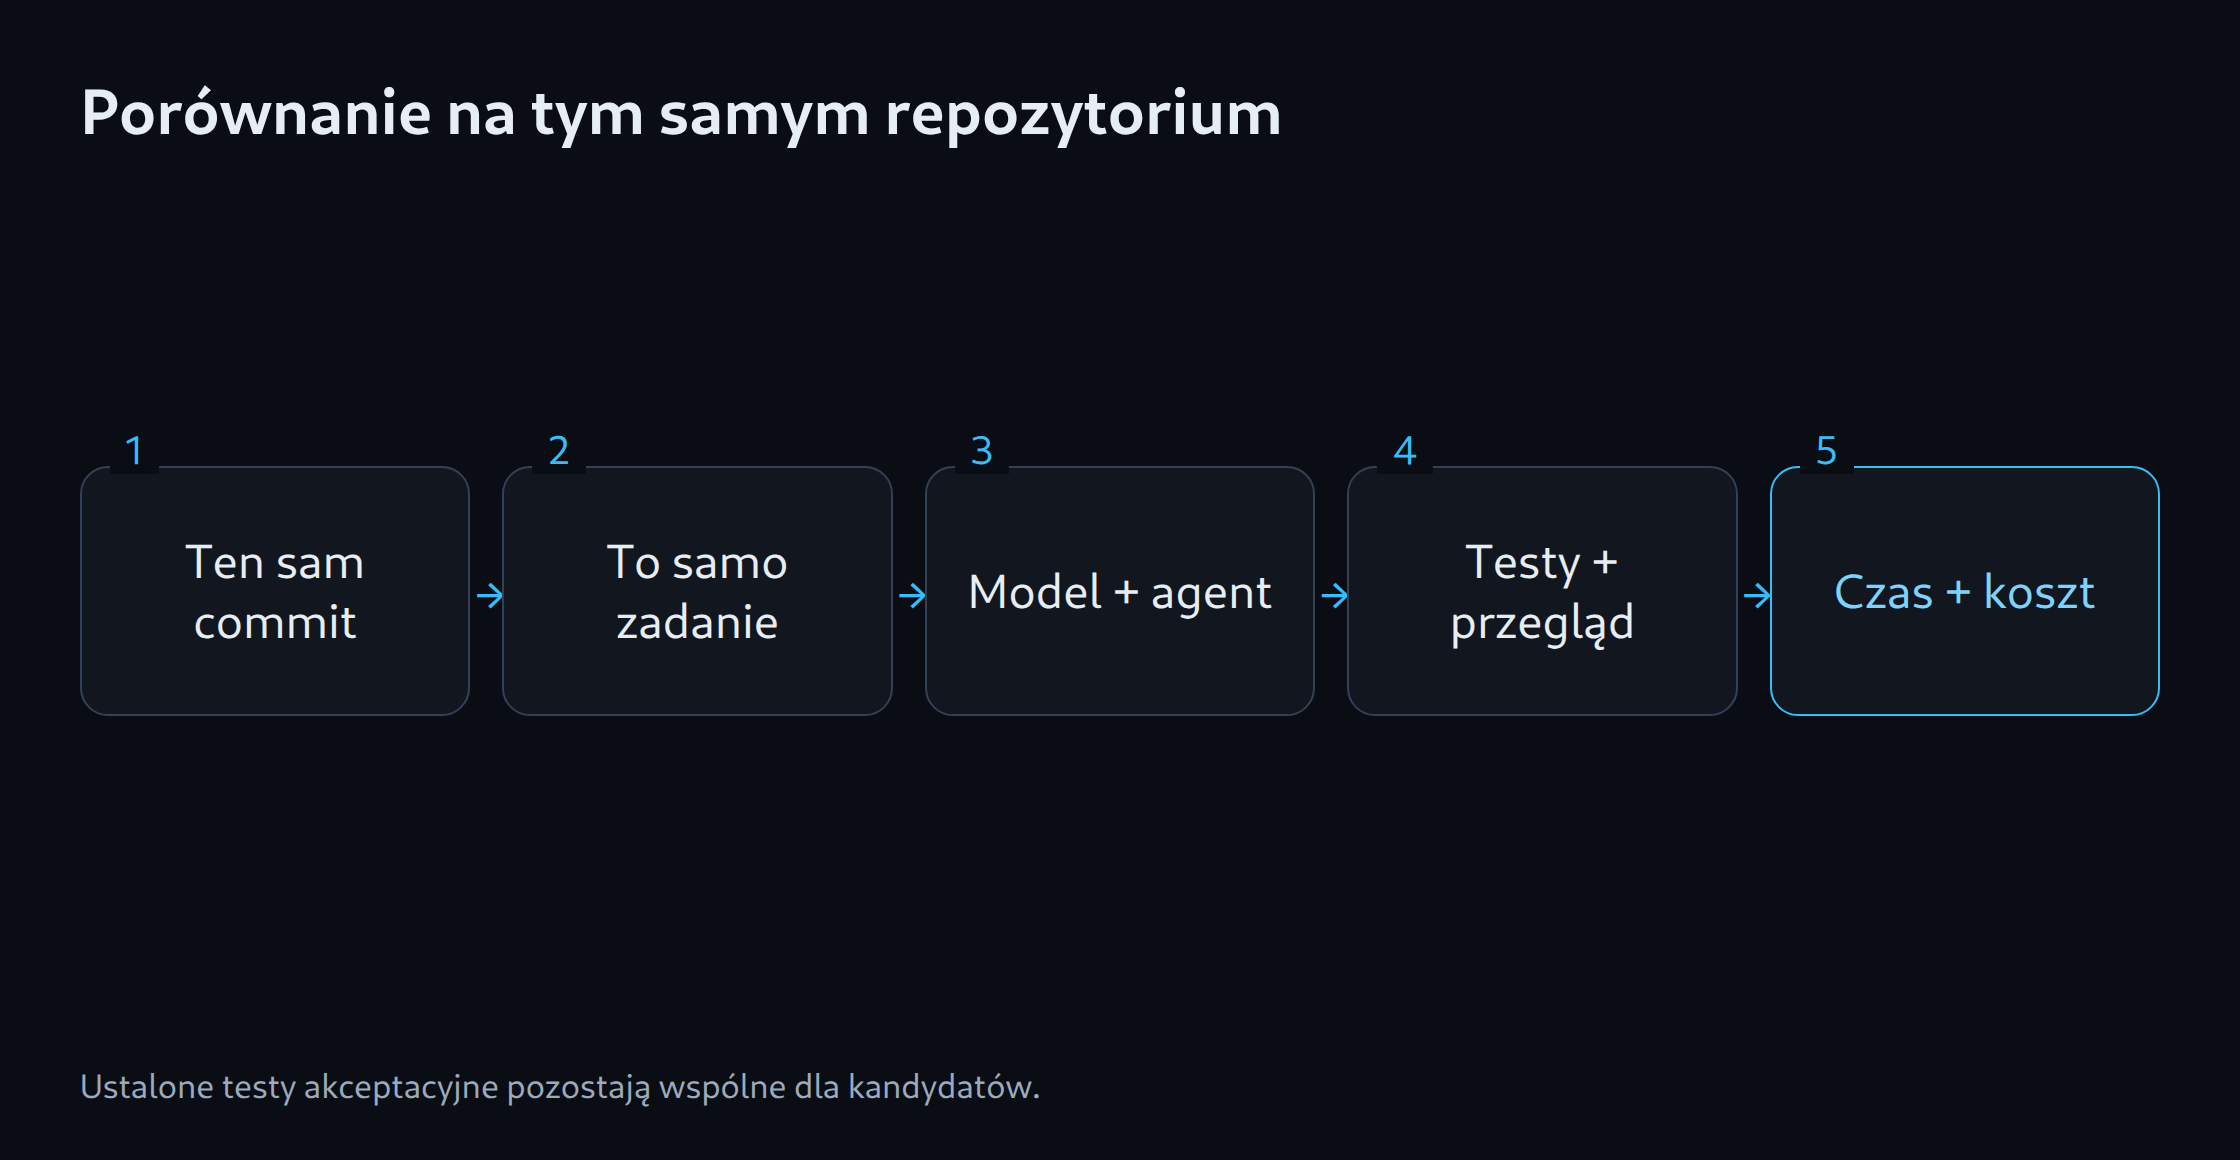
Redakcyjny zestaw obejmuje sześć zadań: odtwarzalny błąd, małą funkcję, zmianę API, refaktoryzację, dodatkowy test i przegląd ze znanymi usterkami. Każdy przebieg zaczyna się od tego samego commita. Testy akceptacyjne pozostają ustalone; zmniejszenie zestawu testów nie stanowi poprawnego zakończenia zadania.
Rejestr obejmuje zaliczone zadania, regresje, zbędne pliki, tokeny i minuty do zweryfikowanego wyniku. Powtórzenia pomagają odróżnić przypadkowe powodzenie od stabilnej jakości. Wyniki z różnych interfejsów agentowych wymagają również osobnego porównania całych systemów.
Kiedy lokalne działanie ma sens
Lokalny wariant Qwen zasługuje na test, gdy kod powinien pozostać w organizacji, a sprzęt mieści wymagany kontekst. Ollama upraszcza uruchamianie, ale nie zastępuje obsługi architektury ani poprawnej integracji narzędzi. Plan DeepSeek musi uwzględniać pełny model; niewielka liczba aktywnych parametrów MoE nie potwierdza równie małego zapotrzebowania na pamięć. [7, 9]
Modele chmurowe pozostają kandydatami do eskalacji trudnych zmian. Przełączenie wynika z zapisanej granicy błędów zamiast preferencji marki. Artykuł przedstawia konstrukcję porównania; konkretne wskaźniki skuteczności wymagają wykonanych testów.
Powiązane narzędzia
Pytania i odpowiedzi
Czy wysoki wynik benchmarku programistycznego wystarcza?
Znaczenie mają również warunki testu, framework agenta, powtórzenia i zadania z rzeczywistego repozytorium. Wynik producenta nie zastępuje oceny projektu.
Czy Ollama automatycznie zachowuje kod lokalnie?
Ścieżkę danych określają wywołany model i podłączone narzędzia. Ollama obsługuje także funkcje chmurowe; działanie wyłącznie lokalne wymaga odpowiedniej konfiguracji.
Źródła
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
Źródła sprawdzone: 6 października 2026.
Powiązane artykuły