English
 Deutsch
 Polski
Które modele AI pasują do niemieckiego, angielskiego i polskiego?

Spis treści
Model może przekonująco działać po angielsku, a wymagać znacznie więcej poprawek w polskiej fleksji lub niemieckiej terminologii technicznej. Ogólny ranking nie rozstrzyga zatem decyzji redakcji trójjęzycznej. Porównanie obejmuje kandydatów GPT, Claude i Gemini udokumentowanych 6 października 2026 oraz DeepSeek V4.1 Flash i Qwen3.8-27B.
Wielojęzyczność bez gwarancji jakości
OpenAI i Anthropic dokumentują możliwości wielojęzyczne. Nie ustala to rankingu jakości dla niemieckiego, angielskiego i polskiego. Otwarty checkpoint z dobrymi wynikami ogólnymi również potrzebuje osobnej oceny językowej. Wybrany wariant Qwen lub DeepSeek, środowisko i kwantyzacja pozostają częścią konfiguracji testu. [1, 3, 7, 8]
Różne zadania językowe
| Język | Materiał | Kryterium akceptacji |
|---|---|---|
| DE | Wyjaśnienie techniczne i krótkie FAQ | Terminologia, jasne odniesienia, neutralny styl |
| EN | Opis produktu i streszczenie | Precyzja, naturalność, brak dodatków |
| PL | Tekst fachowy i lokalizowany interfejs | Fleksja, słownictwo i naturalna składnia |
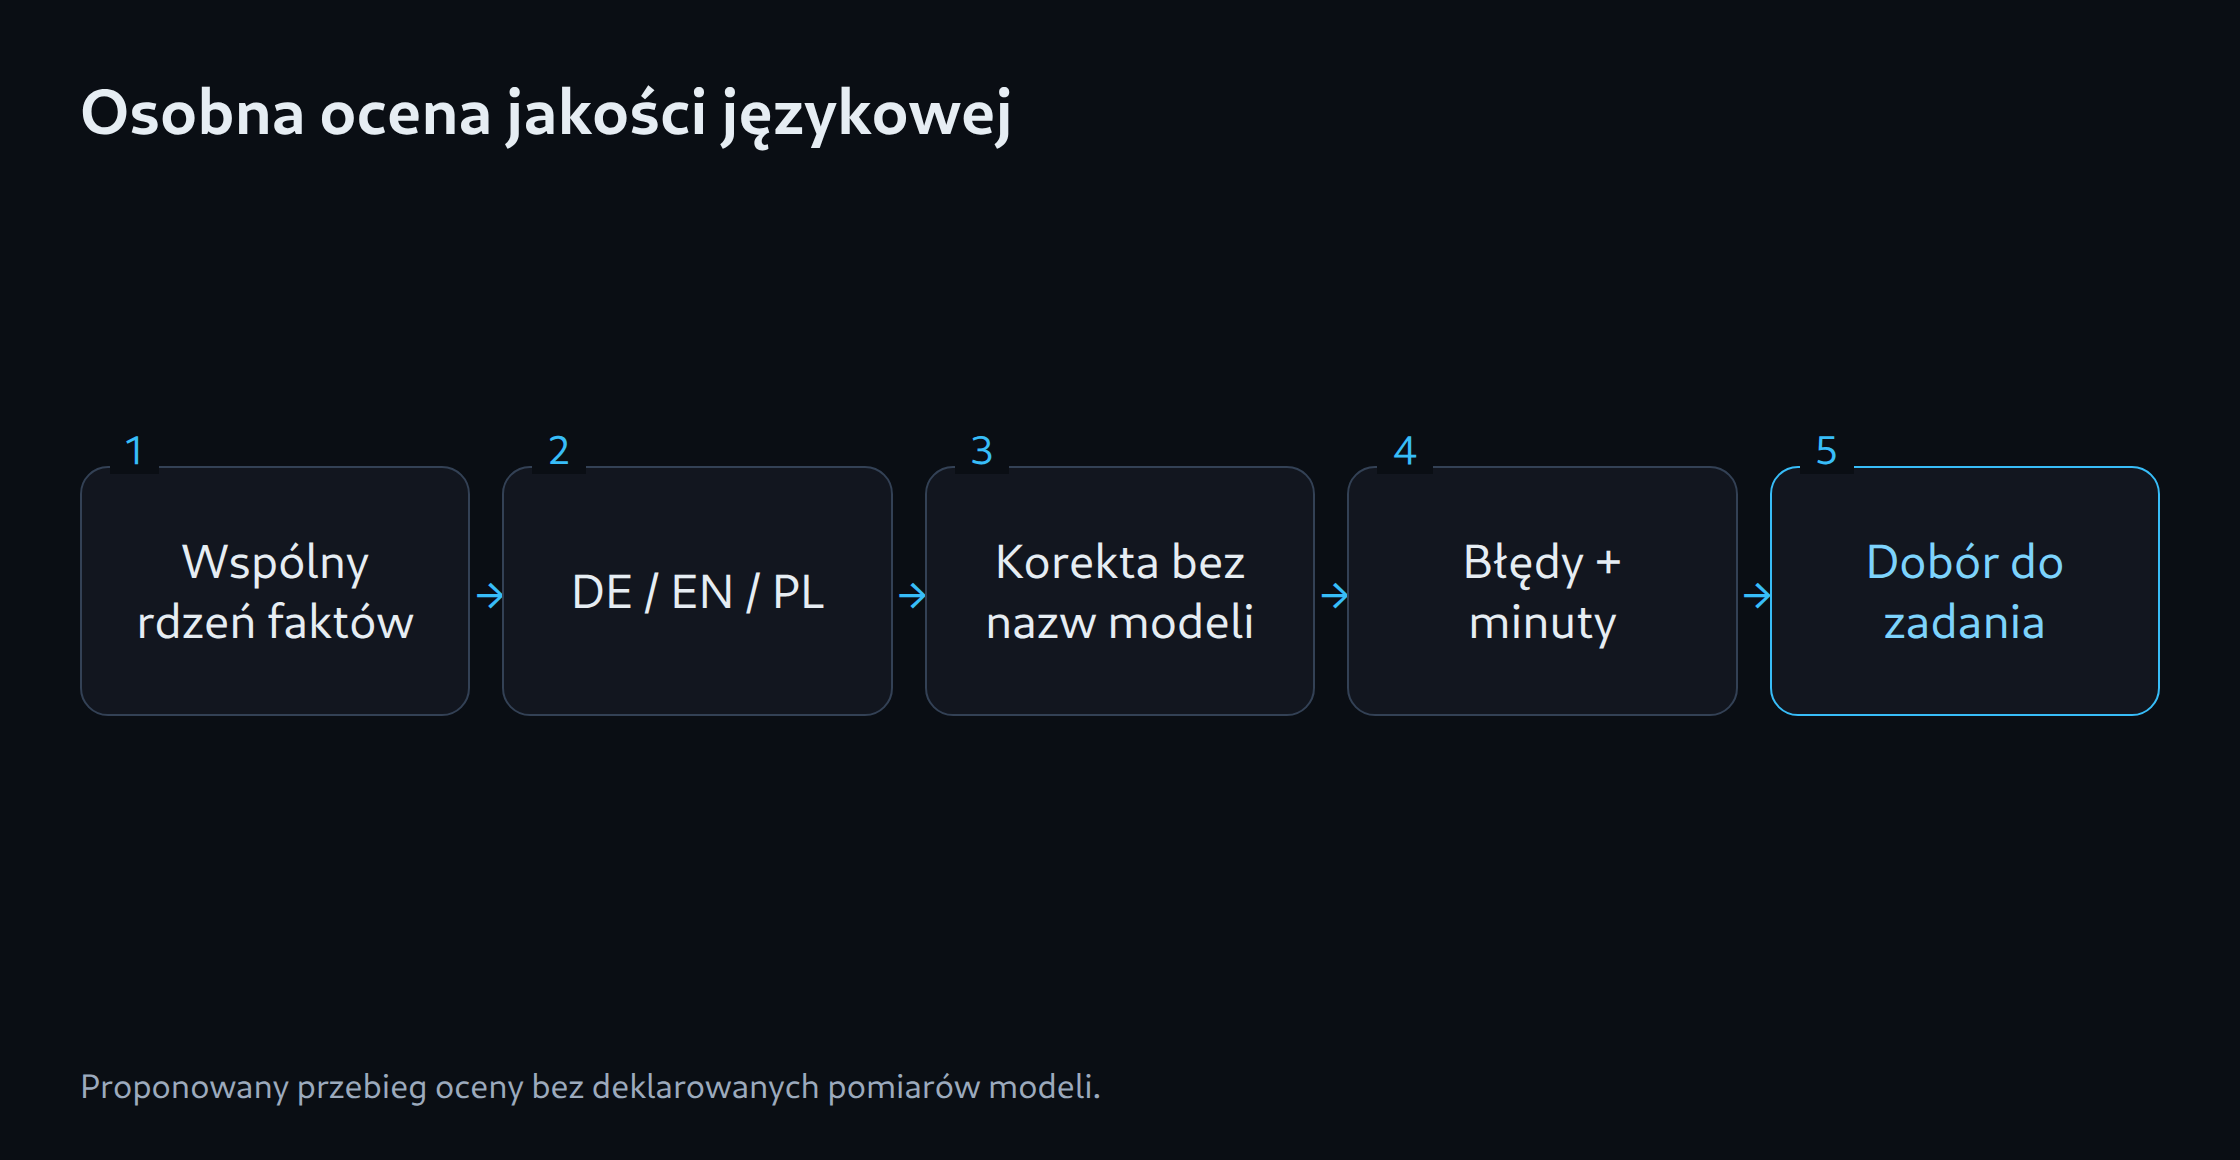
| DE / EN / PL | Wspólny rdzeń faktów | Jednakowe liczby, zastrzeżenia i twierdzenia |
Protokół bez przewagi angielskiego
Ocena redakcyjna może obejmować dwanaście zadań na język. To proponowany zakres, bez wykonanych pomiarów. Każde zadanie ma listę faktów, zatwierdzone terminy i grupę odbiorców. Część zadań powstaje bezpośrednio w języku docelowym, pozostałe tłumaczą wspólny tekst. Generowanie języka i jakość przekładu otrzymują osobną ocenę.
Punktacja uwzględnia błędy znaczenia, pominięte zastrzeżenia, gramatykę, terminologię i zbędne dodatki. Płynność nie daje przewagi po usunięciu liczby lub niepewności. Minuty korekty są również przydatne: użyteczny szkic może wymagać mniej pracy niż elegancka, lecz niewiarygodna odpowiedź.
Uczciwe porównanie chmury i wariantów lokalnych
GPT-6.1 Sol, Claude Sonnet 5.5 i Gemini 3.8 Flash tworzą praktyczną listę chmurową. Astra i Opus rozszerzają ocenę trudnych zadań. Odpowiedni checkpoint Qwen jest kandydatem do lokalnej pracy redakcyjnej; DeepSeek uzupełnia porównanie przez właściwe API lub dostateczną infrastrukturę. To hipotezy zastosowania, bez wskazanego zwycięzcy jakości językowej.
Testy lokalne zapisują kontekst, szablon czatu i kwantyzację. Przejście z Q8 do Q4 tworzy nowy warunek testowy. Ollama zapewnia warstwę wykonawczą; pamięć i warunki działania wymagają oceny oddzielnej od jakości modelu. [9]
Dobór według zadania
Redakcja trójjęzyczna nie potrzebuje jednego modelu do wszystkich treści. Tańszy kandydat może obsługiwać krótkie wyniki strukturalne, a trudne teksty przechodzić drugą kontrolę. Decyzja wynika z błędów na język i nakładu korekty. Różnice pozostają widoczne zamiast znikać w ogólnej średniej.
Powiązane narzędzia
Pytania i odpowiedzi
Czy angielski benchmark potwierdza jakość języka polskiego?
Angielskie benchmarki obejmują inne zadania i cechy językowe. Polska fleksja, terminologia i zachowanie znaczenia wymagają własnych materiałów.
Czy wszystkie języki powinny używać tego samego modelu?
Wspólny model upraszcza pracę. Różne modele też są uzasadnione przy jednolitym sprawdzaniu faktów, terminologii i granic jakości.
Źródła
- OpenAI: model catalogue
- OpenAI: GPT-6.1 Sol
- Anthropic: Claude model overview
- Anthropic: Claude Opus 5.5
- Anthropic: Claude Sonnet 5.5
- Google: Gemini 3.8 Flash
- DeepSeek: V4.1 Flash model card
- Qwen: Qwen3.8-27B model card
- Ollama: FAQ and local/cloud operation
- OpenAI: API pricing
- DeepSeek: models and pricing
- Google: document understanding
Źródła sprawdzone: 6 października 2026.
Powiązane artykuły