English
 Deutsch
 Polski
Modelowanie behawioralne w GA4: dwa warunki kwalifikacji i gdzie pojawiają się wartości modelowane

Spis treści
Rozpowszechnione pocieszenie po wprowadzeniu trybu zgody brzmiało, że modelowanie i tak wyłapie odmowy. Dla większości witryn to nieprawda, a powód stoi w dwóch zdaniach na stronie pomocy Google.
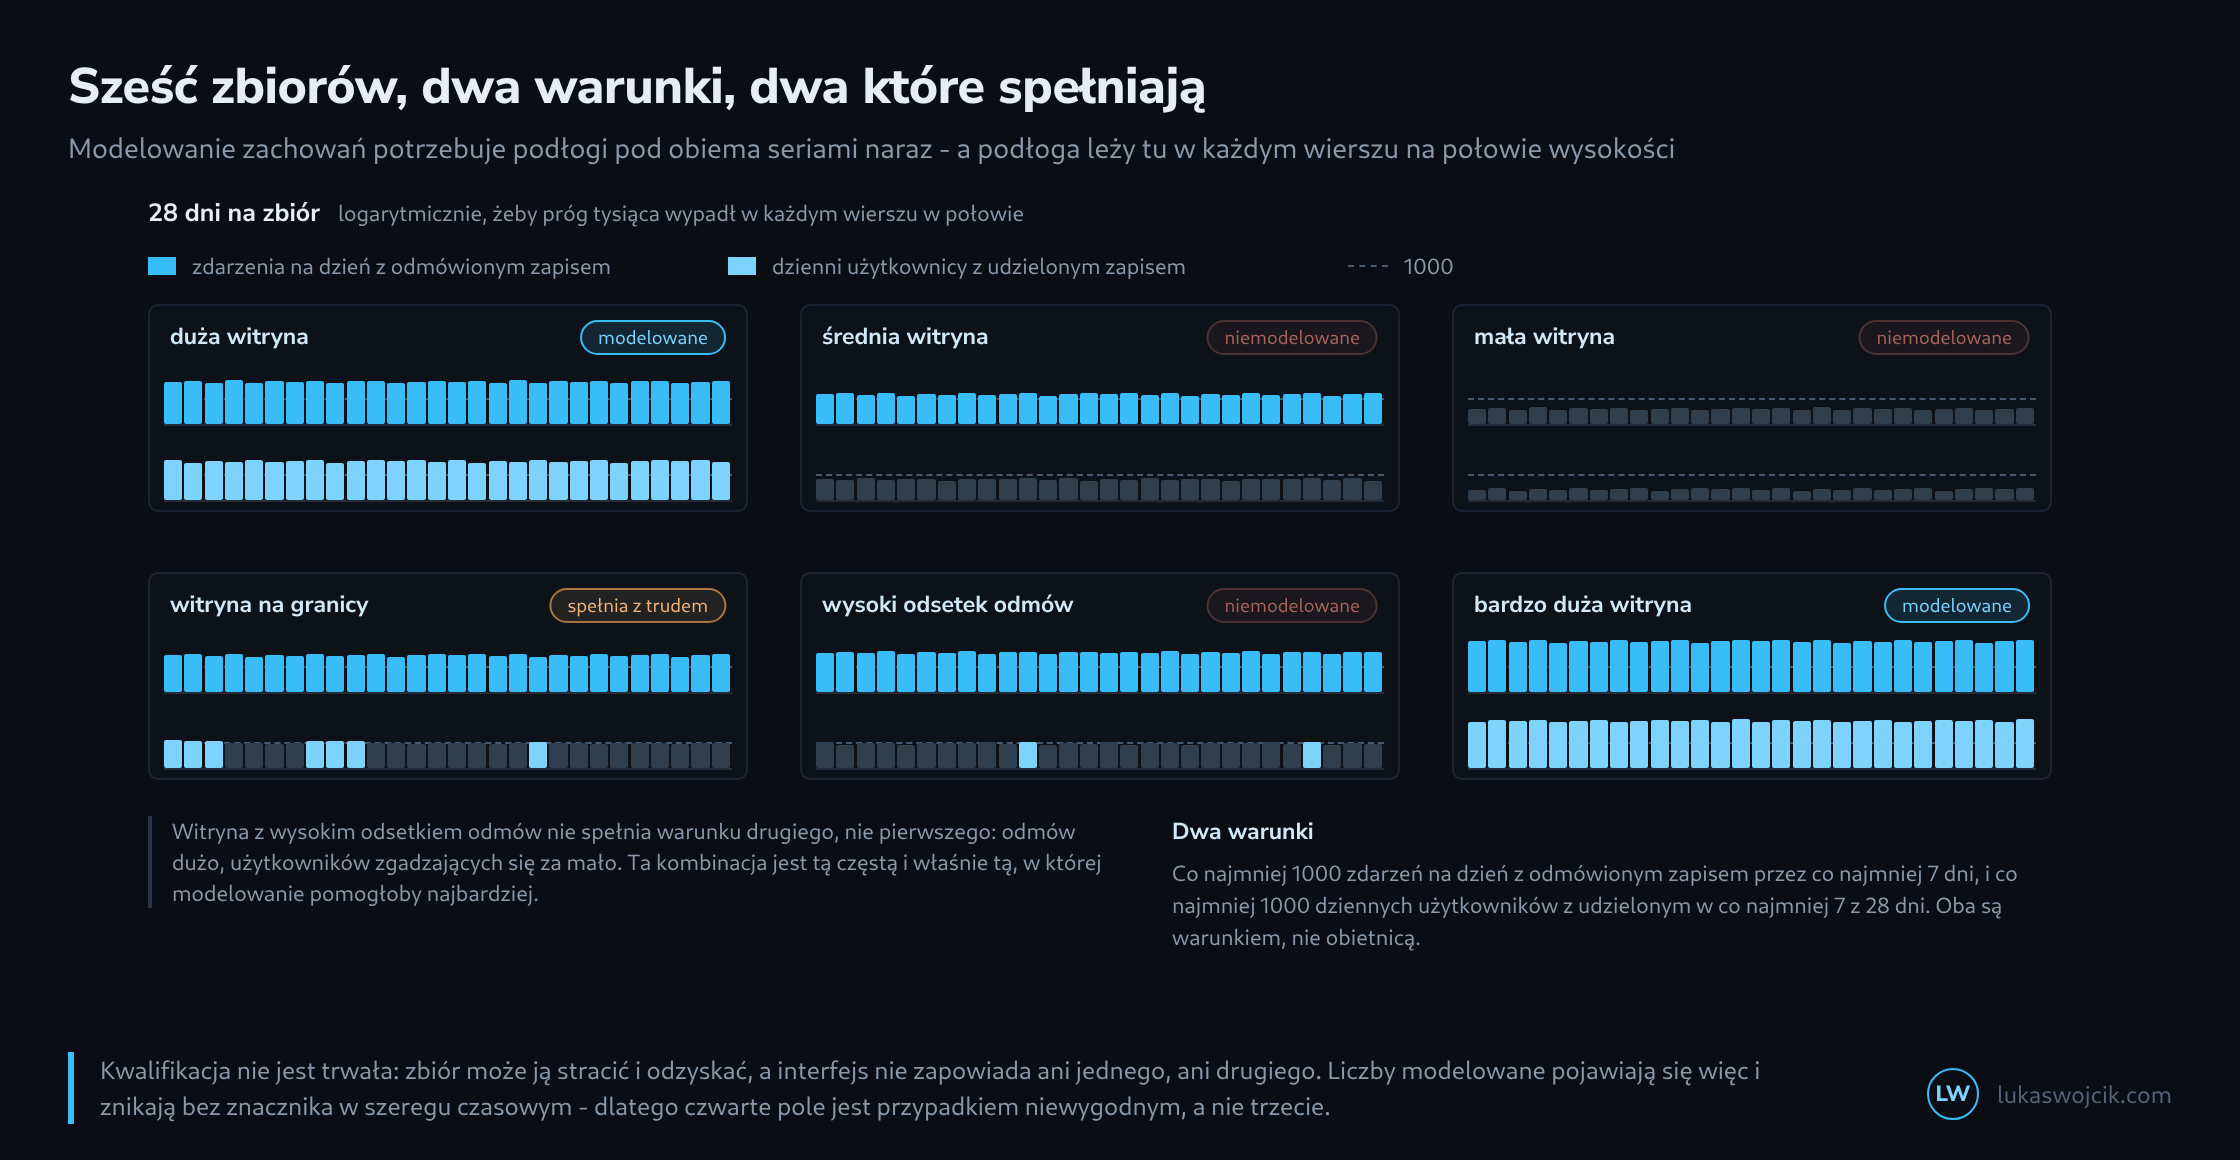
Modelowanie zachowań potrzebuje co najmniej 1000 zdarzeń na dzień z odmówionym zapisem, przez co najmniej siedem dni. I potrzebuje co najmniej 1000 dziennych użytkowników wysyłających zdarzenia z udzielonym zapisem, w co najmniej siedmiu z 28 poprzednich dni. Obu warunków naraz.
Dwa warunki nie są symetryczne
Różnicę w brzmieniu łatwo przeoczyć, a ona rozstrzyga sprawę: warunek pierwszy liczy zdarzenia, drugi liczy użytkowników. Witryna z wieloma odsłonami na wizytę osiąga próg pierwszy znacznie wcześniej niż drugi, bo jeden człowiek wytwarza w ciągu dnia kilkanaście zdarzeń, a pozostaje jednym użytkownikiem.
Dochodzi do tego okienkowanie. Warunek pierwszy żąda siedmiu dni, drugi siedmiu z 28. Oba są minimami na oknach przesuwnych i żadnego z nich nie ma w interfejsie jako wskaźnika postępu.
Dlaczego drugi warunek jest trudniejszy
Modelowanie potrzebuje wzorców. Przenosi zachowanie osób zgadzających się na odmawiające, a do tego potrzebuje dość osób zgadzających się – nie dość odmawiających. Stawia to witrynę z wysokim odsetkiem odmów w niewygodnym położeniu: luk do wypełnienia sporo, materiału do wypełniania za mało.
Dokładnie ten przypadek stoi na obrazku jako pole piąte. Rząd górny leży daleko nad linią, dolny nieco pod nią, a ocena brzmi jednak: niemodelowane. Kto patrzy tylko na odsetek odmów, uzna to za usterkę.
Gdzie liczby modelowane stoją, a gdzie nie
Gdy progi są osiągnięte, wartości szacowane pojawiają się w raportach standardowych, na przykład przy użytkownikach, sesjach i nowych użytkownikach. Lista miejsc, w których nie się pojawiają, jest dłuższa i praktycznie ważniejsza.
Wartości modelowane pojawiają się w

  raportach standardowych   użytkownicy, sesje, nowi użytkownicy

Wartości modelowane nie pojawiają się w

  eksporcie BigQuery        wcale
  grupach odbiorców         nie
  eksploratorze użytkownika nie
  analizie kohortowej       nie
  segmentach z sekwencjami  nie
  raportach utrzymania      nie
  metrykach predykcyjnych   nie
  analizie ścieżek i lejków traktowane inaczej

  Następstwo: interfejs i eksport liczą inaczej, i oba mają
  rację. Różnicą jest modelowanie.
Raport w interfejsie ma zatem liczbę, której nie da się odtworzyć z eksportu – i to nie przez usterkę, lecz dlatego, że jedna liczba zawiera oszacowanie, a druga nie. Kto używa obu źródeł obok siebie i szuka rozbieżności, szuka czegoś, co nie ma przyczyny w danych.
Kwalifikacja nie jest trwała
Strona Google wyraźnie odnotowuje, że zbiór, który raz spełnił warunki, a później już nie, traci dane szacowane – i odzyskuje je, gdy spełni je ponownie. Żadne z tych przejść nie jest zapowiadane.
Dla szeregu czasowego znaczy to, że sposób liczenia może się zmienić w środku przebiegu, bez żadnej adnotacji obok. Witryna z ruchem sezonowym przechodzi przez to być może dwa razy w roku. Czwarte pole na obrazku jest więc przypadkiem niewygodnym, a nie trzecie: kto linii wyraźnie nie dosięga, ma przynajmniej równy szereg czasowy.
Strona odnotowuje również, że warunki zewnętrzne nie są obietnicą. Model dokłada nad nimi własne kryteria, a wymienione są stosunek nowych do powracających użytkowników oraz stosunek użytkowników do sesji.
Co z tego wynika
Same progi da się przeliczyć, i to jest krok pierwszy. Wystarczą dwie liczby: zdarzenia na dzień z odmówionym zapisem i dzienni użytkownicy zgadzający się. Obie stoją w zbiorze, a odpowiedź jest „tak” albo „nie”, a nie przeczuciem.
Gdy odpowiedź wypada na „nie”, następstwem nie jest bezradność, lecz jasność: liczby raportowane są wtedy wyłącznie policzonymi wartościami osób zgadzających się, a część odmawiająca brakuje w całości. To uczciwsza podstawa niż liczba, o której nikt nie wie, jaki jej udział jest szacowany. Kto brakującą część chce mimo to oszacować, nie ominie własnego rachunku – a ten zaczyna się od odsetka odmów, który i tak jest mierzalny.
Pytania i odpowiedzi
Ilu dziennych użytkowników potrzebuje witryna z wysokim odsetkiem odmów, by modelowanie w ogóle wchodziło w grę?
Warunek drugi da się przeliczyć wprost. Jeśli potrzeba 1000 użytkowników wyrażających zgodę dziennie, a odmawia udział q, witryna potrzebuje łącznie co najmniej 1000 / (1 − q) użytkowników na dzień. Przy przyjętym odsetku odmów 60 procent daje to 2500, przy 80 procentach 5000, za każdym razem w co najmniej siedmiu z 28 poprzednich dni. Rachunek zakłada, że odsetek odnosi się do użytkowników; odsetek liczony na sesję albo na wyświetlenie banera może się od niego różnić.
Warunek pierwszy jest wtedy zwykle już spełniony, ale tylko o ile odmawiający w ogóle wysyłają zdarzenia. Dzieje się tak wyłącznie wtedy, gdy tag ładuje się także bez zgody i wysyła pingi bez ciasteczek, jak w zaawansowanym trybie zgody. W trybie podstawowym tag ładuje się dopiero po udzieleniu zgody, zdarzenia z odmówionym zapisem nie powstają, a warunek pierwszy pozostaje na zerze, niezależnie od wielkości witryny.
Czy o tym, czy pojawiają się wartości modelowane, decyduje także ustawienie w GA4?
Tak, ustawienie Reporting Identity, które określa, z jakich identyfikatorów GA4 korzysta przy przypisywaniu aktywności użytkownikom. Wartości modelowane pojawiają się tylko przy opcji Blended; przy Observed albo Device-based raporty pokazują wyłącznie wartości policzone, nawet gdy oba progi są osiągnięte. Ustawienie działa tylko na raporty, a nie na zbieranie danych, więc jego zmiana zmienia też wstecznie, jaką liczbę pokazuje szereg czasowy.
Powiązane artykuły