English
 Deutsch
 Polski
Sitemap-Strukturen an 24 Seiten gemessen: Index, Aufteilung, Erweiterungen und Verstöße

Inhalt
- So wurde gemessen
- Sechs Domains ohne lesbare Sitemap
- robots.txt als Inhaltsverzeichnis
- Fünf Bauformen
- Die Grenze, die zuerst erreicht wird
- Wo die Verstöße sitzen
- lastmod: ein Datum für alles
- Die Ortsregel und das XSD
- Eine Sitemap vor dem Veröffentlichen prüfen
- Einordnung und Grenzen
- Fragen und Antworten
- Quellen
Bei einer kleinen Seite ist eine Sitemap eine Liste. Bei einer großen ist sie ein Gebäude aus Dateien: ein Index, der auf Kinddateien zeigt, eine Aufteilung nach Inhaltsart, Sprache oder laufender Nummer und Erweiterungen für Bilder, Videos, News und Sprachfassungen. Jede dieser Entscheidungen hat eine Grenze im Protokoll, und an jeder lässt sich etwas falsch machen, ohne dass eine Seite davon sichtbar kaputtgeht.
Für diesen Artikel wurden am 1. Oktober 2026 die Sitemaps von 24 Domains gelesen und mit dem Prüfkern des neuen Sitemap Checker & Validator geprüft: Suche, Infrastruktur, Nachrichten, Verwaltung, Handel und Reise, in drei Ländern, dazu die eigene Seite.
So wurde gemessen
Gesucht wurde die Sitemap so, wie ein Crawler sie findet: zuerst die erste Sitemap:-Zeile in robots.txt, sonst /sitemap.xml und /sitemap_index.xml. War die Datei ein Index, wurden drei Kinddateien geholt, die erste, eine aus der Mitte und die letzte. Gepackte Dateien (.gz) wurden entpackt. Geprüft hat derselbe Code, der im Werkzeug im Browser läuft, hier unter Node auf dem eigenen Server.
Nicht geprüft wurde, ob die Adressen in den Sitemaps erreichbar sind. Das ist eine andere Frage mit eigenen Fallen, und für sie gibt es den XML-Sitemap-Auditor, der eine Stichprobe der Adressen abruft. Hier geht es um die Dateien selbst: Aufbau, Format und die Regeln von sitemaps.org und Google.
Sechs Domains ohne lesbare Sitemap
Von 24 Domains lieferten 18 eine lesbare Sitemap. Vier nennen in robots.txt keine Sitemap und antworten unter /sitemap.xml mit 404, eine davon erst nach einer Weiterleitung. Zwei weisen den abrufenden Client mit 403 ab, eine davon bei der Datei, die ihre eigene robots.txt nennt.
Ein Fall liegt dazwischen. heise.de nennt in robots.txt sieben Sitemaps, und die erste davon, /sitemapindex.xml, antwortet mit 404. Die Standardadresse /sitemap.xml liefert dagegen eine Datei mit 10.000 Einträgen. Ein Crawler, der alle Zeilen liest, verliert dadurch nichts; ein Werkzeug, das nur die erste nimmt, meldet eine fehlende Sitemap.
robots.txt als Inhaltsverzeichnis
Das Protokoll erlaubt beliebig viele Sitemap:-Zeilen, und genau so arbeiten mehrere große Seiten: Statt eines Index steht die Liste der Dateien gleich in robots.txt.
| Domain | Sitemap:-Zeilen |
|---|---|
| booking.com | 434 |
| nytimes.com | 25 |
| microsoft.com | 22 |
| otto.de | 19 |
| bbc.co.uk | 13 |
| wordpress.org | 9 |
| heise.de | 7 |
| sieben weitere | 1 bis 5 |
Das hat einen Vorteil, der in keiner Spezifikation steht: Jede Zeile ist zugleich der Nachweis, dass der Betreiber des Hosts diese Datei will. Nach sitemaps.org darf eine Sitemap Adressen eines anderen Hosts nur enthalten, wenn dessen robots.txt auf sie zeigt.
Fünf Bauformen
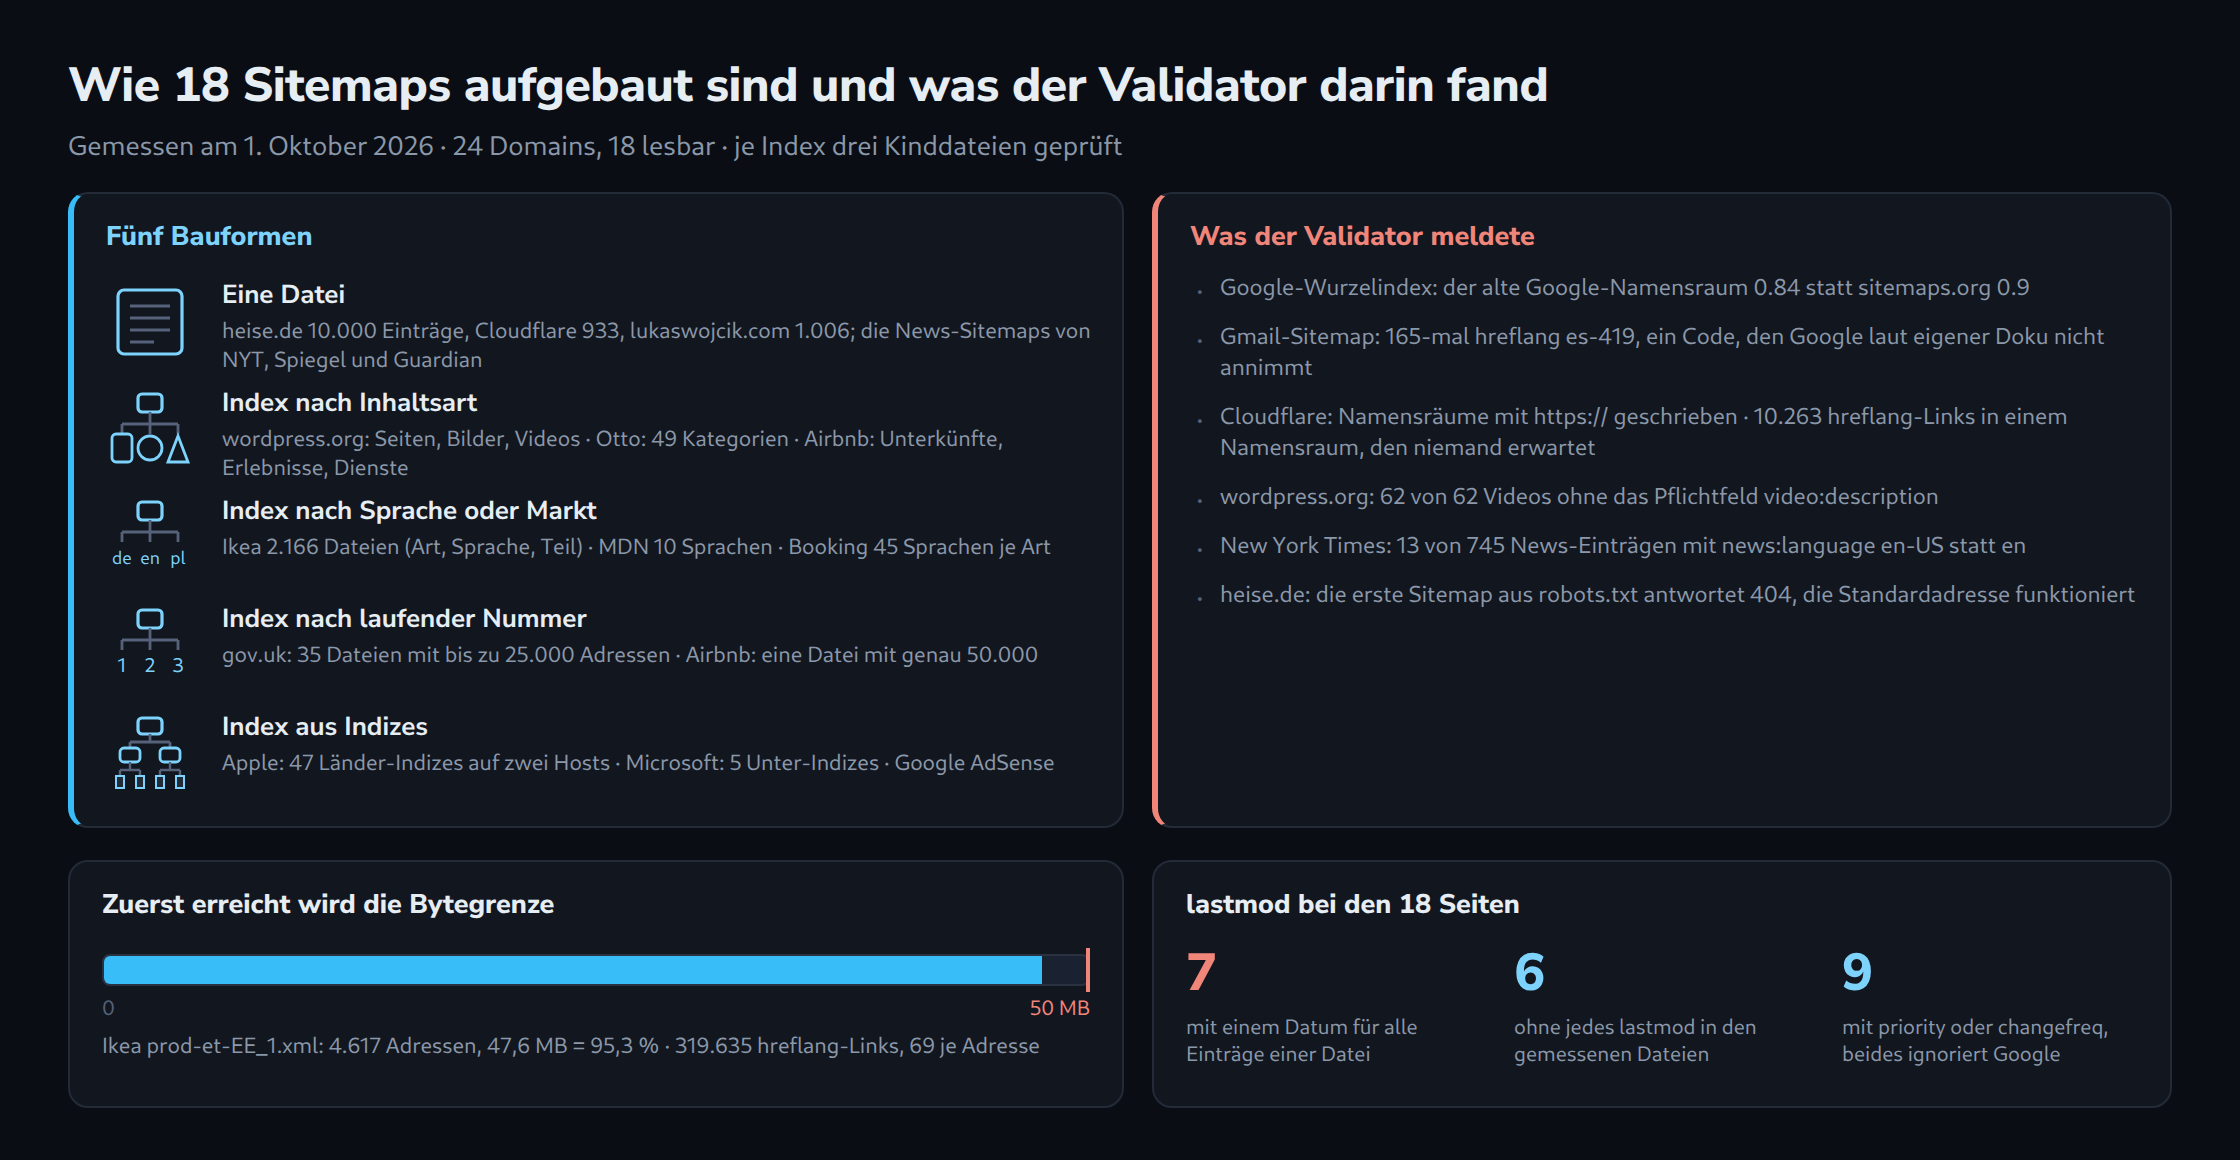
Die 18 Sitemaps lassen sich fünf Bauformen zuordnen, und manche Seiten mischen zwei davon.
| Bauform | Beispiele aus der Messung |
|---|---|
| eine Datei | heise.de (10.000 Einträge), lukaswojcik.com (1.006), Cloudflare (933); die News-Sitemaps von New York Times, Spiegel und Guardian, die ihre robots.txt jeweils zuerst nennt |
| Index nach Inhaltsart | wordpress.org (Seiten, Bilder, Videos), Otto (49 Kategorien), Airbnb (Unterkünfte, Erlebnisse, Ziele, Hilfeseiten) |
| Index nach Sprache oder Markt | Ikea mit 2.166 Dateien nach dem Muster prod-et-EE_1.xml, MDN mit zehn Sprachen, Booking mit 45 Sprachen je Inhaltsart, Shopify mit 568 Dateien |
| Index nach laufender Nummer | gov.uk mit 35 Dateien zu je bis zu 25.000 Adressen, Airbnb mit 140 Dateien nur für Unterkünfte |
| Index aus Indizes | Apple (47 Länder-Indizes, einer davon auf apple.com.cn), Microsoft (fünf Unter-Indizes), eine Kinddatei von Google |
Die letzte Form verdient einen zweiten Blick. sitemaps.org beschreibt einen Index als Liste von Sitemaps, Google sagt zur Verschachtelung in der Anleitung für große Sitemaps nichts. Ein Index, der auf weitere Indizes zeigt, verlässt sich also auf ein Verhalten, das niemand zusagt. Apples Wurzelindex nennt dazu Dateien auf einem zweiten Host, was nach dem Protokoll nur über die robots.txt jenes Hosts gedeckt ist.
Die Grenze, die zuerst erreicht wird
Eine Sitemap darf höchstens 50.000 Adressen enthalten und unkomprimiert höchstens 50 MB groß sein. gov.uk bleibt mit 25.000 Adressen je Datei bei der Hälfte, eine Airbnb-Datei steht mit genau 50.000 auf der Grenze. Bei Ikea greift die andere Grenze.
Die Datei prod-et-EE_1.xml enthält nur 4.617 Adressen, ist aber 47,6 MB groß, 95,3 Prozent dessen, was erlaubt ist. Jede Adresse trägt im Mittel 69 xhtml:link-Einträge für ihre Sprachfassungen, zusammen 319.635, dazu 22.797 Bilder und 1.585 Videos. Rund 10,8 KB je Eintrag sind nicht mehr die Adresse, sondern ihre Beschreibung.
Das ist die Rechnung, die hreflang in der Sitemap mit sich bringt: Jede Fassung einer Seite listet alle anderen Fassungen und sich selbst. Über alle Dateien wächst die Zahl der Links deshalb mit dem Quadrat der Sprachfassungen, nicht mit der Zahl der Seiten. Für Sitemaps mit hreflang ist die Bytegrenze daher der bessere Maßstab für die Aufteilung als die Zahl der Adressen.
Wo die Verstöße sitzen
Im Kernformat aus loc, lastmod, changefreq und priority fand der Validator wenig: einige doppelte Einträge, bei heise.de drei Adressen mit Fragment (#) und zwei auf einem anderen Host, leere Kinddateien bei Shopify und Ikea. Die Verstöße mit Gewicht stecken fast alle in den Namensräumen und den Erweiterungen.
- Google-Wurzelindex: Er steht im alten Google-Namensraum
http://www.google.com/schemas/sitemap/0.84statt inhttp://www.sitemaps.org/schemas/sitemap/0.9. Namensräume werden Zeichen für Zeichen verglichen; für einen strengen Leser ist das kein Sitemap-Index. - Gmail-Sitemap: 166 Adressen mit 9.075 hreflang-Links, 165 davon mit dem Code
es-419für lateinamerikanisches Spanisch. Googles Hilfeseite zu Sprachfassungen nennt genau diesen Code als Beispiel für einen, der nicht unterstützt wird, weil nur Regionen nach ISO 3166-1 gelten. Die Hilfeseite selbst führt in ihrem HTML-Kopf eine Fassung mithreflang="es-419". - Cloudflare: Die Namensräume für die Sitemap und für
xhtmlstehen mithttps://da. Ein Namensraum ist eine Kennung, keine Adresse; mithttpsist es eine andere Kennung, und die 10.263 hreflang-Links liegen in einem Namensraum, den kein Leser erwartet. - wordpress.org: Alle 62 Videos der Video-Sitemap haben kein
video:description, das Google als Pflichtfeld führt. Die Bild-Sitemap derselben Seite führt Seiten mehrfach, einmal je Bild, die Startseite allein 91-mal; 521 der 693 Einträge wiederholen eine schon genannte Adresse, obwohl einurl-Eintrag bis zu 1.000 Bilder tragen darf. - New York Times: 13 der 745 Einträge der News-Sitemap tragen
news:languagemiten-US. Verlangt ist ein ISO-639-Code aus zwei oder drei Buchstaben, Ausnahmen gibt es nur fürzh-cnundzh-tw. - BBC: Der Index nennt drei Sitemaps zu den Wahlen von 2014, eine davon mit 204 Adressen, alle noch mit
http://.
Ob Google diese Fälle im Einzelnen verwirft oder großzügig liest, lässt sich von außen nicht messen. Belegbar ist nur, dass sie den eigenen Regeln der Formate widersprechen, und dass ein strenger Leser an ihnen scheitert.
lastmod: ein Datum für alles
Von den freiwilligen Feldern verwendet Google nur lastmod, und das nur, wenn es nachweislich stimmt. priority und changefreq ignoriert Google; trotzdem stehen sie bei 9 der 18 Seiten.
Bei 7 Seiten trägt mindestens eine Datei bei jedem Eintrag dasselbe Datum, darunter Cloudflare (933 Einträge, ein Datum), eine Ikea-Datei (4.617 Einträge, ein Datum) und Booking (3.032 Einträge je Sprachdatei, ein Datum). So ein Wert beschreibt den Lauf des Generators, nicht die Seiten. Bei 6 Seiten steht in keiner gemessenen Datei ein lastmod. Glaubhaft wirken die Werte bei heise.de (8.913 verschiedene unter 10.000), der New York Times (736 unter 745) und wordpress.org (51 unter 52).
Ein Fall, den kein Validator in einer Datei sieht, fand sich auf der eigenen Seite. Der Yoast-Index nannte am Messtag für post-sitemap.xml den 28. September als letzte Änderung, der jüngste Eintrag in dieser Datei trug den 1. Oktober. Das lastmod im Index soll die Änderung der Kinddatei beschreiben; um das zu prüfen, müssen beide Dateien nebeneinanderliegen.
Die Ortsregel und das XSD
Zwei Regeln des Protokolls brechen große Seiten fast durchweg. Die erste ist die Ortsregel: Eine Sitemap unter /sitemaps/sitemap.xml darf nach sitemaps.org nur Adressen unterhalb von /sitemaps/ enthalten. Bei zehn der 18 Seiten verstößt mindestens eine gemessene Datei gegen diese Regel, meist weil sie in einem Unterordner wie /sitemaps/ liegt und Adressen darüber listet. Bei gov.uk, Ikea, Otto, MDN und den drei Nachrichtenseiten betrifft das jede Adresse der gemessenen Dateien. Google wertet solche Dateien trotzdem, wenn sie in der Search Console eingereicht sind. Der Validator meldet die Ortsregel deshalb als Hinweis und nur, wenn die Adresse der Datei angegeben ist.
Die zweite ist das Schema. Das XSD von sitemaps.org lässt Elemente aus fremden Namensräumen nur mit processContents="strict" zu. Eine korrekte Bild-Sitemap mit einem einzigen image:image fällt bei einer reinen XSD-Prüfung deshalb durch; libxml2 2.9.14 meldete „No matching global element declaration available, but demanded by the strict wildcard“. Wer mit dem XSD prüft, muss die Schemas der Erweiterungen mitladen. Ebenso streng ist das XSD bei der Zeit: 2026-10-01T14:05 ohne Sekunden ist dort ungültig, mit Sekunden, aber ohne Zeitzone gültig, im W3C-Format, auf das sitemaps.org verweist, dagegen nicht.
Eine Sitemap vor dem Veröffentlichen prüfen
Für die Kette aus Wohlgeformtheit, Protokoll und Erweiterungen genügt kein einzelner Befehl. Der Sitemap Checker & Validator in der Toolbox nimmt eingefügtes XML oder eine Datei, auch gepackt, und prüft im Browser:
- Wohlgeformtheit mit Zeile und Spalte, etwa ein nicht maskiertes
&oder ein abgeschnittenes Dateiende, - Namensraum, Kodierung und die Grenzen von 50.000 Einträgen und 50 MB,
loc,lastmod,changefreq,priorityund ihre Reihenfolge nach dem XSD,- hreflang mit gültigen Codes, Selbstbezug und Rückverweis innerhalb der Datei,
- die Pflichtfelder und Grenzen der Bild-, Video- und News-Erweiterungen samt der abgekündigten Tags,
- mit angegebener Dateiadresse die Ortsregel.
Die Datei verlässt dabei den Browser nicht. Was die Adressen live antworten, ob sie umleiten, ein noindex tragen oder ein Canonical auf eine andere Adresse, prüft der XML-Sitemap-Auditor an der veröffentlichten Fassung.
Einordnung und Grenzen
Gemessen wurden 24 Domains an einem Tag, je Index drei Kinddateien. Ikea allein hat 2.166 Dateien; was in den übrigen steht, sagt die Messung nicht. Sechs Domains blieben unlesbar, zwei davon wegen einer Abweisung, die einem Crawler mit bekanntem Namen womöglich nicht widerfährt. Und die Messung beschreibt Verstöße gegen die Formate, nicht ihre Folgen in der Suche: Wie nachsichtig Google mit einem falschen Namensraum oder einem en-US umgeht, ist nicht dokumentiert.
Fragen und Antworten
Warum fällt eine korrekte Bild-Sitemap bei der Prüfung gegen das XSD von sitemaps.org durch?
Das Schema lässt Elemente aus fremden Namensräumen nur mit processContents="strict" zu. Ein streng prüfender Leser muss für image:image deshalb eine Deklaration finden, und die steht nicht im Sitemap-Schema, sondern in einem eigenen Schema der Erweiterung. Wer nur sitemap.xsd lädt, bekommt für jede Erweiterung einen Fehler, auch wenn die Datei völlig in Ordnung ist. Abhilfe schafft, die Schemas der verwendeten Erweiterungen mitzuladen oder die Erweiterungen nach ihren dokumentierten Regeln zu prüfen statt nach dem XSD.
Gehört hreflang besser in die Sitemap oder in den Kopf der Seite?
Google nimmt Sprachfassungen auf drei Wegen an: als link-Element im HTML-Kopf, als HTTP-Kopfzeile und in der Sitemap. Für die Auswertung sind die Wege gleichwertig; verschieden sind die Kosten.
In der Sitemap wächst die Zahl der Einträge mit dem Quadrat der Fassungen, weil jede Fassung alle anderen und sich selbst aufführt. Die gemessene Ikea-Datei kam so mit 4.617 Adressen auf 95,3 Prozent der 50-MB-Grenze. Dafür bleiben die Seiten selbst schlank, und die Angaben stehen an einer Stelle, an der ein Validator Selbstbezug und Rückverweise in einem Durchgang prüfen kann.
Im HTML-Kopf trägt jede Seite nur ihre eigene Gruppe, und die Angaben ändern sich zusammen mit der Seite. Bei wenigen Sprachen ist das meist der einfachere Weg; bei Dutzenden Märkten spricht mehr für die Sitemap, dann aber mit einer Aufteilung nach Bytes statt nach Adressen. Beide Wege zugleich zu pflegen verdoppelt die Fehlerquellen, weil zwei Listen derselben Gruppe auseinanderlaufen können.
Wie lässt sich eine Sitemap mit mehr als 50.000 Adressen sauber aufteilen?
Über einen Index, der auf mehrere Dateien zeigt. Dabei helfen vier Regeln:
- Die Kinddateien liegen im Ordner des Index oder darunter, wie es Google für Indizes verlangt.
- Die Aufteilung folgt einem Merkmal, das sich nicht ständig ändert, etwa Inhaltsart oder Sprache; eine laufende Nummer schiebt Adressen bei jedem Neubau in andere Dateien.
- Das
lastmodim Index beschreibt die letzte Änderung der jeweiligen Kinddatei und wird mit ihr neu geschrieben. - Ein Index zeigt auf Sitemaps, nicht auf weitere Indizes, denn Verschachtelung sagt keine der beiden Spezifikationen zu.
Quellen
- sitemaps.org – Sitemaps XML format
- sitemaps.org – sitemap.xsd
- Google Search Central – Build and submit a sitemap
- Google Search Central – Manage your sitemaps with a sitemap index file
- Google Search Central – Tell Google about localized versions of your page
- Google Search Central – Image sitemaps
- Google Search Central – Video sitemaps and alternatives
- Google Search Central – Create a news sitemap
- W3C – Date and Time Formats
Passend dazu