

 English
 Deutsch
 Polski
Self-Hosted Large Language Model (LLM) mit Ollama hinter einem Auth-Proxy

Management Summary
Ein Sprachmodell erzeugt Textantworten auf Eingaben. Mit Ollama auf eigener Hardware lässt sich diese Funktion für Anwendungen bereitstellen und stärker kontrollieren, wo Antworten entstehen und wer darauf zugreifen darf. Ollamas lokale Verbindung besitzt keine eingebaute Anmeldeprüfung. Ein geschützter Vermittler kann deshalb den Zugang prüfen, bevor Anfragen weitergehen. Der Beitrag erklärt diesen Aufbau eines eigenen KI-Dienstes und die weiterhin nötigen Regeln für Zugriff und Datenspeicherung.
Inhalt
Inferenz bezeichnet hier das Erzeugen einer Antwort durch das Modell. Ein lokales Sprachmodell kann diese Verarbeitung auf kontrollierter Hardware ausführen. Selbsthosting allein garantiert jedoch weder Isolation noch Datenschutzkonformität oder die Leistung eines Clouddienstes. Die lokale Ollama-API besitzt keine eingebaute Authentifizierung. Ein Reverse-Proxy nimmt Anfragen für Ollama entgegen, prüft Zugangsdaten und übernimmt die verschlüsselte TLS-Verbindung; Netzwerkgrenzen, ausgehende Verbindungen, Speicherung und Anwendungsverhalten bleiben eigenständige Aufgaben.
1. Die tatsächliche Grenze festlegen
Das Beispiel veröffentlicht nur einen minimalen Generierungsendpunkt über nginx. Loopback bezeichnet die eigene lokale Netzwerkadresse des Rechners, hier 127.0.0.1. Der Proxy lauscht auf der IPv4-Loopback-Adresse des Docker-Hosts, nicht auf sämtlichen Netzwerkschnittstellen. Für entfernte Zugriffe ist ein gesondert geplanter VPN- oder privater Netzwerkzugang erforderlich. Der Ollama-Container veröffentlicht keinen Port. Docker-Host und Container im selben Backend-Netz können Ollama weiterhin direkt erreichen; fremde Anwendungen gehören daher nicht in dieses Netz.
Eine normale Docker-Bridge erlaubt ausgehenden Verkehr. Modell-Downloads funktionieren deshalb, eine vollständige Netztrennung besteht aber nicht. OLLAMA_NO_CLOUD=1 deaktiviert Ollama-Cloudfunktionen in unterstützenden Versionen; zusätzlich muss ein lokales Modell ausgewählt sein. Die Einstellung sperrt keine externen Werkzeuge, Weboberflächen oder Host-Verbindungen. Strikter Offlinebetrieb benötigt kontrollierte Modellbereitstellung und unabhängig durchgesetzte Ausgangssperren.
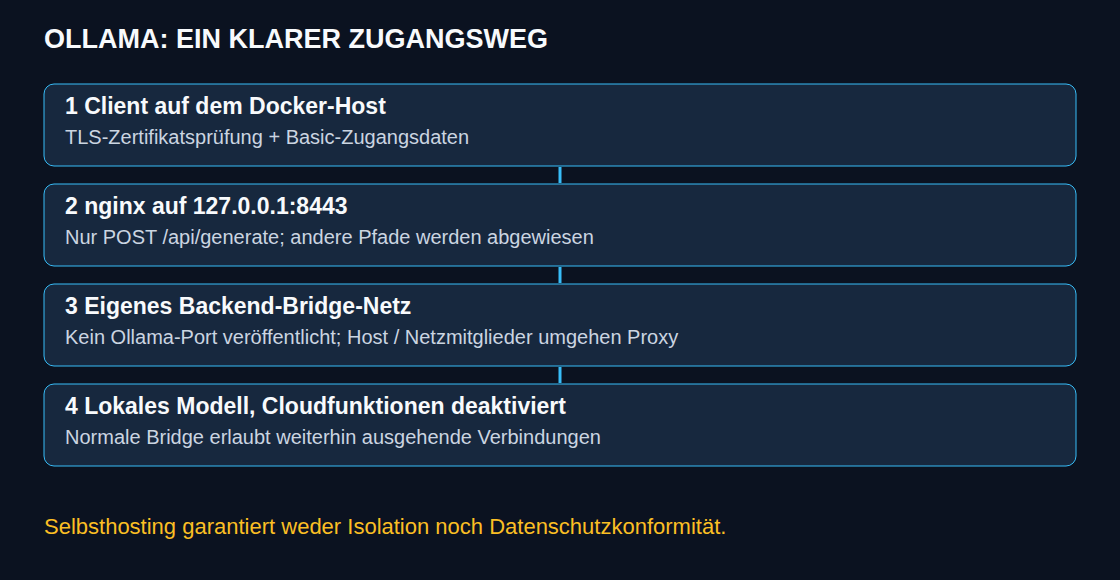
Das Netzwerkbeispiel setzt eine aktuelle Docker Engine im normalen NAT-Bridge-Modus voraus. Docker dokumentiert bei Versionen vor 28.0.0 eine Erreichbarkeit von Loopback-Freigaben durch Nachbarrechner; eigene Direct-Routing-Einstellungen benötigen ebenfalls eine gesonderte Prüfung.
2. Container und Zertifikate vorbereiten
Die folgende compose.yaml ist eine Ausgangskonfiguration für CPU-Inferenz, keine vollständige Unternehmensinstallation. OLLAMA_IMAGE und NGINX_IMAGE müssen geprüfte Image-Referenzen enthalten, vorzugsweise unveränderliche Digests. Vor der Modellwahl sind Speicherbedarf, Kontextlänge, Modelllizenz und Rechnerarchitektur zu prüfen.
services:
  ollama:
    image: ${OLLAMA_IMAGE:?Set a reviewed Ollama image tag or digest}
    restart: unless-stopped
    environment:
      OLLAMA_HOST: 0.0.0.0:11434
      OLLAMA_NO_CLOUD: "1"
    volumes:
      - ollama_data:/root/.ollama
    networks:
      - llm_backend
  auth_proxy:
    image: ${NGINX_IMAGE:?Set a reviewed nginx image tag or digest}
    restart: unless-stopped
    ports:
      - "127.0.0.1:8443:443"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
      - ./certs:/etc/nginx/certs:ro
      - ./htpasswd:/etc/nginx/.htpasswd:ro
    depends_on:
      - ollama
    networks:
      - llm_backend
networks:
  llm_backend:
    driver: bridge
volumes:
  ollama_data:
Vor dem Start müssen nginx.conf, Passwortdatei und Zertifikate vorhanden sein. Das Zertifikat muss llm.example.internal als Subject Alternative Name enthalten; der Client benötigt das Zertifikat der ausstellenden CA. htpasswd -cB ./htpasswd api_user erstellt interaktiv eine neue Passwortdatei mit bcrypt. Die Option -c überschreibt eine vorhandene Datei und entfällt deshalb bei späteren Kontoänderungen. Dateirechte müssen nginx das Lesen erlauben und fremden Zugriff begrenzen; private Schlüssel benötigen entsprechenden Schutz.
NVIDIA-Beschleunigung erfordert zusätzlich eine kompatible GPU, Treiber, NVIDIA Container Toolkit und eine GPU-Reservierung im Ollama-Dienst. Quantisierung allein macht CPU-Ausführung nicht GPU-beschleunigt. depends_on ordnet den Containerstart, bestätigt aber keine Modellbereitschaft. Ein neu erzeugtes Backend kann außerdem einen Proxy-Neustart erfordern, weil diese einfache Upstream-Konfiguration die Dienstadresse beim nginx-Start auflöst.
3. Den Proxy auf die benötigte Operation begrenzen
Diese nginx.conf erlaubt nur authentifizierte POST-Anfragen an /api/generate. Andere Pfade liefern 404; andere Methoden am erlaubten Pfad werden abgewiesen. Modellverwaltung bleibt außerhalb der gemeinsamen API. Vor der Weiterleitung entfernt der Proxy die Basic-Zugangsdaten.
events { worker_connections 1024; }
http {
    upstream ollama_backend { server ollama:11434; }
    server {
        listen 443 ssl;
        server_name llm.example.internal;
        ssl_certificate /etc/nginx/certs/server.crt;
        ssl_certificate_key /etc/nginx/certs/server.key;
        ssl_protocols TLSv1.2 TLSv1.3;
        client_max_body_size 1m;
        location = /api/generate {
            limit_except POST { deny all; }
            auth_basic "Local inference";
            auth_basic_user_file /etc/nginx/.htpasswd;
            proxy_pass http://ollama_backend;
            proxy_http_version 1.1;
            proxy_set_header Host ollama:11434;
            proxy_set_header Authorization "";
            proxy_set_header Connection "";
            proxy_buffering off;
            proxy_cache off;
            proxy_connect_timeout 5s;
            proxy_read_timeout 600s;
            proxy_send_timeout 60s;
        }
        location / { return 404; }
    }
}
Basic Auth authentifiziert ein Dienstkonto, nicht individuelle Dokumentberechtigungen. Starke Zugangsdaten, Kontosperrung, Anfragen- und Parallelitätsgrenzen sowie Logaufbewahrung benötigen weiterhin ein Betriebskonzept. Das Anfragelimit von 1 MiB ist beispielhaft und kann für Bilder zu klein sein. Eine kompromittierte berechtigte Anwendung kann weiterhin aufwendige Anfragen stellen oder verfügbare Modelle auswählen.
4. Die Verbindung mit Zertifikatsprüfung testen
Nach dem Dienststart kann docker compose exec ollama ollama pull llama3.1:8b ein Modell bereitstellen. Die Kennung bezeichnet ein beispielhaftes lokales Modell und ist keine Hardwareempfehlung. Pull lädt ein Modell herunter; ollama run startet zusätzlich eine interaktive Sitzung. Der folgende curl-Aufruf läuft auf dem Docker-Host, fragt das Passwort ab und prüft das Serverzertifikat anhand der angegebenen CA:
curl --cacert ./certs/ca.crt --resolve llm.example.internal:8443:127.0.0.1 --user api_user --header 'Content-Type: application/json' --data '{"model":"llama3.1:8b","prompt":"Return the word test.","stream":false}' https://llm.example.internal:8443/api/generateDer Testprompt enthält keine Unternehmensdaten. Eine Aufforderung zur Zusammenfassung einer Richtlinie stellt eine fehlende Richtlinie nicht automatisch bereit. Zur Prüfung gehören fehlende und falsche Zugangsdaten, eine gültige Anfrage, gesperrte Verwaltungspfade, Streaming, ein ausgefallenes Backend und die tatsächliche Portfreigabe. Syntaxprüfungen wie docker compose config und nginx -t sind Voraussetzungen, aber kein Beleg einer wirksamen Sicherheitsgrenze.
Fragen und Antworten
Funktionieren Open WebUI oder OpenAI-kompatible Clients unverändert?
Nein. Der minimale Zugang veröffentlicht ausschließlich den nativen Generierungsendpunkt. Eine Weboberfläche benötigt weitere geprüfte Endpunkte und einen Netzwerkweg zum Proxy ohne direkten Backend-Zugang. Benutzername und Passwort innerhalb einer URL sind keine allgemein funktionierende Anbindung und können in Konfiguration oder Logs sichtbar werden. OpenAI-kompatible Clients senden üblicherweise Bearer-Authentifizierung; nginx Basic Auth erwartet ein anderes Schema. Die Anbindung erfordert eine ausdrückliche Authentifizierungsanpassung oder einen Zugang mit passender Tokenprüfung sowie die benötigten /v1/-Pfade. API-Kompatibilität umfasst nur einen Teil der Funktionen.
Begrenzen 600 Sekunden die gesamte Antwort?
Nein. proxy_read_timeout begrenzt die Pause zwischen Lesevorgängen vom Backend. Streaming-Fragmente können die Gesamtdauer darüber hinaus verlängern; ein generiertes Token entspricht nicht zwingend einem Netzwerk-Lesevorgang. Ohne Streaming können Modellladen und Generierung die erste Antwort verzögern. Der Verbindungsaufbau hat mit fünf Sekunden eine eigene Frist. Passende Timeouts müssen unter der vorgesehenen Last ermittelt werden.
Garantiert Selbsthosting Datenschutz?
Nein. Zugriffsrechte, Rechtsgrundlage, Aufbewahrung, Sicherungen, Anwendungslogs und externe Integrationen bleiben relevant. Ein lokales Backend entspricht außerdem nicht dem vollständigen Produkt ChatGPT. Das Ergebnis ist ein definierter Inferenzdienst mit prüfbarem Zugangsweg, keine Garantie für Konformität, Qualität oder vollständige Isolation.
Passend dazu


