English
 Deutsch
 Polski
Verhaltensmodellierung in GA4: Die zwei Voraussetzungen und wo modellierte Werte erscheinen

Inhalt
Die verbreitete Beruhigung nach der Einführung des Consent Mode lautete, die Modellierung fange die Ablehnungen schon auf. Für die meisten Auftritte ist das nicht wahr, und der Grund steht in zwei Sätzen auf Googles Hilfeseite.
Die Verhaltensmodellierung braucht mindestens 1.000 Ereignisse je Tag mit verweigerter Speicherung, an mindestens sieben Tagen. Und sie braucht mindestens 1.000 tägliche Nutzer, die Ereignisse mit erteilter Speicherung senden, an mindestens sieben der vorangegangenen 28 Tage. Beide Bedingungen gleichzeitig.
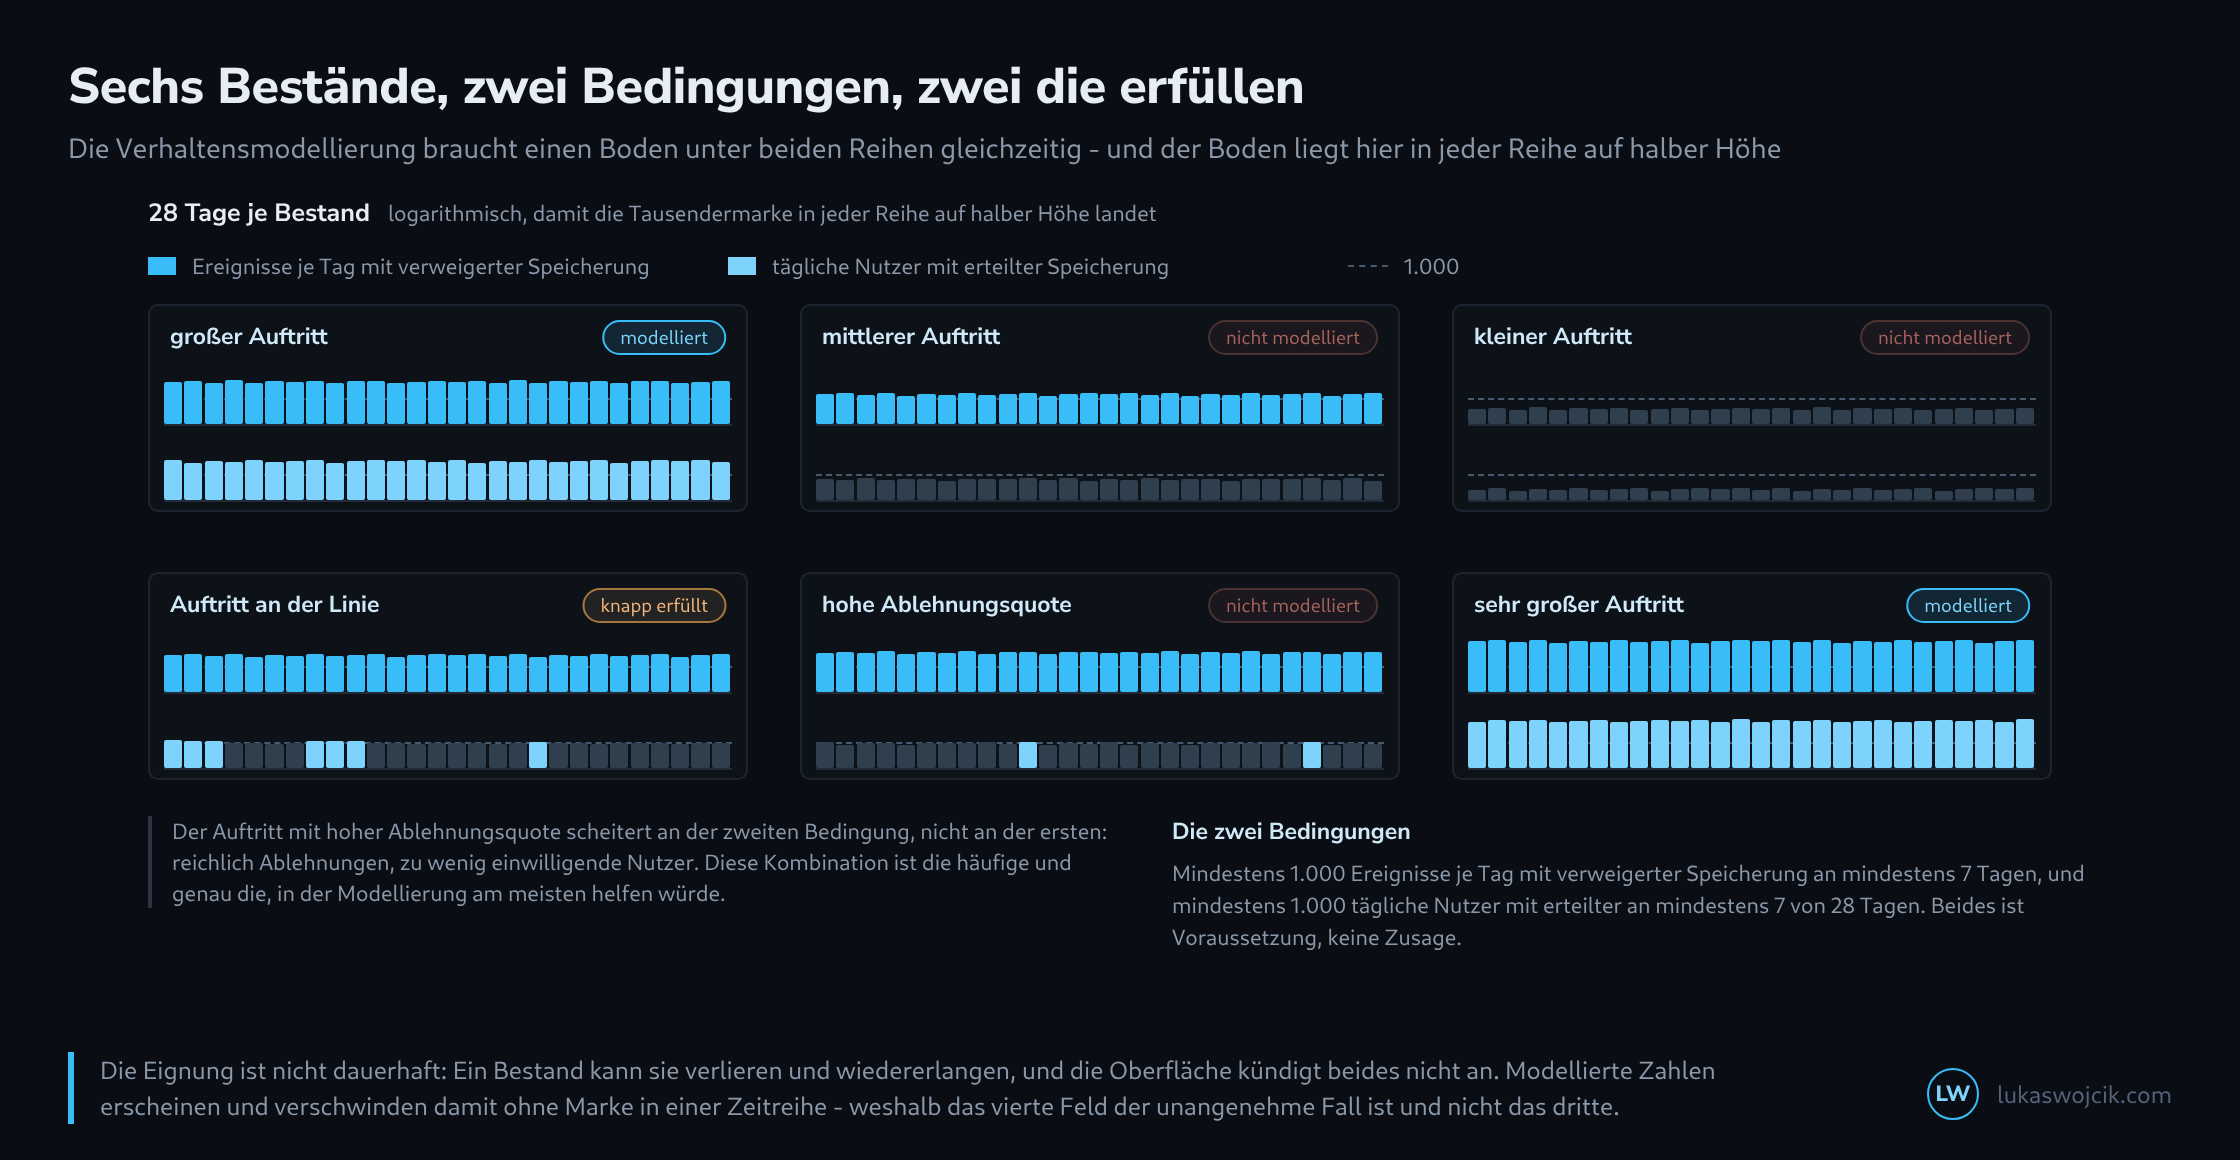
Die zwei Bedingungen sind nicht symmetrisch
Der Unterschied im Wortlaut ist leicht zu überlesen und entscheidet den Fall: Die erste Bedingung zählt Ereignisse, die zweite zählt Nutzer. Ein Auftritt mit vielen Seitenaufrufen je Besuch erreicht die erste Marke deutlich früher als die zweite, denn ein Mensch erzeugt an einem Tag ein Dutzend Ereignisse, aber bleibt ein Nutzer.
Dazu kommt die Fensterung. Die erste Bedingung verlangt sieben Tage, die zweite sieben von 28. Beides sind Mindestwerte auf gleitenden Fenstern, und keines davon steht irgendwo in der Oberfläche als Fortschrittsanzeige.
Warum die zweite Bedingung die schwierigere ist
Die Modellierung braucht Vorbilder. Sie überträgt das Verhalten der einwilligenden Menschen auf die ablehnenden, und dafür braucht sie genug einwilligende – nicht genug ablehnende. Damit gerät ein Auftritt mit hoher Ablehnungsquote in eine unangenehme Lage: Er hat reichlich Lücken zu füllen und zu wenig Material, mit dem sich füllen ließe.
Genau dieser Fall steht im Bild als fünftes Feld. Die obere Reihe liegt weit über der Linie, die untere knapp darunter, und das Urteil lautet trotzdem: nicht modelliert. Wer nur die Ablehnungsquote betrachtet, hält das für einen Fehler.
Wo modellierte Zahlen stehen und wo nicht
Sind die Schwellen erreicht, erscheinen geschätzte Werte in den Standardberichten, etwa bei Nutzern, Sitzungen und neuen Nutzern. Die Liste dessen, wo sie nicht erscheinen, ist länger und praktisch wichtiger.
Modellierte Werte erscheinen

  Standardberichte          Nutzer, Sitzungen, neue Nutzer

Modellierte Werte erscheinen nicht

  BigQuery-Export           gar nicht
  Zielgruppen               nicht
  Nutzer-Explorer           nicht
  Kohortenanalyse           nicht
  Segmente mit Abfolgen     nicht
  Bindungsberichte          nicht
  Vorhersagemetriken        nicht
  Pfad- und Trichteranalyse anders behandelt

  Folge: Oberflaeche und Export zaehlen unterschiedlich, und
  beide haben recht. Der Unterschied ist die Modellierung.
Damit hat der Bericht in der Oberfläche eine Zahl, die im Export nicht zu reproduzieren ist – und zwar nicht durch einen Fehler, sondern weil die eine Zahl eine Schätzung enthält und die andere nicht. Wer beide Quellen nebeneinander benutzt und die Abweichung sucht, sucht nach etwas, das keine Ursache in den Daten hat.
Die Eignung ist nicht dauerhaft
Googles Seite hält ausdrücklich fest, dass ein Bestand, der die Voraussetzungen einmal erfüllte und später nicht mehr, die geschätzten Daten verliert – und sie wiederbekommt, wenn er sie wieder erfüllt. Angekündigt wird keiner der beiden Übergänge.
Für eine Zeitreihe heißt das, dass sich die Zählweise mitten im Verlauf ändern kann, ohne dass ein Hinweis daran steht. Ein Auftritt mit saisonalem Verkehr durchläuft das womöglich zweimal im Jahr. Das vierte Feld im Bild ist deshalb der unangenehme Fall, nicht das dritte: Wer die Linie klar verfehlt, hat wenigstens eine gleichmäßige Zeitreihe.
Ebenso hält die Seite fest, dass die äußeren Voraussetzungen keine Zusage sind. Das Modell legt eigene Kriterien darüber, und genannt werden das Verhältnis neuer zu wiederkehrenden Nutzern und das Verhältnis von Nutzern zu Sitzungen.
Was sich daraus ergibt
Die Schwellen selbst lassen sich nachrechnen, und das ist der erste Schritt. Zwei Zahlen genügen: Ereignisse je Tag mit verweigerter Speicherung und täglich einwilligende Nutzer. Beide stehen im Bestand, und die Antwort ist ein Ja oder Nein, kein Gefühl.
Fällt die Antwort auf Nein, ist die Folge nicht Ratlosigkeit, sondern Klarheit: Die Berichtszahlen sind dann ausschließlich gezählte Werte einwilligender Menschen, und der ablehnende Teil fehlt ganz. Das ist eine ehrlichere Grundlage als eine Zahl, von der niemand weiß, welcher Anteil daran geschätzt ist. Wer den fehlenden Teil trotzdem einschätzen will, kommt an einer eigenen Rechnung nicht vorbei – und die beginnt mit der Ablehnungsquote, die ohnehin messbar ist.
Fragen und Antworten
Wie viele tägliche Nutzer braucht ein Auftritt mit hoher Ablehnungsquote, damit die Modellierung überhaupt in Frage kommt?
Die zweite Bedingung lässt sich direkt umrechnen. Sind 1.000 einwilligende Nutzer je Tag nötig und lehnt der Anteil q ab, braucht der Auftritt insgesamt mindestens 1.000 / (1 − q) Nutzer am Tag. Bei einer angenommenen Ablehnungsquote von 60 Prozent sind das 2.500, bei 80 Prozent 5.000, jeweils an mindestens sieben der vorangegangenen 28 Tage. Die Rechnung setzt voraus, dass sich die Quote auf Nutzer bezieht; eine Quote je Sitzung oder je Bannereinblendung kann davon abweichen.
Die erste Bedingung ist dann meist schon erfüllt, allerdings nur, wenn Ablehnende überhaupt Ereignisse senden. Das geschieht nur, wenn das Tag auch ohne Einwilligung lädt und Pings ohne Cookies schickt, wie im erweiterten Consent Mode. Im einfachen Modus lädt das Tag erst nach der Einwilligung, es entstehen keine Ereignisse mit verweigerter Speicherung, und die erste Bedingung bleibt bei null, gleich wie groß der Auftritt ist.
Hängt es auch von einer Einstellung in GA4 ab, ob modellierte Werte erscheinen?
Ja, von der Einstellung Reporting Identity, die festlegt, welche Kennungen GA4 heranzieht, um Aktivitäten Nutzern zuzuordnen. Modellierte Werte erscheinen nur mit der Option Blended; mit Observed oder Device-based zeigen die Berichte ausschließlich gezählte Werte, auch wenn beide Schwellen erreicht sind. Die Einstellung wirkt nur auf die Berichte, nicht auf die Datenerhebung, und ein Wechsel ändert deshalb auch rückwirkend, welche Zahl eine Zeitreihe zeigt.
Passend dazu