English
 Deutsch
 Polski
GA4-Hostname-Filter: Geister-Spam aus dem Measurement Protocol entfernen und die richtige Reihenfolge

Inhalt
Eine Messkennung steht im Quelltext jeder Seite, die sie benutzt. Wer sie dort abliest, kann Treffer unmittelbar an die Sammelstelle schicken, ohne den Auftritt je aufzurufen – die Sammelstelle, an die auch das Tag im Browser sendet, verlangt keinen Nachweis, dass ein Besuch stattgefunden hat; das Measurement Protocol bräuchte zusätzlich den Schlüssel api_secret, der nicht im Quelltext steht. Diese Treffer erscheinen anschließend in den Berichten wie Besuche, und der Hostname darin ist frei erfunden.
Seit dem 11. Juni 2026 gibt es dagegen ein Werkzeug in der Verwaltung: den Hostname-Filter, eine neue Art Datenfilter, die Ereignisse anhand ihres Hostnamens ausschließt. Er hilft, aber er hat zwei Eigenschaften, die vor dem Einschalten bekannt sein sollten.
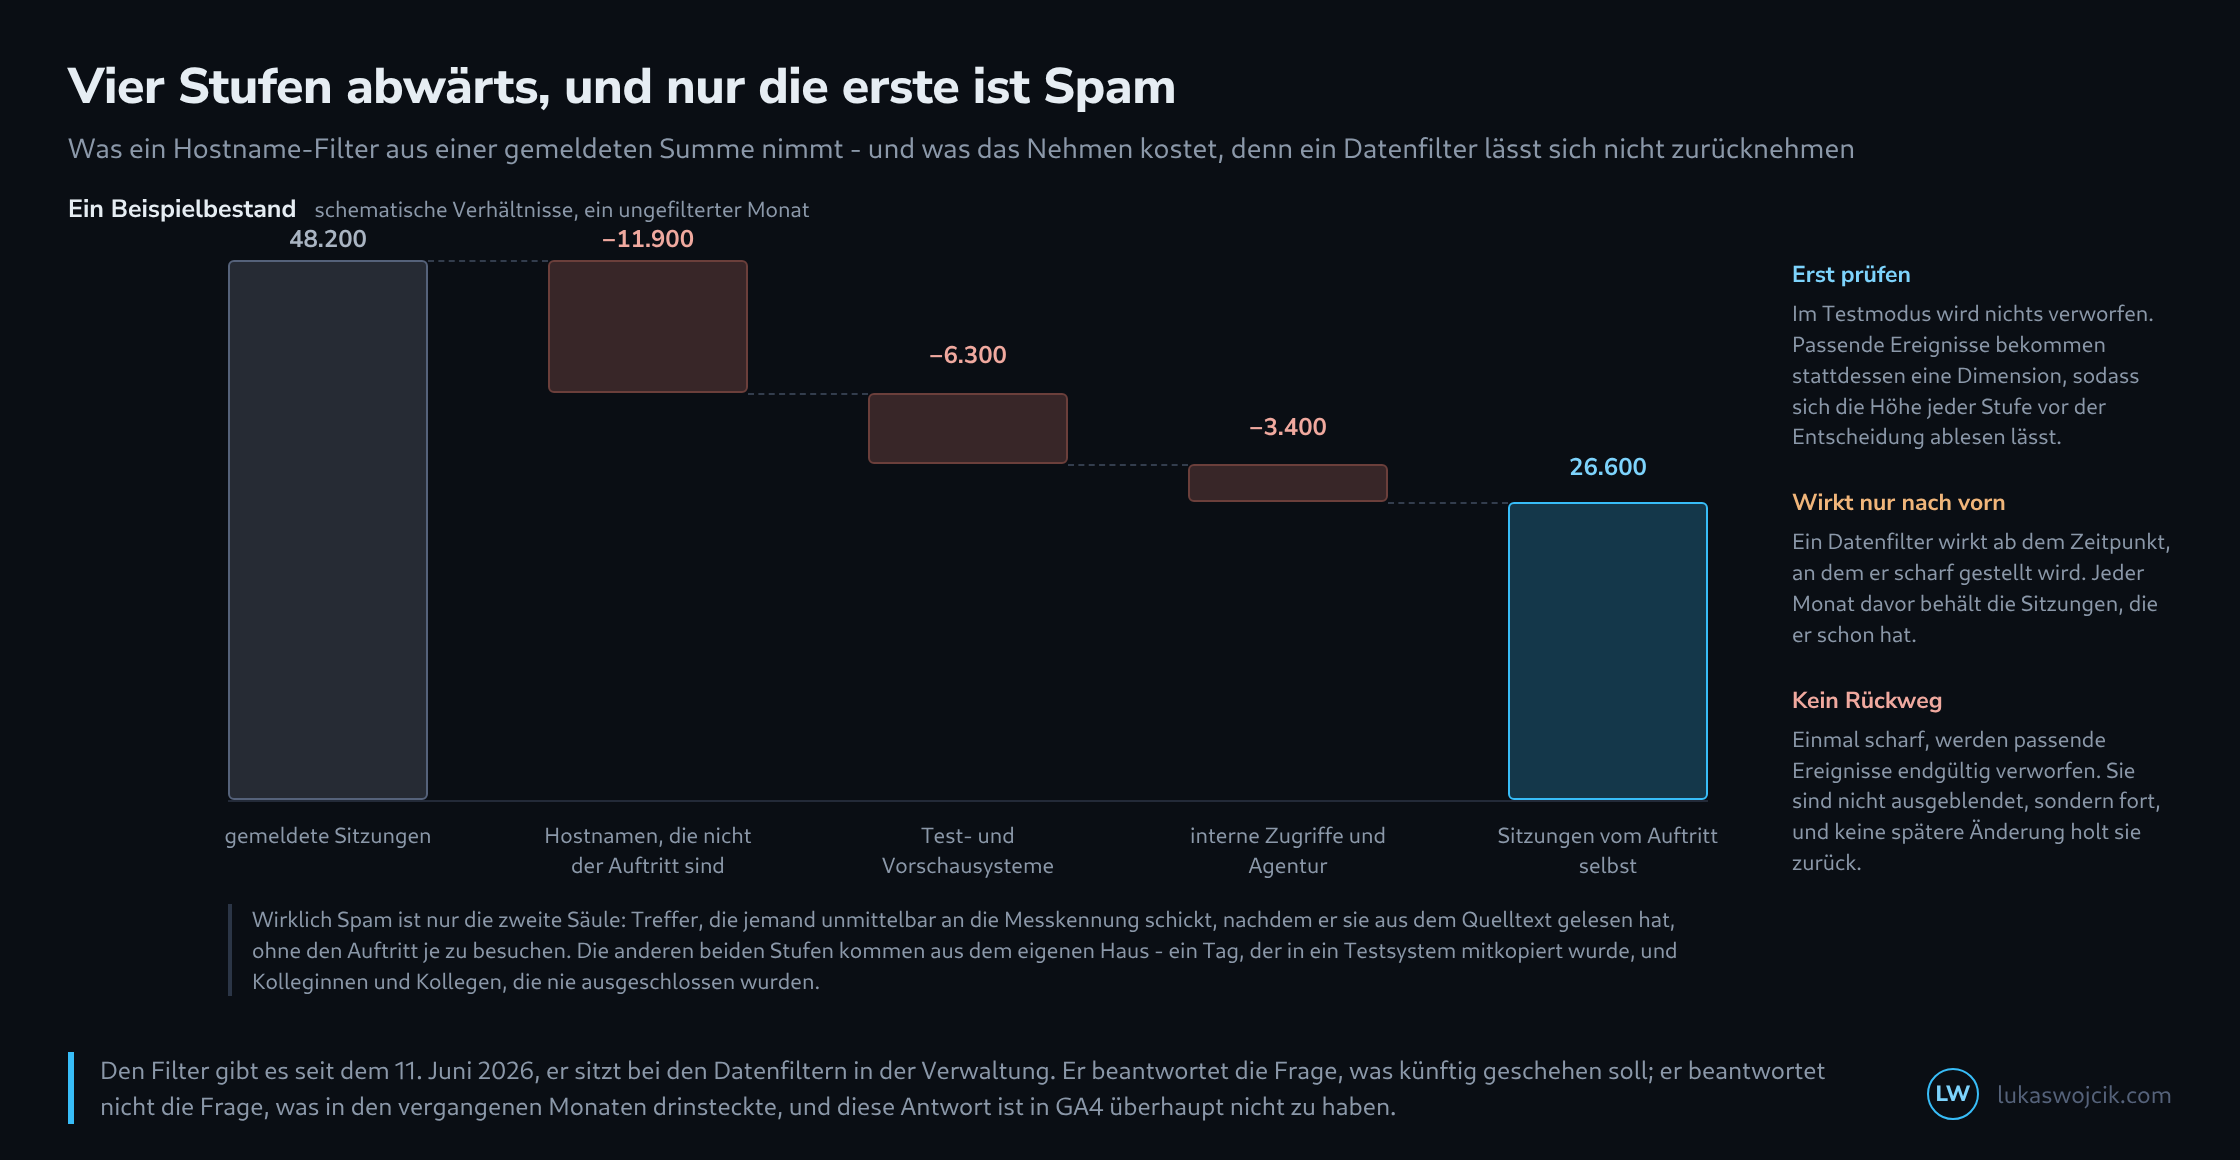
Woher die fremden Hostnamen kommen
Jedes Ereignis, das GA4 erreicht, trägt einen Hostnamen mit – die Domain, von der es angeblich stammt. Bei einem echten Besuch setzt ihn der Browser, und er stimmt. Bei einem unmittelbar gesendeten Treffer setzt ihn der Absender, und dann steht dort, was er hineinschreibt.
Der übliche Fall ist stumpfe Werbung: ein Hostname wie eine fremde Domain, der in der Hoffnung auftaucht, dass jemand ihn im Bericht sieht und nachschlägt. Der lästige Fall ist Streuung, weil solche Sender oft dieselbe Kennung an viele Bestände verteilen. In beiden Fällen ist der Schaden nicht der Inhalt, sondern die Verwässerung: Abschlussraten sinken, weil der Nenner wächst, und Kanalberichte bekommen Zeilen, die niemand zuordnen kann.
Die beiden anderen Stufen sind hausgemacht
In der Praxis ist Spam selten der größte Posten. Häufiger sind zwei andere Quellen. Die erste ist die Testumgebung: Wird ein Auftritt für die Entwicklung geklont, wandert der Container mit, und ab da meldet ein System unter einem Namen wie test.beispiel.de Sitzungen in denselben Bestand. Die zweite sind interne Zugriffe – Redaktion, Agentur, Prüfläufe -, die nie ausgeschlossen wurden.
Beide sehen im Bericht aus wie echter Verkehr, weil sie echter Verkehr sind. Nur eben nicht der, um den es geht. Der Hostname-Filter erwischt die erste dieser beiden Quellen zuverlässig, weil sie einen eigenen Namen trägt; die zweite braucht weiterhin einen Filter auf die Herkunft oder eine Kennzeichnung im Container.
Die erste Eigenschaft: Ein Filter wirkt nur nach vorn
Ein Datenfilter greift ab dem Zeitpunkt, an dem er scharf gestellt wird. Alles, was vorher erhoben wurde, bleibt genau so in den Berichten stehen, wie es war. Das ist keine Einschränkung, die sich umgehen ließe – GA4 kennt kein nachträgliches Filtern eines vorhandenen Bestandes.
Praktisch bedeutet das eine Stufe in jeder Zeitreihe, die über den Einschalttag hinausreicht. Wer den Filter an einem Dienstag scharf stellt, hat ab Mittwoch weniger Sitzungen, und kein Bericht sagt dazu etwas. Wo es auf Vergleichbarkeit ankommt, gehört dieser Tag notiert, am besten dort, wo auch die Kampagnen notiert werden.
Die zweite Eigenschaft: Es gibt keinen Rückweg
Ein aktiver Datenfilter verwirft die passenden Ereignisse endgültig. Sie werden nicht ausgeblendet und liegen nicht in einem Papierkorb – sie kommen nicht in den Bestand. Ein zu weit gefasster Filter löscht also still und dauerhaft echte Daten, und der Fehler fällt möglicherweise erst Wochen später auf.
Genau dafür gibt es den Testmodus, und er ist der eigentliche Grund, diesen Filter überhaupt zu mögen. Im Testmodus wird nichts verworfen; passende Ereignisse bekommen stattdessen eine Dimension mit dem Namen des Filters. Damit lässt sich vor der Entscheidung ablesen, wie viel ein Filter treffen würde – und ob darunter etwas ist, das bleiben soll.
Reihenfolge, die eine Löschung erspart

  1  Bericht mit der Dimension Hostname öffnen und alle Werte
     der letzten Monate auflisten
  2  jeden Namen einer der vier Gruppen zuordnen:
     eigener Auftritt, Testsystem, intern, fremd
  3  Filter im Testmodus anlegen, eine Woche laufen lassen
  4  über die Dimension "Test data filter name" nachsehen,
     was er getroffen hätte
  5  erst danach scharf stellen und den Tag notieren

  Schritt 1 ist der wichtigste: Ein Hostname, den niemand kennt,
  ist noch kein Spam - Landingpages, Kampagnenseiten und
  Shopsysteme laufen oft unter eigenen Namen.
Was der Filter nicht leistet
Die vergangenen Monate bleiben, wie sie sind. Wer eine bereinigte Zeitreihe über einen längeren Zeitraum braucht, bekommt sie nicht aus der Oberfläche, sondern nur aus dem Export nach BigQuery – dort steht der Hostname je Ereignis, und dort lässt sich rückwirkend filtern, beliebig oft.
Das ist die eigentliche Arbeitsteilung. Der Filter in der Verwaltung sorgt dafür, dass ab heute weniger Unsinn hereinkommt. Die Frage, wie viel Unsinn bisher drin war, beantwortet er nicht, und für diese Frage führt kein Weg an den Rohdaten vorbei.
Seit dem 21. September 2026 kennt der Hostname-Filter zusätzlich einen Include-Modus (Versionshinweise zu Google Analytics). Statt einzelne Namen auszuschließen, lässt er nur Ereignisse von freigegebenen Domains herein und hält damit auch Spam-Hostnamen fern, die erst später auftauchen. Ereignisse ohne Hostnamen verwirft er dabei ebenfalls, für Ereignisse aus dem Measurement Protocol gilt er nicht. Was das für die Einrichtung bedeutet, beschreibt der Beitrag zum Include-Modus.
Fragen und Antworten
Warum eine Woche im Testmodus und nicht nur einen Tag?
Weil sich die vier Gruppen nicht gleichmäßig über die Woche verteilen. Interne Zugriffe und Testsysteme folgen oft Arbeitstagen und Veröffentlichungsterminen, Kampagnenseiten einzelnen Aktionen. Eine Woche deckt jeden Wochentag einmal ab; bei seltenen Anlässen wie einem monatlichen Newsletter ist auch sie noch zu kurz.
Welche fremd wirkenden Hostnamen gehören trotzdem zu echten Besuchen?
Neben den Landingpages, Kampagnenseiten und Shopsystemen aus Schritt 1 gehören dazu vor allem Übersetzungsdienste, die eine Seite samt Tag unter eigener Adresse ausliefern. Ein bekanntes Beispiel ist der Übersetzungsproxy von Google, dessen Hostnamen auf translate.goog enden und die Domain des Auftritts mit Bindestrichen enthalten, etwa www-beispiel-de.translate.goog. Dahinter stehen Menschen, die den Auftritt in einer anderen Sprache lesen.
Ob solche Besuche in den Bestand gehören, ist eine Entscheidung und kein Spamfall. Der Testmodus zeigt, wie viele es sind, bevor ein Filter sie endgültig verwirft.
Wie sieht die rückwirkende Bereinigung im BigQuery-Export konkret aus?
Der Hostname steht im Export im Feld device.web_info.hostname. Die Bereinigung läuft in zwei Schritten, die den ersten beiden Schritten der Reihenfolge im Artikel entsprechen:
- Alle vorkommenden Hostnamen mit ihrer Häufigkeit auflisten:
SELECT device.web_info.hostname AS host, COUNT(*) AS events FROM `project.analytics_XXXXXXXXX.events_*` WHERE _TABLE_SUFFIX BETWEEN '20260601' AND '20260927' GROUP BY host ORDER BY events DESC. Das ergibt die Liste, die den vier Gruppen zugeordnet wird. - Jede weitere Auswertung auf die Namen beschränken, die bleiben sollen, etwa mit
WHERE device.web_info.hostname IN ('www.beispiel.de', 'shop.beispiel.de'). Eine solche Liste erlaubter Namen fängt auch Spam-Hostnamen ab, die erst später auftauchen; eine Liste gesperrter Namen leistet das nicht.
Eine Grenze bleibt: Rückwirkend heißt hier nur bis zu dem Tag, an dem die BigQuery-Verknüpfung angelegt wurde. Der Export holt keine Historie nach, und wer ihn erst am Tag des Filters einschaltet, hat für die Zeit davor keine Rohdaten.
Passend dazu