English
 Deutsch
 Polski
Vocal-Chain in FL Studio 2026: Reihenfolge der Effekte, Einstellungen und die Wirkung jedes Schritts gemessen

Inhalt
- So wurde gemessen
- Schritt 1: eigene Mixer-Spur, Aufnahmepegel und Reinigung
- Schritt 2: Tonhöhe vor der Dynamik
- Schritt 3: Hochpass im Fruity Parametric EQ 2
- Der Hochpass gehört vor den Kompressor
- Schritt 4: Kompression im Fruity Limiter, Reiter COMP
- Schritt 5: De-Esser, und was die Kompression mit Zischlauten macht
- Vor oder hinter dem Kompressor: die Schwelle entscheidet, nicht die Stelle
- Schritt 6: Sättigung sparsam
- Hall und Delay auf Send-Spuren
- Die fertige Kette in Slot-Reihenfolge
- Nach der Kette: Bus und Lautheit
- Einordnung und Grenzen
- Fragen und Antworten
- Quellen
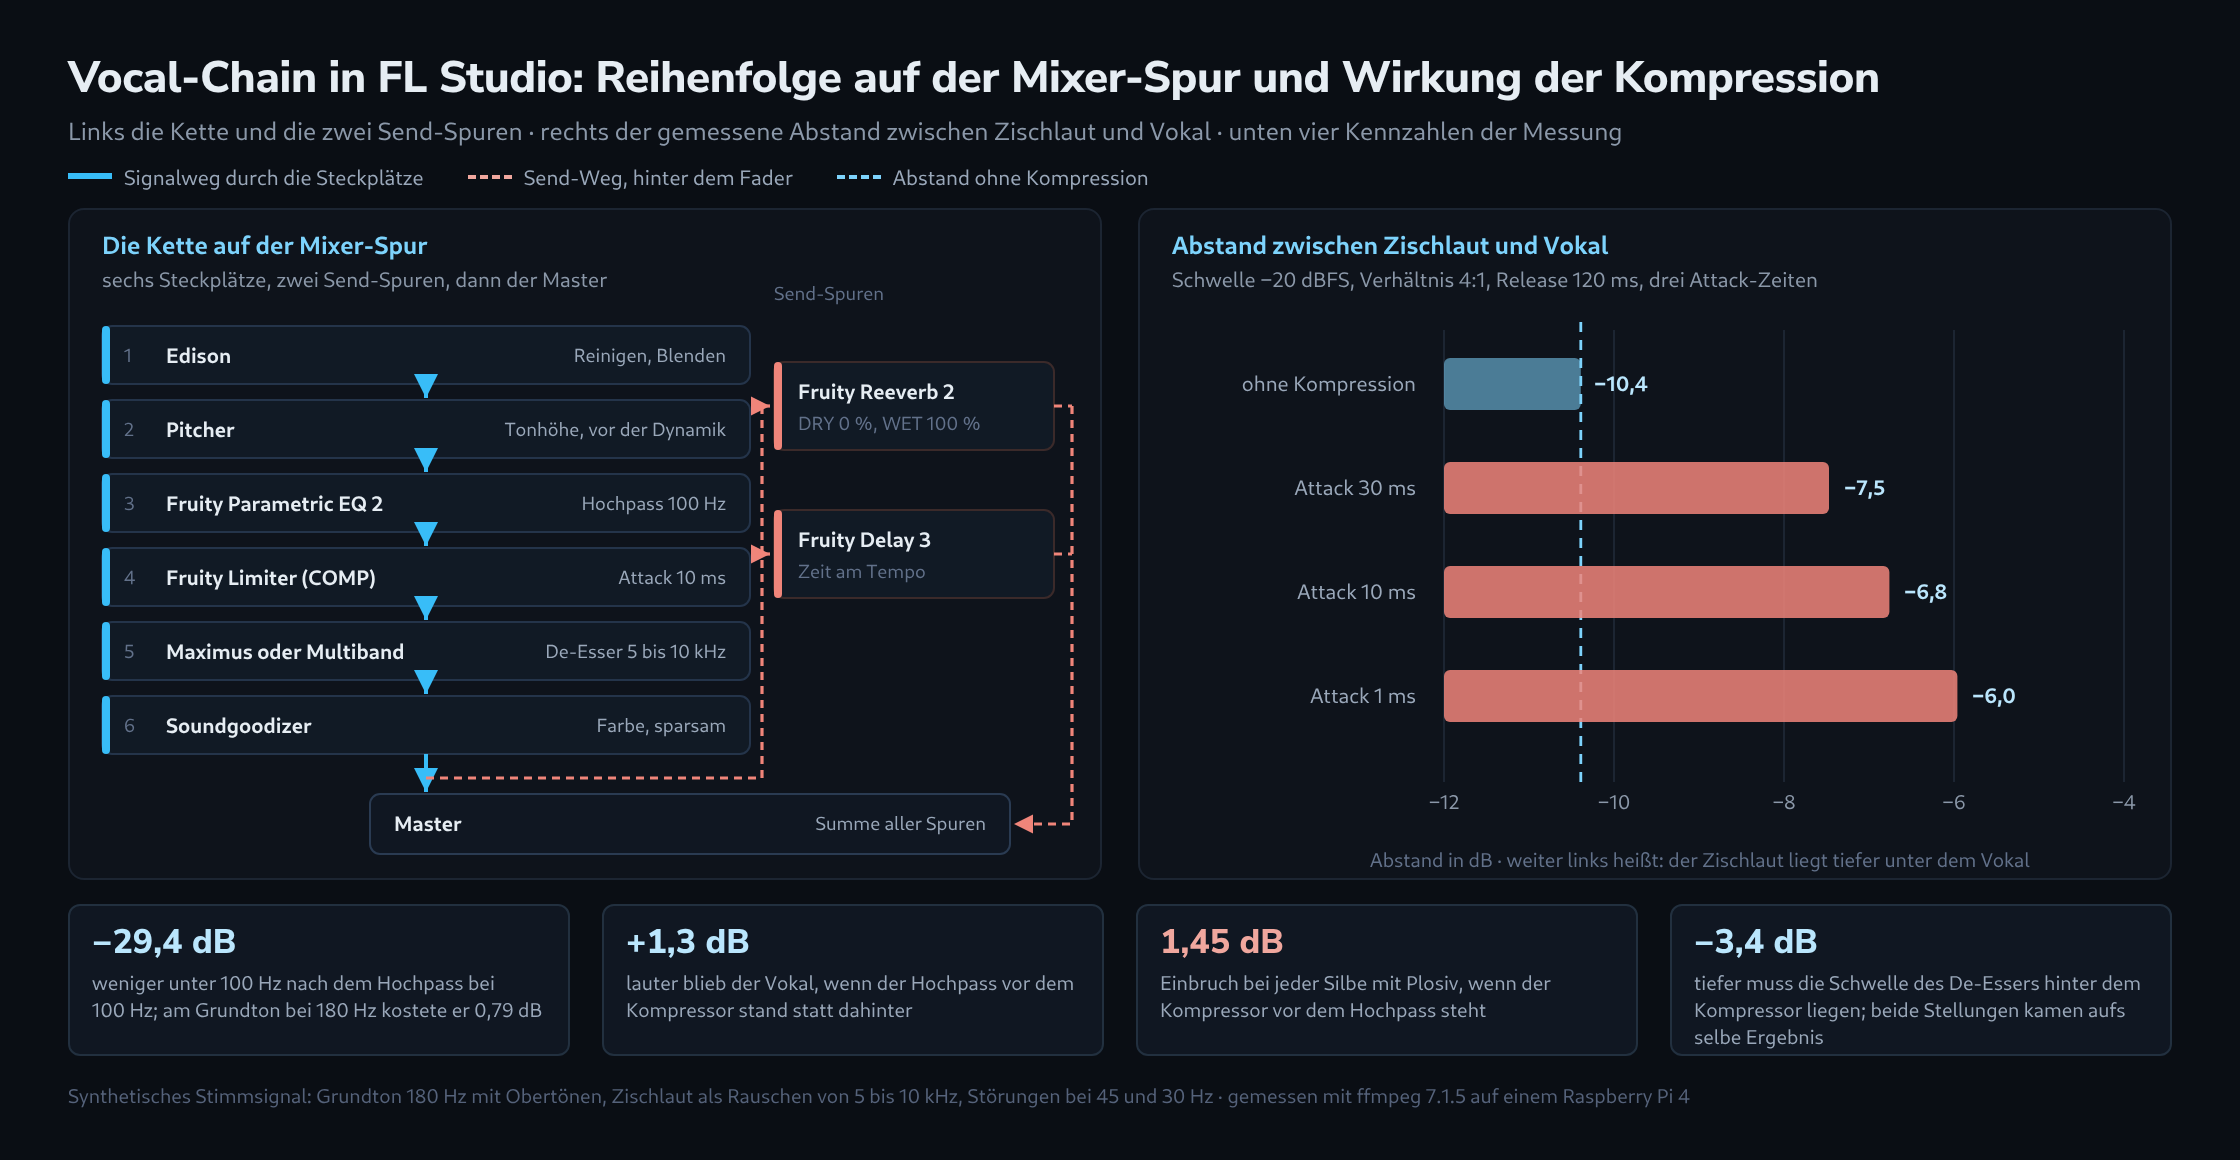
Eine Gesangsspur liegt in FL Studio auf einer eigenen Mixer-Spur. Jede Insert-Spur hat laut Handbuch zehn Effekt-Steckplätze, und was in welcher Reihenfolge darin steckt, entscheidet mit über Lautheit, Gleichmäßigkeit und Schärfe der Stimme. Dieses Tutorial baut eine Kette aus sechs Schritten auf, nennt zu jedem Schritt die Regler aus dem Handbuch und misst nach, was die Reihenfolge ändert.
Gemessen wurde nicht mit den FL-Plugins, sondern mit ffmpeg an einem synthetischen Stimmsignal. So lassen sich vier Fragen beantworten, die sonst Geschmackssache bleiben: Wie hoch darf der Hochpass liegen, was kostet er am Grundton, was bringt er vor dem Kompressor, und wie verschiebt die Kompression das Verhältnis zwischen Zischlaut und Vokal.
So wurde gemessen
- Signal: 24 Sekunden bei 48 kHz. Alle 500 ms eine Silbe aus 300 ms Vokal und 120 ms Zischlaut. Der Vokal besteht aus einem Grundton von 180 Hz mit Obertönen bis 5 kHz und erreicht in der Spitze −12 dBFS, der Zischlaut aus Rauschen zwischen 5 und 10 kHz mit −18 dBFS. Dazu kommen zwei Störungen: ein Dauerton bei 45 Hz mit −20 dBFS und alle 2 Sekunden ein Plosiv bei 30 Hz. Zusammen liegt die Spitze bei −1,86 dBFS.
- Kette: ffmpeg 7.1.5. Hochpass als zwei hintereinandergeschaltete Biquads, zusammen 24 dB pro Oktave. Kompressor mit Schwelle −20 dBFS, Verhältnis 4:1, Knee 6 dB, Release 120 ms, Erkennung über den Effektivwert und ohne Makeup-Gain. De-Esser als dynamischer Entzerrer bei 7 kHz mit Güte 1,4, Verhältnis 4:1 und Attack 1 ms.
- Auswertung: Bandfilter über die Fourier-Transformierte. Als Vokalpegel gilt der Effektivwert zwischen 150 Hz und 4 kHz im Fenster 50 bis 280 ms jeder Silbe, als Zischpegel der Wert zwischen 5 und 10 kHz im Fenster 310 bis 410 ms, jeweils gemittelt über 48 Silben. Die Lautheit stammt aus ffmpeg nach ITU-R BS.1770.
- Übertragbarkeit: Ein Kompressor von ffmpeg ist nicht der Fruity Limiter, und ein synthetisches Signal ist keine gesungene Stimme. Die Zahlen zeigen, in welche Richtung und in welcher Größenordnung die Reihenfolge wirkt, nicht den Klang eines bestimmten Plugins.
Schritt 1: eigene Mixer-Spur, Aufnahmepegel und Reinigung
Das Handbuch nennt für den Mixer 500 Insert-Spuren mit je zehn Effekt-Steckplätzen. Die Gesangsspur bekommt eine davon, damit Kette und Sends unabhängig von anderen Spuren bleiben. Der Aufnahmepegel darf ruhig Luft lassen: Spitzen um −12 bis −6 dBFS reichen für 24 Bit vollkommen aus, und je mehr Abstand zur Vollaussteuerung bleibt, desto weniger Ärger machen Plosive. Wie klein der Puffer beim Einsingen sein darf, rechnet der Latenz- und Puffer-Rechner aus.
Edison lädt laut Handbuch in einen beliebigen Effekt-Steckplatz und nimmt genau an dieser Stelle auf oder gibt von dort wieder. Damit eignet er sich als erster Schritt der Kette: Der Punkt „Clean up (Denoise / Declip / Declick)“ öffnet das Werkzeug zum Reparieren verrauschter, übersteuerter oder knackender Aufnahmen, und die Blenden am Anfang und Ende entfernen mit der rechten Maustaste zusätzlich Knackser. Was hier bereinigt wird, muss später kein Kompressor mehr ausbügeln.
Schritt 2: Tonhöhe vor der Dynamik
Pitcher korrigiert die Tonhöhe auf eine gewählte Tonart und Skala; Töne außerhalb der Skala rücken laut Handbuch auf die nächste Stufe darin. Die Korrekturgeschwindigkeit entscheidet über den Charakter, schnelle Einstellungen klingen künstlicher und langsame natürlicher. Der Formant-Regler hält die Klangfarbe fest, während sich die Tonhöhe ändert. Im MIDI-Modus steuert eine Klaviatur oder die Piano Roll die Zieltöne, die Betriebsart „Harmonize“ legt dabei zusätzliche Stimmen. Pitcher gehört laut Handbuch zum Signature Bundle und aufwärts oder ist einzeln erhältlich.
Die Tonhöhenkorrektur steht vor der Dynamik, weil ein Kompressor die Nebenwirkungen der Korrektur mit anhebt: Je stärker leise Stellen später angehoben werden, desto deutlicher treten Artefakte hervor, die vor der Kompression kaum auffallen. Umgekehrt braucht die Korrektur selbst keinen verdichteten Eingang.
Schritt 3: Hochpass im Fruity Parametric EQ 2
Der Fruity Parametric EQ 2 hat sieben Bänder, die sich unter anderem als Hochpass, Tiefpass, Kuhschwanz oder Glocke betreiben lassen; die Flankensteilheit reicht laut Handbuch von 12 bis 48 dB pro Oktave. Die Standardform eines Bandes ist die Glocke. Der Linear-Phase-Modus arbeitet mit einer schnellen Fourier-Transformation und erhöht dabei die Latenz, während der Standardmodus nahezu sofort rechnet; für eine Kette, die beim Einsingen mitläuft, ist der Standardmodus die passende Wahl.
Das erste Band wird zum Hochpass. Die Messung zeigt, was verschiedene Grenzfrequenzen am Testsignal bewirken, gemessen mit 24 dB pro Oktave:
| Hochpass | Störanteil 10 bis 100 Hz | Grundton 150 bis 250 Hz | Spitzenpegel |
|---|---|---|---|
| ohne | −20,91 dBFS | −23,96 dBFS | −1,86 dBFS |
| 60 Hz | −34,85 dBFS | −24,06 dBFS | −10,87 dBFS |
| 80 Hz | −43,17 dBFS | −24,29 dBFS | −10,47 dBFS |
| 100 Hz | −50,29 dBFS | −24,75 dBFS | −10,70 dBFS |
| 120 Hz | −56,31 dBFS | −25,53 dBFS | −11,32 dBFS |
| 150 Hz | −63,86 dBFS | −27,38 dBFS | −12,78 dBFS |
Bei 100 Hz lag der Störanteil 29,38 dB tiefer als ohne Hochpass, während der Grundton 0,79 dB verlor. Bei 150 Hz waren es 42,95 dB weniger Störanteil, aber schon 3,42 dB weniger Grundton, und bei einer Stimme mit 180 Hz Grundton ist das zu viel. Auffällig ist der Spitzenpegel: Schon ein Hochpass bei 60 Hz nahm der Aufnahme 9 dB Spitze, weil der Plosiv bei 30 Hz die höchsten Ausschläge lieferte. Diese 9 dB sind Platz, den die restliche Kette danach nutzen kann.
Als Ausgangspunkt taugt eine Grenzfrequenz eine halbe Oktave unter dem tiefsten Grundton der Stimme. Für die 180 Hz des Testsignals sind das rund 120 Hz; die Messung setzt 100 Hz an, um Reserve zu behalten. Wer tiefer singt, rückt entsprechend nach unten.
Der Hochpass gehört vor den Kompressor
Ein Kompressor reagiert auf den Gesamtpegel, nicht nur auf die Stimme. Steht er vor dem Hochpass, steuern Brummen und Plosive seine Pegelabsenkung mit. Beide Reihenfolgen mit sonst gleichen Einstellungen ergaben:
| Reihenfolge | Vokalpegel | Lautheit | Spitzenpegel | Einbruch bei Plosiv-Silben |
|---|---|---|---|---|
| Hochpass, dann Kompressor | −23,72 dBFS | −25,8 LUFS | −13,61 dBFS | 0,01 dB |
| Kompressor, dann Hochpass | −25,06 dBFS | −27,1 LUFS | −14,16 dBFS | 1,45 dB |
Mit dem Hochpass vorn blieb die Stimme 1,34 dB lauter und die Lautheit 1,3 LU höher, ohne dass an den Kompressoreinstellungen etwas geändert wurde. Wichtiger als der Pegel ist die letzte Spalte: Stand der Kompressor vorn, war jede Silbe mit Plosiv im Schnitt 1,45 dB leiser als die übrigen Silben. Genau das hört sich als kurzes Wegdrücken der Stimme an. Mit dem Hochpass davor verschwand der Effekt vollständig.
Schritt 4: Kompression im Fruity Limiter, Reiter COMP
Der Fruity Limiter trägt zwei Reiter, LIMIT und COMP; die Kompressorregler liegen im Reiter COMP. THRESH legt fest, ab welchem Pegel die Kompression greift, RATIO, wie stark oberhalb davon abgesenkt wird, und KNEE, ob der Übergang weich oder hart verläuft. ATT bestimmt, wie schnell die Hüllkurve auf den Signalanfang reagiert, und legt zugleich die Vorschau des Limiters fest, was sich in der Latenz des Plugins niederschlägt. REL ist die Rücklaufzeit; zu kurz eingestellt entstehen laut Handbuch Verzerrungen. CURVE reicht von 1 für sofortige bis 8 für träge Reaktion. SUSTAIN von 0 bis 1000 ms bestimmt, über welche Dauer der Eingang als Effektivwert gemittelt wird, und verhindert so ein zu frühes Loslassen. GAIN wirkt als Makeup hinter dem Kompressor und vor der Limiter-Stufe.
Als Startpunkt für eine gesungene Stimme: Verhältnis 3:1 bis 4:1, Schwelle so tief, dass laute Silben 3 bis 6 dB Absenkung zeigen, Attack um 10 ms, Release um 120 ms. Die Attack-Zeit ist dabei kein reiner Geschmacksregler, wie der nächste Abschnitt zeigt. Für Ducking gegen eine andere Spur nimmt derselbe Reiter ein Sidechain-Signal entgegen; der Weg dafür steht im Tutorial zur Sidechain-Kompression in FL Studio.
Schritt 5: De-Esser, und was die Kompression mit Zischlauten macht
Image-Line beschreibt De-Esser nüchtern: Die meisten guten De-Esser seien schlicht bandbegrenzte Kompressoren mit anderem Namen. Als Werkzeuge nennt der Hersteller den Fruity Multiband Compressor und Maximus, als Frequenzbereich der Zischlaute 4000 bis 12.000 Hz. Der Vorteil gegenüber einer festen Absenkung im Entzerrer: Eine Kompression mit passender Schwelle und passendem Verhältnis senkt die Zischlaute nur, wenn sie eine erträgliche Grenze überschreiten, während ein Entzerrer dieselben Frequenzen über die ganze Spur absenkt und sie oft dumpf macht.
Maximus bringt dafür das Preset „De-esser Split Band“ mit. Laut Tutorial sind darin das untere und das obere Band sowie der Master abgeschaltet, das mittlere Band arbeitet mit starker Kompression und hält den Eingang bei rund −6 dB; alles darunter bleibt unverändert. Die untere Grenzfrequenz des mittleren Bandes wird auf die Zischlaute gelegt, PRE GAIN hebt das Signal so weit an, dass die Zischlaute in den Kompressionsbereich fahren, und POST GAIN nimmt denselben Betrag wieder zurück. Der Fruity Multiband Compressor bietet stattdessen drei Bänder mit vier Grenzfrequenzreglern, Schwellen von 0 bis −60 dB, Verhältnisse von 1:1 bis unendlich, Attack von 0,1 bis 100 ms, Release von 10 bis 1000 ms und ein Ausgangsgain bis 17 dB, dazu je Band die Schalter für aktiv, stumm und umgangen.
Interessant ist, was vor dem De-Esser passiert. Die Kompression senkt laute Vokale stärker ab als die leiseren Zischlaute und verschiebt damit das Verhältnis zwischen beiden:
| Bearbeitung | Vokalpegel | Zischpegel | Abstand | Änderung |
|---|---|---|---|---|
| ohne Kompression | −19,29 dBFS | −29,68 dBFS | −10,39 dB | Bezug |
| Attack 30 ms | −22,34 dBFS | −29,81 dBFS | −7,47 dB | +2,92 dB |
| Attack 10 ms | −23,21 dBFS | −29,97 dBFS | −6,76 dB | +3,63 dB |
| Attack 1 ms | −24,50 dBFS | −30,46 dBFS | −5,96 dB | +4,43 dB |
Der Zischlaut selbst verlor durch die Kompression höchstens 0,78 dB, der Vokal dagegen bis zu 5,21 dB. Damit rückte der Zischlaut um 2,92 dB bei träger und um 4,43 dB bei sehr schneller Attack näher an den Vokal heran. Eine schnelle Attack macht die Stimme also nicht nur dichter, sondern auch schärfer, und zwar messbar. Wer eine Stimme erst komprimiert und danach findet, sie zische mehr als vorher, hat keine Einbildung, sondern diesen Effekt vor sich.
Vor oder hinter dem Kompressor: die Schwelle entscheidet, nicht die Stelle
Aus dem vorigen Abschnitt ließe sich folgern, der De-Esser müsse unbedingt hinter den Kompressor. Die Gegenprobe zeigt ein anderes Bild. Dafür wurde in beiden Stellungen die Schwelle des De-Essers so eingestellt, dass am Ende derselbe Abstand zwischen Zischlaut und Vokal steht wie im unbearbeiteten Signal, also −10,39 dB:
| Stellung | nötige Schwelle | Zischpegel am Ende | Vokalpegel am Ende |
|---|---|---|---|
| De-Esser vor dem Kompressor | −41,8 dB | −34,16 dBFS | −23,77 dBFS |
| De-Esser hinter dem Kompressor | −45,2 dB | −34,24 dBFS | −23,85 dBFS |
Beide Ketten landeten auf 0,09 dB genau beim selben Zischpegel und auf 0,08 dB genau beim selben Vokalpegel. Der Unterschied steckt in der zweiten Spalte: Hinter dem Kompressor muss die Schwelle 3,4 dB tiefer liegen, weil der Kompressor das Signal vorher absenkt. Wird der De-Esser also verschoben, ohne die Schwelle nachzuziehen, greift derselbe Regler plötzlich ganz anders. Bei unveränderter Schwelle und kurzem Release von 5 ms senkten beide Stellungen die Zischlaute um 15,19 beziehungsweise 15,32 dB, blieben also gleichauf; ein Release von 200 ms dagegen zog den Vokal um 5,34 beziehungsweise 3,21 dB mit nach unten, weil die Absenkung bis in die nächste Silbe nachwirkte.
Praktisch folgt daraus: Der De-Esser steht hinter dem Kompressor, weil er dort das Verhältnis bearbeitet, das am Ende auch zu hören ist. Sein Release bleibt kurz, in der Größenordnung von 5 bis 40 ms. Und die Schwelle wird immer an der Stelle eingestellt, an der der De-Esser tatsächlich sitzt, nie aus einer anderen Kette übernommen.
Schritt 6: Sättigung sparsam
Der Soundgoodizer ist laut Handbuch ein Maximizer und Enhancer auf Basis der Maximus-Engine. Sein großer Regler entspricht dem LMH-Mix von Maximus und blendet zwischen dem Eingang und den Ausgängen der drei Kompressorbänder über; die vier Presets A bis D sind fertige Maximus-Einstellungen. Weil das Plugin also nicht nur färbt, sondern zusätzlich verdichtet, gehört es ans Ende der Kette und in kleine Dosen. Für genauere Kontrolle stehen dieselben Einstellungen direkt in Maximus offen.
Ein Punkt, den die Messung nicht abdeckt: Sättigung erzeugt neue Obertöne, die im Bereich der Zischlaute liegen können. Die letzte Kontrolle nach dem Einstellen der Sättigung gilt deshalb erneut den S-Lauten.
Hall und Delay auf Send-Spuren
Hall und Delay gehören nicht in die Kette der Stimmspur, sondern auf eigene Spuren. Laut Handbuch lassen sich Insert-Spuren an beliebig viele andere Spuren senden: erst die Quellspur wählen, dann auf der Zielspur den Send-Schalter setzen; der Schalter wird dabei durch einen Regler für die gesendete Menge ersetzt. Sends arbeiten hinter dem Fader, für einen Abgriff vor dem Fader ist das Plugin Fruity Send zuständig.
Auf der Hall-Spur steht Fruity Reeverb 2. Das Handbuch nennt für den Betrieb auf einer Send-Spur ausdrücklich DRY auf 0 % und WET auf 100 %. DELAY setzt die Zeit zwischen dem direkten Signal und der ersten Reflexion, DEC die Zeit bis zum Abfall auf −60 dB, DIFF die Dichte der Reflexionen, DAMP die Dämpfung der Höhen im Hallanteil, L.CUT und H.CUT schneiden Bereiche aus dem Hall heraus, SEP regelt die Stereobreite des Hallanteils.
Auf der Delay-Spur steht Fruity Delay 3. Die Verzögerung reicht von 1 bis 1000 ms, mit Tempobindung von einem Achtundvierzigstel eines Schritts bis zu 16 Schritten, also einem Takt; die Echos folgen dann auch einer Tempoautomation. Vier Modelle stehen zur Wahl: Mono, Stereo, Ping Pong und aus. Für die passende Zeit in Millisekunden rechnet der BPM- und Delay-Rechner die Notenwerte um.
Die fertige Kette in Slot-Reihenfolge
| Steckplatz | Plugin | Aufgabe | Startwert |
|---|---|---|---|
| 1 | Edison | Reinigen, Blenden, Rauschen | Clean up nur bei Bedarf |
| 2 | Pitcher | Tonhöhe | Tonart setzen, Korrektur langsam |
| 3 | Fruity Parametric EQ 2 | Hochpass und Senken | Hochpass 100 Hz, 24 dB pro Oktave |
| 4 | Fruity Limiter, Reiter COMP | Kompression | 4:1, Attack 10 ms, Release 120 ms |
| 5 | Maximus oder Fruity Multiband Compressor | De-Esser | Band 5 bis 10 kHz, Release unter 40 ms |
| 6 | Soundgoodizer | Sättigung | Preset A, Regler weit links |
| Send 1 | Fruity Reeverb 2 | Raum | DRY 0 %, WET 100 % |
| Send 2 | Fruity Delay 3 | Echo | Tempobindung, Ping Pong |
Nach der Kette: Bus und Lautheit
Mehrere Gesangsspuren laufen sinnvoll auf einer gemeinsamen Spur zusammen, auf der ein weiterer, sehr milder Kompressor sitzt. Ab da gelten die Regeln des Masterings: Der LUFS- und True-Peak-Messer zeigt, wo die Lautheit steht, das Werkzeug für Stereo-Korrelation und Mid/Side prüft, ob die Stimme wirklich in der Mitte steht, und das Tutorial zum Mastering auf Streaming-Lautheit beschreibt den Weg bis zur fertigen Datei.
Einordnung und Grenzen
- Gemessen wurde mit ffmpeg, nicht mit den FL-Plugins. Regler gleichen Namens verhalten sich dort anders, und Maximus arbeitet mit einer frei geformten Kennlinie, die kein einfacher Kompressor nachbildet.
- Das Testsignal ist synthetisch: gleichmäßige Silben, kein Raum, keine Atmer, kein Vibrato. Eine echte Aufnahme schwankt stärker, wodurch die Effekte der Reihenfolge größer ausfallen können.
- Die Zahlen zum Hochpass hängen am Grundton von 180 Hz. Für tiefere Stimmen verschieben sich die Werte entsprechend nach unten.
- Eine Auffälligkeit blieb unerklärt: Bei unveränderter Schwelle und einem Release von 40 ms senkte derselbe De-Esser vor dem Kompressor 19,40 dB und dahinter 5,15 dB, während er bei 5 ms in beiden Stellungen gleich stark arbeitete. Der Wert ist notiert, aber nicht weiter aufgeklärt; er stützt die Empfehlung, die Schwelle immer in der endgültigen Kette einzustellen.
- Die Angaben zu den Plugins stammen aus dem Handbuch von Image-Line und wurden nicht nachgemessen.
Fragen und Antworten
Warum drückt der Plosiv die ganze Silbe, obwohl der Hochpass ihn danach entfernt?
Weil der Kompressor auf den Pegel reagiert, den er sieht, und der Plosiv dort die größten Ausschläge liefert. Er treibt die Pegelabsenkung hoch, und die löst sich mit einem Release von 120 ms nur allmählich; in dieses Zeitfenster fällt der Vokal derselben Silbe. Der nachgeschaltete Hochpass entfernt zwar den Plosiv, die Absenkung des Vokals bleibt aber im Signal, im Mittel 1,45 dB.
Hebt ein Kompressor auf dem Gesangsbus die Zischlaute wieder an?
Er wirkt in dieselbe Richtung wie der Kompressor der Einzelspur, bei milder Einstellung nur schwächer. Die Messung zeigt den Mechanismus: Die Kompression senkte den Vokal um 3,05 bis 5,21 dB, den leiseren Zischlaut dagegen nur um 0,13 bis 0,78 dB. Der Abstand zwischen beiden schrumpfte damit um den größten Teil des Betrags, um den der Vokal abgesenkt wurde. Nach derselben Logik, wenn auch nicht gemessen, rückt ein Buskompressor, der laute Silben um 1 bis 2 dB absenkt, die Zischlaute um einen ähnlichen Betrag an den Vokal heran, und zwar hinter dem De-Esser, der sie zuvor abgesenkt hat.
Daraus folgt zweierlei. Erstens gilt die Regel des Artikels, die Schwelle dort einzustellen, wo der De-Esser tatsächlich sitzt, auch für den Bus: Die letzte Kontrolle der S-Laute erfolgt bei eingeschaltetem Buskompressor, nicht auf der Einzelspur. Zweitens kann bei mehreren Stimmen ein zusätzlicher De-Esser auf dem Bus die bessere Wahl sein, als jede Einzelspur schärfer einzustellen, weil sich dort die Zischlaute gleichzeitig singender Stimmen addieren.
Welche Schritte der Kette verzögern das Signal beim Einsingen?
Laut Artikel zwei der genannten Einstellungen: der Linear-Phase-Modus des Fruity Parametric EQ 2, der mit einer schnellen Fourier-Transformation rechnet, und die Attack-Zeit des Fruity Limiter, die zugleich seine Vorschau festlegt. Beides kommt zur Pufferlatenz des Audio-Interfaces hinzu.
Eine Verzögerungskompensation kann die Wiedergabe der übrigen Spuren an solche Plugins angleichen, beim Mithören während der Aufnahme lässt sich die Verzögerung aber nicht zurückholen: Die Stimme kommt später im Kopfhörer an. Für das Einsingen genügt deshalb eine schlanke Kette mit dem EQ im Standardmodus; die übrigen Einstellungen lassen sich nach der Aufnahme wieder zuschalten.
Quellen
- Image-Line: FL Studio Manual, Mixer: 500 Insert-Spuren, zehn Effekt-Steckplätze, Send-Schalter und Send-Regler, Sends hinter dem Fader, Fruity Send für den Abgriff davor.
- Image-Line: Fruity Parametric EQ 2: sieben Bänder, Filtertypen, Steilheit von 12 bis 48 dB pro Oktave, Linear-Phase-Modus mit erhöhter Latenz.
- Image-Line: Fruity Limiter: Reiter LIMIT und COMP, THRESH, RATIO, KNEE, ATT mit Vorschau, REL, CURVE 1 bis 8, SUSTAIN 0 bis 1000 ms, GAIN als Makeup.
- Image-Line: De-Essing Options in FL Studio: De-Esser als bandbegrenzte Kompressoren, Zischlaute zwischen 4000 und 12.000 Hz, Kompression gegen feste Absenkung.
- Image-Line: Maximus Tutorials: Preset „De-esser Split Band“, nur das mittlere Band aktiv, PRE GAIN und POST GAIN gegenläufig.
- Image-Line: Fruity Multiband Compressor: drei Bänder, vier Grenzfrequenzregler, Schwelle 0 bis −60 dB, Attack 0,1 bis 100 ms, Release 10 bis 1000 ms.
- Image-Line: Fruity Reeverb 2: DELAY, DEC bis −60 dB, DIFF, DAMP, L.CUT, H.CUT, SEP, DRY 0 % und WET 100 % auf der Send-Spur.
- Image-Line: Fruity Delay 3: 1 bis 1000 ms, Tempobindung von einem Achtundvierzigstel Schritt bis 16 Schritte, Modelle Mono, Stereo und Ping Pong.
- Image-Line: Pitcher: Tonart und Skala, Korrekturgeschwindigkeit, Formant, MIDI-Modus mit Harmonize, Signature Bundle und aufwärts.
- Image-Line: Soundgoodizer: Maximizer und Enhancer auf Basis der Maximus-Engine, Regler als LMH-Mix, Presets A bis D.
- Image-Line: Edison: lädt in einen Effekt-Steckplatz und nimmt an dieser Stelle auf; Clean up für Rauschen, Übersteuerung und Knackser, Blenden mit Entknacken.
Passend dazu