English
 Deutsch
 Polski
Tutorial: GA4-Daten nach BigQuery exportieren und die erste SQL-Abfrage schreiben

Inhalt
Die GA4-Oberfläche beantwortet die Fragen, für die sie gebaut wurde. Alles außerhalb dieser Form – eine Seitenabfolge je Sitzung, eine Kohorte aus zwei Bedingungen in bestimmter Reihenfolge, eine Kennzahl, die die Oberfläche nicht anbietet – stößt an die Grenzen einer Reporting-Oberfläche, die auf voraggregierten Daten aufsetzt. Der BigQuery-Export hebt diese Decke auf, indem er den rohen Event-Strom bereitstellt: eine Zeile je Event, in SQL abfragbar.
Die folgende Anleitung deckt die drei Schritte zum Einstieg ab: den Export einschalten, verstehen, was die Rohdaten im Vergleich zur Oberfläche enthalten und was nicht, und eine erste Abfrage schreiben, die Nutzerpfade aus dem verschachtelten Event-Schema rekonstruiert.
Schritt 1: Den Export einschalten
Die Verknüpfung entsteht in GA4 unter Verwaltung im Bereich Produktverknüpfungen über BigQuery-Verknüpfungen. Dafür sind Bearbeitungsrechte an der GA4-Property und Inhaberrechte am Ziel-Projekt in der Google Cloud nötig, mit aktivierter BigQuery-API. Die Konfiguration fragt nach dem Cloud-Projekt, einem Speicherort, den einzubeziehenden Datenstreams und einer Exporthäufigkeit.
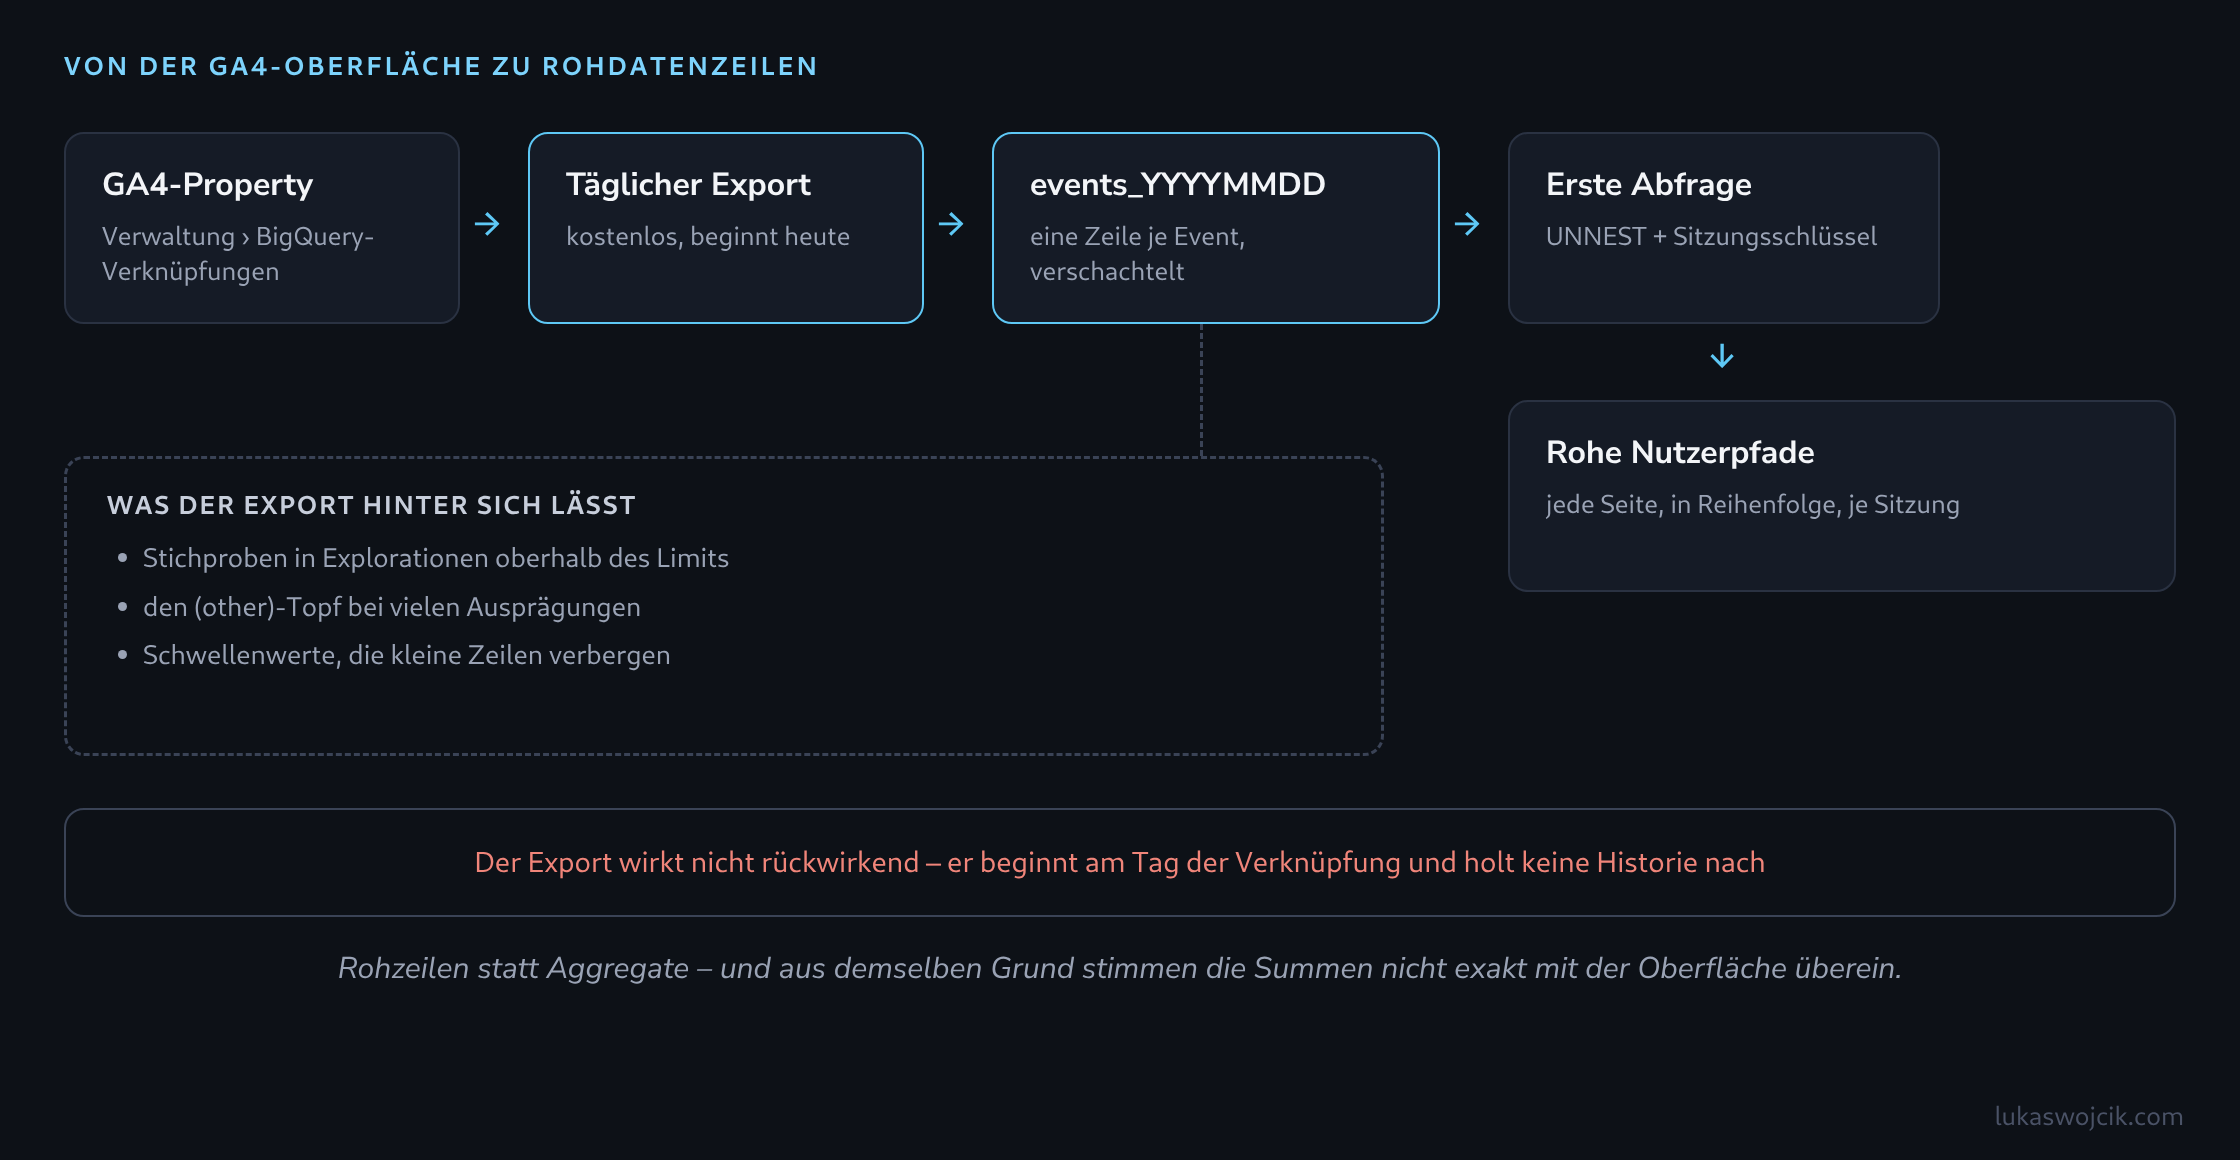
Zwei Häufigkeiten stehen zur Wahl, und sie verhalten sich unterschiedlich. Täglich schreibt eine Tabelle pro Tag, events_YYYYMMDD, üblicherweise am Folgetag verfügbar; für Standard-Properties ist das kostenfrei enthalten. Streaming schreibt fortlaufend nach events_intraday_YYYYMMDD und wird zu den Streaming-Insert-Preisen von BigQuery abgerechnet. Um die Daten kennenzulernen und für die meisten Auswertungen genügt der tägliche Export allein.
Zwei Einschränkungen sind wichtig, bevor darauf gebaut wird. Der Export wirkt nicht rückwirkend – er beginnt am Tag der Verknüpfung, es wird keine Historie nachgeholt, weshalb sich ein frühes Einschalten auch ohne unmittelbaren Verwendungszweck lohnt. Und Standard-Properties unterliegen einem dokumentierten täglichen Exportlimit von einer Million Events pro Tag; wird es überschritten, kann der Export ausgesetzt werden – das aktuelle Volumen ist also gegen das Limit in Googles Dokumentation zu prüfen, bevor der Export tragende Funktion bekommt.
Auf BigQuery-Seite umfasst die kostenlose Stufe 10 GiB Speicher und 1 TiB verarbeitete Abfragedaten pro Monat, was für eine einzelne, manuell erkundete Property großzügig bemessen ist.
Schritt 2: Was „ohne Stichproben“ tatsächlich bedeutet
Stichproben im Export zu vermeiden ist keine Technik – es ergibt sich daraus, dass der Export der unaggregierte Event-Strom ist und kein Bericht. Drei getrennte Reduktionen der Oberfläche fehlen dort schlicht:
- Stichproben in Explorationen. Standardberichte in GA4 arbeiten ohne Stichproben, Explorationen dagegen greifen darauf zurück, sobald eine Abfrage das Event-Limit der jeweiligen Property-Stufe überschreitet – das Ergebnis trägt dann einen entsprechenden Hinweis.
- Die
(other)-Zeile. Erzeugt eine Dimension mehr verschiedene Werte, als ein Bericht fassen kann, wird der Rest in einen einzigen(other)-Topf zusammengezogen – ein echtes Problem bei Seitenpfaden, Produkt-IDs oder Suchbegriffen. - Schwellenwerte. Bei aktiven Google-Signalen werden Zeilen, die nur sehr wenige Nutzer repräsentieren, vollständig zurückgehalten, damit sich niemand identifizieren lässt; statt der Daten erscheint ein Hinweis auf die Schwellenwertbildung.
Keine dieser drei Reduktionen betrifft die exportierten Tabellen. Der Gegenwert: Alles, was die Oberfläche auf den Rohdaten aufbaut – modellierte Conversions, datengetriebene Attribution, ihre eigene Sitzungsdefinition –, fehlt ebenfalls. Genau deshalb stimmen Summen aus BigQuery und Summen aus der Oberfläche nicht exakt überein.
Schritt 3: Die Form der Daten
Jede Zeile ist ein Event. Wer aus einer klassischen SQL-Welt kommt, stolpert vor allem darüber, dass die interessanten Werte keine Spalten sind: Sie stecken in event_params, einem wiederholten Record aus Schlüssel-Wert-Paaren, in dem der Wert selbst ein Struct mit je einem Feld pro Datentyp ist.
| Feld | Typ | Inhalt |
|---|---|---|
event_date |
STRING | Der Tag als YYYYMMDD, passend zum Tabellensuffix. |
event_timestamp |
INT64 | Mikrosekunden seit Epoch – der Sortierschlüssel innerhalb einer Sitzung. |
event_name |
STRING | page_view, session_start, purchase sowie eigene Events. |
user_pseudo_id |
STRING | Die Client-Kennung – ein Gerät oder Browser, keine Person. |
event_params |
REPEATED RECORD | Schlüssel-Wert-Paare: ga_session_id, page_location, page_title und weitere. |
items |
REPEATED RECORD | Am Event hängende E-Commerce-Produkte. |
Eine Sitzung hat keine eigene Spalte. Sie wird rekonstruiert, indem user_pseudo_id mit dem Parameter ga_session_id kombiniert wird – Sitzungs-IDs sind nur innerhalb eines Clients eindeutig.
Schritt 4: Eine erste Abfrage zur Bestätigung, dass der Export läuft
Vor allem Analytischen belegt eine Abfrage, dass Daten ankommen und die Tabellenreferenz stimmt:
SELECT
  event_date,
  COUNT(*) AS events,
  COUNT(DISTINCT user_pseudo_id) AS users
FROM `project.analytics_XXXXXXXXX.events_*`
WHERE _TABLE_SUFFIX BETWEEN '20260920' AND '20260926'
GROUP BY event_date
ORDER BY event_date;
Der _TABLE_SUFFIX-Filter ist keine optionale Ordnungsfrage. Der Platzhalter events_* adressiert sämtliche Tagestabellen des Datasets auf einmal, und ohne Suffix-Filter durchsucht die Abfrage die gesamte Exporthistorie – abgerechnet nach gelesenen Bytes.
Schritt 5: Rohe Nutzerpfade auslesen
Die Abfrage, die die Oberfläche nicht liefern kann, ist eine vollständige Seitenabfolge je Sitzung. Ein Wert aus event_params wird über eine skalare Unterabfrage auf UNNEST gelesen – das ist die Redewendung, die sich zu merken lohnt, denn sie kehrt in jeder GA4-Abfrage wieder:
WITH page_views AS (
  SELECT
    user_pseudo_id,
    (SELECT value.int_value FROM UNNEST(event_params)
      WHERE key = 'ga_session_id') AS session_id,
    event_timestamp,
    (SELECT value.string_value FROM UNNEST(event_params)
      WHERE key = 'page_location') AS page_location
  FROM `project.analytics_XXXXXXXXX.events_*`
  WHERE _TABLE_SUFFIX BETWEEN '20260920' AND '20260926'
    AND event_name = 'page_view'
)
SELECT
  CONCAT(user_pseudo_id, '-', CAST(session_id AS STRING)) AS session_key,
  COUNT(*) AS page_views,
  STRING_AGG(
    REGEXP_EXTRACT(page_location, r'^https?://[^/]+([^?#]*)'),
    ' > ' ORDER BY event_timestamp
  ) AS path
FROM page_views
WHERE session_id IS NOT NULL
GROUP BY session_key
HAVING page_views > 1
ORDER BY page_views DESC
LIMIT 100;
Jede Zeile ist der Weg einer Sitzung in ihrer Reihenfolge, mit entfernter Domain und Query-Zeichenfolge, damit identische Seiten zusammenfallen. Von hier aus beantwortet dieselbe Struktur präzisere Fragen: eine Einschränkung auf Sitzungen mit einem bestimmten Event, das Zählen, wie oft eine Seite einer anderen vorausgeht, oder das Messen, wie viele Schritte einem Kauf vorangehen.
Innerhalb der Leitplanken bleiben
Zwei Erwartungen sind zu klären, bevor diese Daten in einen Bericht wandern. Zahlen aus dem Export lassen sich nicht exakt mit der GA4-Oberfläche in Deckung bringen, und das ist Absicht und kein Fehler, dem nachzujagen wäre: Die Oberfläche legt Modellierung und eine eigene Sitzungslogik über die Rohdaten, die dort nicht enthalten sind. Und der Export enthält Daten auf Event-Ebene zu identifizierbaren Geräten – dieselbe Einwilligungsgrundlage und Aufbewahrungsdisziplin wie für Analytics-Daten gilt daher auch für das Dataset in der Cloud, einschließlich der Frage, wer Zugriff auf das Projekt erhält.
Fragen und Antworten
Zählt events_* bei eingeschaltetem Streaming-Export Events doppelt?
Mit dem Suffix-Filter aus Schritt 4 nicht, ohne ihn unter Umständen schon. Der Platzhalter events_* trifft auch die Tabellen events_intraday_YYYYMMDD, denn deren Name beginnt ebenfalls mit events_. Für sie lautet _TABLE_SUFFIX dann nicht 20260926, sondern intraday_20260926.
Die Bedingung _TABLE_SUFFIX BETWEEN '20260920' AND '20260926' schließt diese Tabellen aus, weil der Vergleich zeichenweise erfolgt und der Buchstabe i hinter allen Ziffern einsortiert wird. Wer die Daten des laufenden Tages aus der Intraday-Tabelle braucht, muss sie deshalb ausdrücklich einbeziehen, zum Beispiel mit einer zusätzlichen Bedingung _TABLE_SUFFIX = 'intraday_20260927'.
Doppelt zählen kann eine Abfrage erst, wenn sie ohne Suffix-Filter oder mit einem zu weiten Muster beide Tabellenarten erfasst und für denselben Tag beide vorliegen. Eine Abfrage, die beide Quellen mischt, sollte deshalb je Tag nur eine davon zählen.
Senkt LIMIT 100 die Kosten einer Abfrage?
Nein. BigQuery rechnet nach den Bytes ab, die eine Abfrage lesen muss, und LIMIT begrenzt nur die Ausgabe, nachdem die Daten gelesen sind. Weil BigQuery spaltenweise speichert, sparen dagegen zwei andere Maßnahmen: die Auswahl nur der benötigten Spalten statt SELECT * und der Filter auf _TABLE_SUFFIX, der ganze Tagestabellen aus der Rechnung nimmt.
Gilt die in GA4 eingestellte Aufbewahrungsdauer auch für die Tabellen in BigQuery?
Nein. Die Aufbewahrungsdauer in den GA4-Einstellungen betrifft die Daten in GA4 selbst. Was einmal nach BigQuery exportiert wurde, liegt dort als eigene Kopie im Cloud-Projekt und bleibt, bis es dort gelöscht wird. Ohne weiteres Zutun wächst das Dataset also Tag für Tag, und mit ihm der Speicher, der die kostenlosen 10 GiB irgendwann übersteigen kann.
Die Aufbewahrungsdisziplin, die der Artikel auch für das Dataset verlangt, ist deshalb in BigQuery einzurichten. Dafür lässt sich am Dataset eine Standard-Ablaufzeit für Tabellen setzen (in der API das Feld defaultTableExpirationMs); neue Tagestabellen werden dann nach dieser Frist automatisch gelöscht. Sie wirkt nur auf Tabellen, die nach der Änderung entstehen; ältere Tabellen brauchen eine eigene Ablaufzeit oder werden von Hand entfernt.
Funktioniert der Export auch ohne Rechnungskonto in der Google Cloud?
Ja, BigQuery läuft dann als Sandbox, allerdings mit zwei Einschränkungen, die für GA4 ins Gewicht fallen. Tabellen in der Sandbox laufen nach 60 Tagen ab, der tägliche Export hält also nie mehr als rund zwei Monate vor. Und der Streaming-Export steht dort nicht zur Verfügung. Für das Kennenlernen der Daten reicht das; wer eine lange Zeitreihe aufbauen will, braucht ein Rechnungskonto, auch wenn die Nutzung innerhalb der kostenlosen Stufe bleibt.
Passend dazu