English
 Deutsch
 Polski
Tutorial: Was in page_location ankommt und warum das Fragment nie beim Server landet

Inhalt
Eine Adresse in der Browserzeile sieht aus wie eine einzige Zeichenkette. Auf ihrem Weg in einen Bericht durchläuft sie vier Systeme, und jedes davon behält einen anderen Teil.
Das meiste daran ist erwartbar. Ein Teil nicht: Alles hinter der Raute erreicht den Webserver überhaupt nie und erreicht die Analyse-Property vollständig – das Gegenteil dessen, was die meisten annehmen, und es entscheidet, wo die Routen einer Einzelseitenanwendung landen.
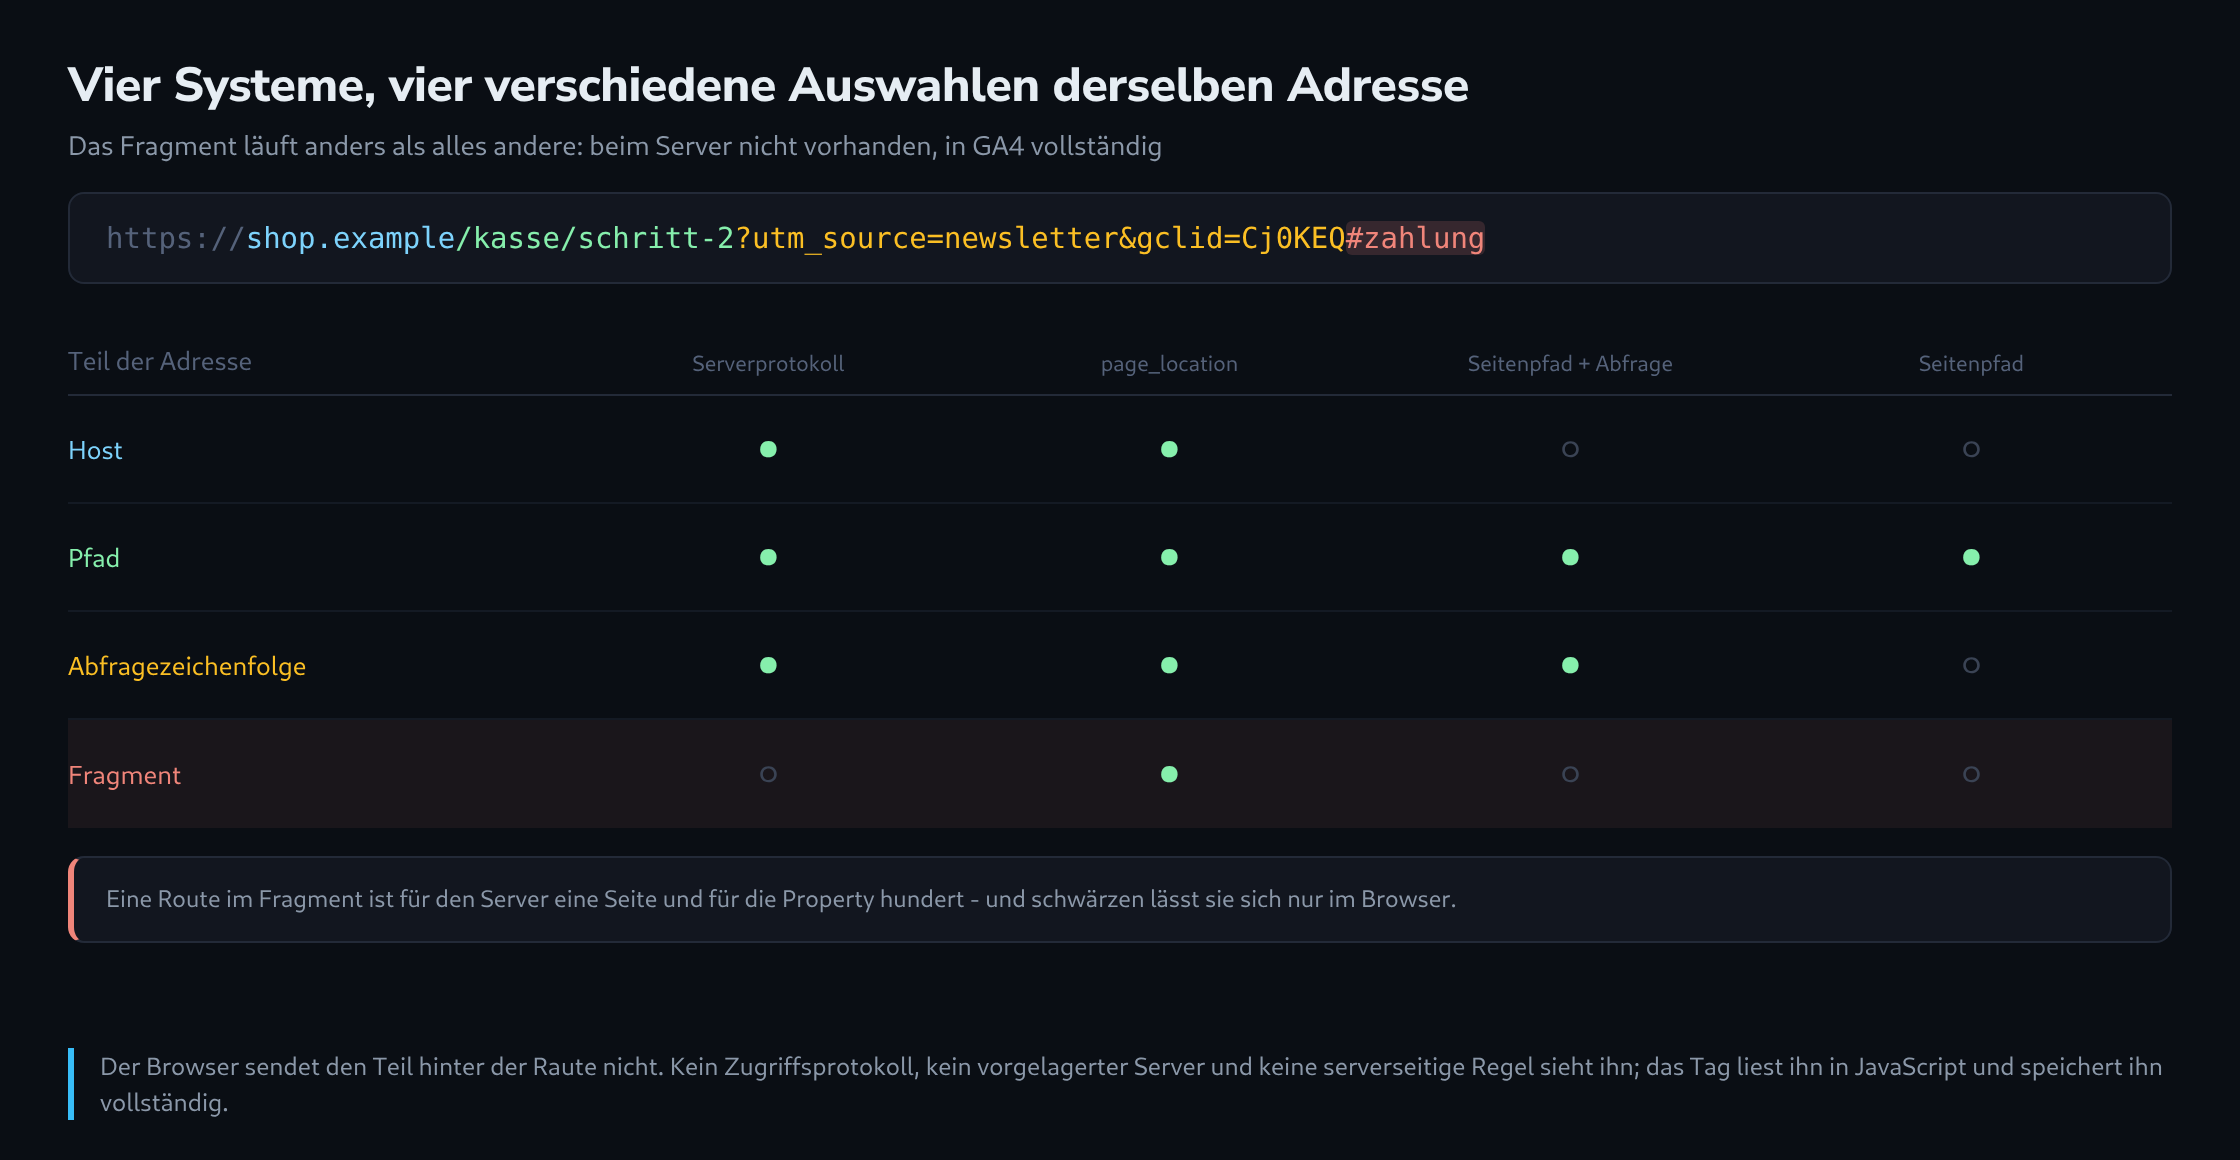
Die Teile einer Adresse und wer welchen sieht
Eine Adresse setzt sich aus fünf Stücken zusammen, und die Trennzeichen dazwischen sind das, wonach ein Parser sucht.
https://shop.example/kasse/schritt-2?utm_source=newsletter&gclid=Cj0KEQ#zahlung
└─┬─┘   └────┬─────┘└──────┬───────┘└─────────────┬──────────────────┘└───┬──┘
Schema     Host          Pfad                  Abfrage                Fragment
Der Webserver bekommt den Host in einem Header und Pfad und Abfrage in der Anfragezeile. Das Fragment bekommt er nie, denn der Browser sendet es nicht – dieser Teil ist als clientseitig festgelegt und bleibt dort. Kein Zugriffsprotokoll, kein vorgelagerter Server und keine serverseitige Regel sieht ihn.
Das Analyse-Tag läuft im Browser, liest document.location.href, und diese Zeichenkette enthält alles einschließlich des Fragments. Der Wert in page_location ist damit vollständiger als alles, was der Server hat.
Das Fragment und wo es landet
Am meisten zählt das für Anwendungen, die ihre Wegführung in das Fragment legen. Ein Pfad der Form /#/produkt/42 ist für den Server eine einzige Seite – er sieht immer nur / -, während die Analyse-Property für jede Route ein eigenes page_location erhält.
Daraus folgen drei Dinge, und sie ziehen in verschiedene Richtungen.
Eine serverseitige Messung einer solchen Anwendung ist ohne Hilfe unmöglich: Eine Protokollauswertung sieht eine Seite und hunderttausend Aufrufe. Das ist das Argument für clientseitige Messung, das nichts anderes ersetzt.
Ein serverseitiges Schwärzen einer solchen Anwendung ist ebenso unmöglich. Ein Fragment mit einer Bestellnummer oder einer Mailadresse lässt sich von keinem vorgelagerten Server entfernen, denn dieser bekommt es nie – die einzige Stelle zum Entfernen ist der Browser, bevor das Tag liest.
Und die Berichtsdimensionen behandeln es uneinheitlich, was der praktische Teil ist.
Was jede Dimension tatsächlich enthält
GA4 speichert einen Parameter und leitet daraus mehrere Dimensionen ab – und jede Ableitung lässt etwas weg.
| Dimension | Inhalt für das Beispiel oben |
|---|---|
| Seitenadresse | https://shop.example/kasse/schritt-2?utm_source=…&gclid=…#zahlung |
| Hostname | shop.example |
| Seitenpfad und Abfragezeichenfolge | /kasse/schritt-2?utm_source=newsletter&gclid=Cj0KEQ |
| Seitenpfad | /kasse/schritt-2 |
Das Fragment erscheint nur in der ersten Zeile. Das heißt: Ein nach Seitenpfad gruppierter Bericht zeigt für eine rautengeführte Anwendung eine Zeile, und derselbe Bericht nach Seitenadresse gruppiert zeigt hundert – und beides sind dieselben Daten.
Die Abfragezeichenfolge ist das Zweite, worauf zu achten ist. Sie steht in zwei der vier Dimensionen, und jeder Parameter darin wird Teil des Werts: Eine Seite, die mit einem gclid erreicht wurde, und dieselbe Seite ohne sind zwei verschiedene Zeilen. Auf einem Auftritt mit Kampagnenverkehr zerlegt das allein eine einzelne Seite in Dutzende.
Die Längenbegrenzung
Die meisten Ereignisparameter in GA4 nehmen hundert Zeichen an. Die Seitenadresse ist ein Sonderfall und nimmt tausend – großzügig und nicht unbegrenzt.
Eine längere Adresse wird gekürzt, und die Kürzung ist still. Wehtun tut sie genau dort, wo Adressen lang werden: eine gefilterte Kategorieseite mit acht Merkmalen, ein Suchergebnis mit der Anfrage in der Adresse und eine rautengeführte Anwendung, deren Route einen Zustand trägt.
// vor dem Tag pruefen, wie lang die Adresse tatsaechlich ist
console.log(document.location.href.length,
            document.location.href.slice(0, 120));
Wo die Grenze ein echtes Risiko ist, lautet die Antwort: absichtlich kürzen, statt die Plattform schneiden zu lassen. Ein page_location-Ersatz, der den Pfad und nur die wichtigen Parameter behält, ist zugleich kürzer und nützlicher, denn er entfernt auch die Kampagnenparameter, die die Seite in Dutzende Zeilen zerlegt haben.
function () {
  var behalten = ["seite", "sortierung", "filter"];
  var u = new URL(document.location.href);
  var neu = new URL(u.origin + u.pathname);

  behalten.forEach(function (name) {
    if (u.searchParams.has(name)) {
      neu.searchParams.set(name, u.searchParams.get(name));
    }
  });
  return neu.href;          // ohne Fragment, ohne Kampagnenparameter
}
Eine Warnung zu dieser Variablen: Nötig ist sie am Seitenaufruf-Tag und an jedem Ereignis-Tag, sonst führt die Property zwei verschiedene Vorstellungen derselben Seite. Und die Kampagnenparameter müssen gelesen werden, bevor sie entfernt werden – das Konfigurationstag braucht die ursprüngliche Adresse, sonst verschwindet die Zuordnung mit ihnen.
Einzelseitenanwendungen: im richtigen Augenblick lesen
Ein Seitenaufbau liest die Adresse einmal. Ein Wegwechsel in einer Anwendung lädt nichts neu, also liest sie niemand erneut, solange es niemandem gesagt wird.
Daraus entsteht die häufigste falsche Zahl in diesem ganzen Bereich: Die zweite Route einer Sitzung meldet die Adresse der ersten, weil das Tag ausgelöst hat, bevor das Gerüst die Adresse aktualisiert hatte. Die Reihenfolge dieser beiden Vorgänge ist eine Eigenschaft des Gerüsts und nicht des Tag-Managers.
// erst nach der Adressaenderung melden, nicht davor
(function () {
  var alt = document.location.href;
  ["pushState", "replaceState"].forEach(function (name) {
    var original = history[name];
    history[name] = function () {
      var r = original.apply(this, arguments);
      melde();
      return r;
    };
  });
  window.addEventListener("popstate", melde);
  window.addEventListener("hashchange", melde);

  function melde() {
    if (document.location.href === alt) { return; }
    alt = document.location.href;
    window.dataLayer.push({
      event: "seitenwechsel",
      seite_adresse: document.location.href,
      seite_titel: document.title
    });
  }
})();
Zwei Einzelheiten in diesem Stück leisten echte Arbeit. Der Vergleich mit der vorherigen Adresse unterdrückt die Doppelereignisse, die ein Gerüst erzeugt, wenn es den Zustand ersetzt, ohne die Route zu ändern. Und hashchange steht eigens da, denn eine reine Rautenänderung läuft nicht immer über pushState – und das ist genau der Fall bei den Anwendungen, die ihre Routen im Fragment führen.
Der Titel lohnt sich aus demselben Grund mitzugeben wie die Adresse: Er ändert sich nach der Route, und ein Tag, das ihn zu früh liest, meldet den Titel der vorigen Seite zum Pfad der aktuellen. Ein solches Paar fällt in einem Bericht leicht auf und lässt sich ohne dieses Wissen schwer erklären.
Entscheiden, was in den Bericht gehört
Alles Bisherige beschreibt, was möglich ist. Die Entscheidung lautet, was dort stehen soll, und drei Fragen klären das.
Welche Parameter unterscheiden Seiten, und welche kennzeichnen nur, wie jemand angekommen ist. Sortierung und Blätterung unterscheiden; gclid, fbclid und der Kampagnensatz tun es nicht – und sie in der Seitendimension zu lassen zerlegt jede Einstiegsseite in einen langen Schwanz von Zeilen mit je einem Aufruf.
Ob das Fragment eine Angabe trägt oder eine Position. Eine Route gehört in den Bericht; ein Anker auf eine Überschrift ist Rauschen, und beides sieht im Wert gleich aus.
Und ob irgendetwas darin personenbezogen ist. An dieser Stelle kehrt die frühere Frage nach dem Schwärzen mit schärferer Kante zurück: Ein Wert im Fragment lässt sich von keiner Regel auf dem Webserver abfangen, von keinem vorgelagerten Server, und ist, bevor er das Gerät verlässt, allein im Browser entfernbar – womit das Tag die letzte Linie ist statt einer Bequemlichkeit.
Fragen und Antworten
Lässt sich eine rautengeführte Anwendung per Server-Weiterleitung auf echte Pfade umstellen?
Nicht allein auf dem Server. Eine Anfrage an /#/produkt/42 kommt dort als / an, der Server weiß also nicht, welche Route gemeint war, und kann keine passende Weiterleitung wählen. Leitet er / pauschal auf eine neue Adresse um, hängt der Browser das Fragment selbst wieder an: Der HTTP-Standard legt fest, dass ein Weiterleitungsziel ohne eigenes Fragment das Fragment der ursprünglichen Adresse erbt. Aus /#/produkt/42 wird so /app/#/produkt/42, nicht /app/produkt/42.
Die Übersetzung der alten Routen muss deshalb im Browser geschehen: Ein kleines Skript liest location.hash und ersetzt die Adresse per history.replaceState oder location.replace durch den neuen Pfad. Das sollte passieren, bevor das Analyse-Tag den ersten Seitenaufruf meldet, sonst erscheint jede alte Adresse noch einmal als eigener Aufruf.
In den Berichten bricht die Umstellung die Zeitreihe. Vorher standen alle Routen unter einem einzigen Seitenpfad und unterschieden sich nur in der Seitenadresse, danach verteilen sie sich auf eigene Seitenpfade. Ein Vergleich über den Umstellungstag hinweg braucht deshalb eine Zuordnung der alten Fragmente zu den neuen Pfaden.
Meldet das Skript aus dem Artikel auch Sprünge zu Ankern auf derselben Seite?
Ja. Ein Klick auf einen Anker ändert document.location.href und löst hashchange aus, und der Vergleich mit der vorherigen Adresse lässt das Ereignis durch, weil sich die Adresse tatsächlich geändert hat. Auf Seiten mit Inhaltsverzeichnis entsteht so ein Seitenwechsel je Sprung. Abhilfe schafft eine zusätzliche Bedingung, die das Fragment nur zählt, wenn es eine Route trägt, etwa wenn es mit #/ beginnt.
Sieht ein serverseitiger Container das Fragment?
Ja, aber auf anderem Weg als der Webserver. Der Container bekommt nicht die Seitenanfrage, sondern die Messanfrage des Tags, und darin steht page_location als Wert, samt Fragment, so wie das Tag es aus document.location.href gelesen hat. Dort lässt sich der Wert umschreiben oder kürzen, bevor er an die Analyse-Property weitergeht.
Für personenbezogene Angaben im Fragment ändert das wenig: Wenn der Container sie entfernt, haben sie den Browser bereits verlassen und liegen auf dem eigenen Server, wo sie je nach Einstellung auch in Protokollen landen können. Soll ein Wert das Gerät gar nicht erst verlassen, muss er weiterhin im Browser entfernt werden, bevor das Tag liest.
Quellen
Passend dazu