English
 Deutsch
 Polski
Meridian in Analytics 360 und GeoX: Mix-Modelling mit Intervallen und Geo-Experimente

Inhalt
Am 20. Mai 2026 hat Google auf der Marketing Live gleich mehrere Messwerkzeuge angekündigt, und die interessanteste Nachricht darin ist keine neue Funktion, sondern ein Ortswechsel: Meridian, das quelloffene Mischmodell des Hauses, ist in Analytics 360 eingezogen. Zwei Wochen vorher war GeoX vorgestellt worden, ein ebenfalls quelloffenes Werkzeug für Versuche über Regionen.
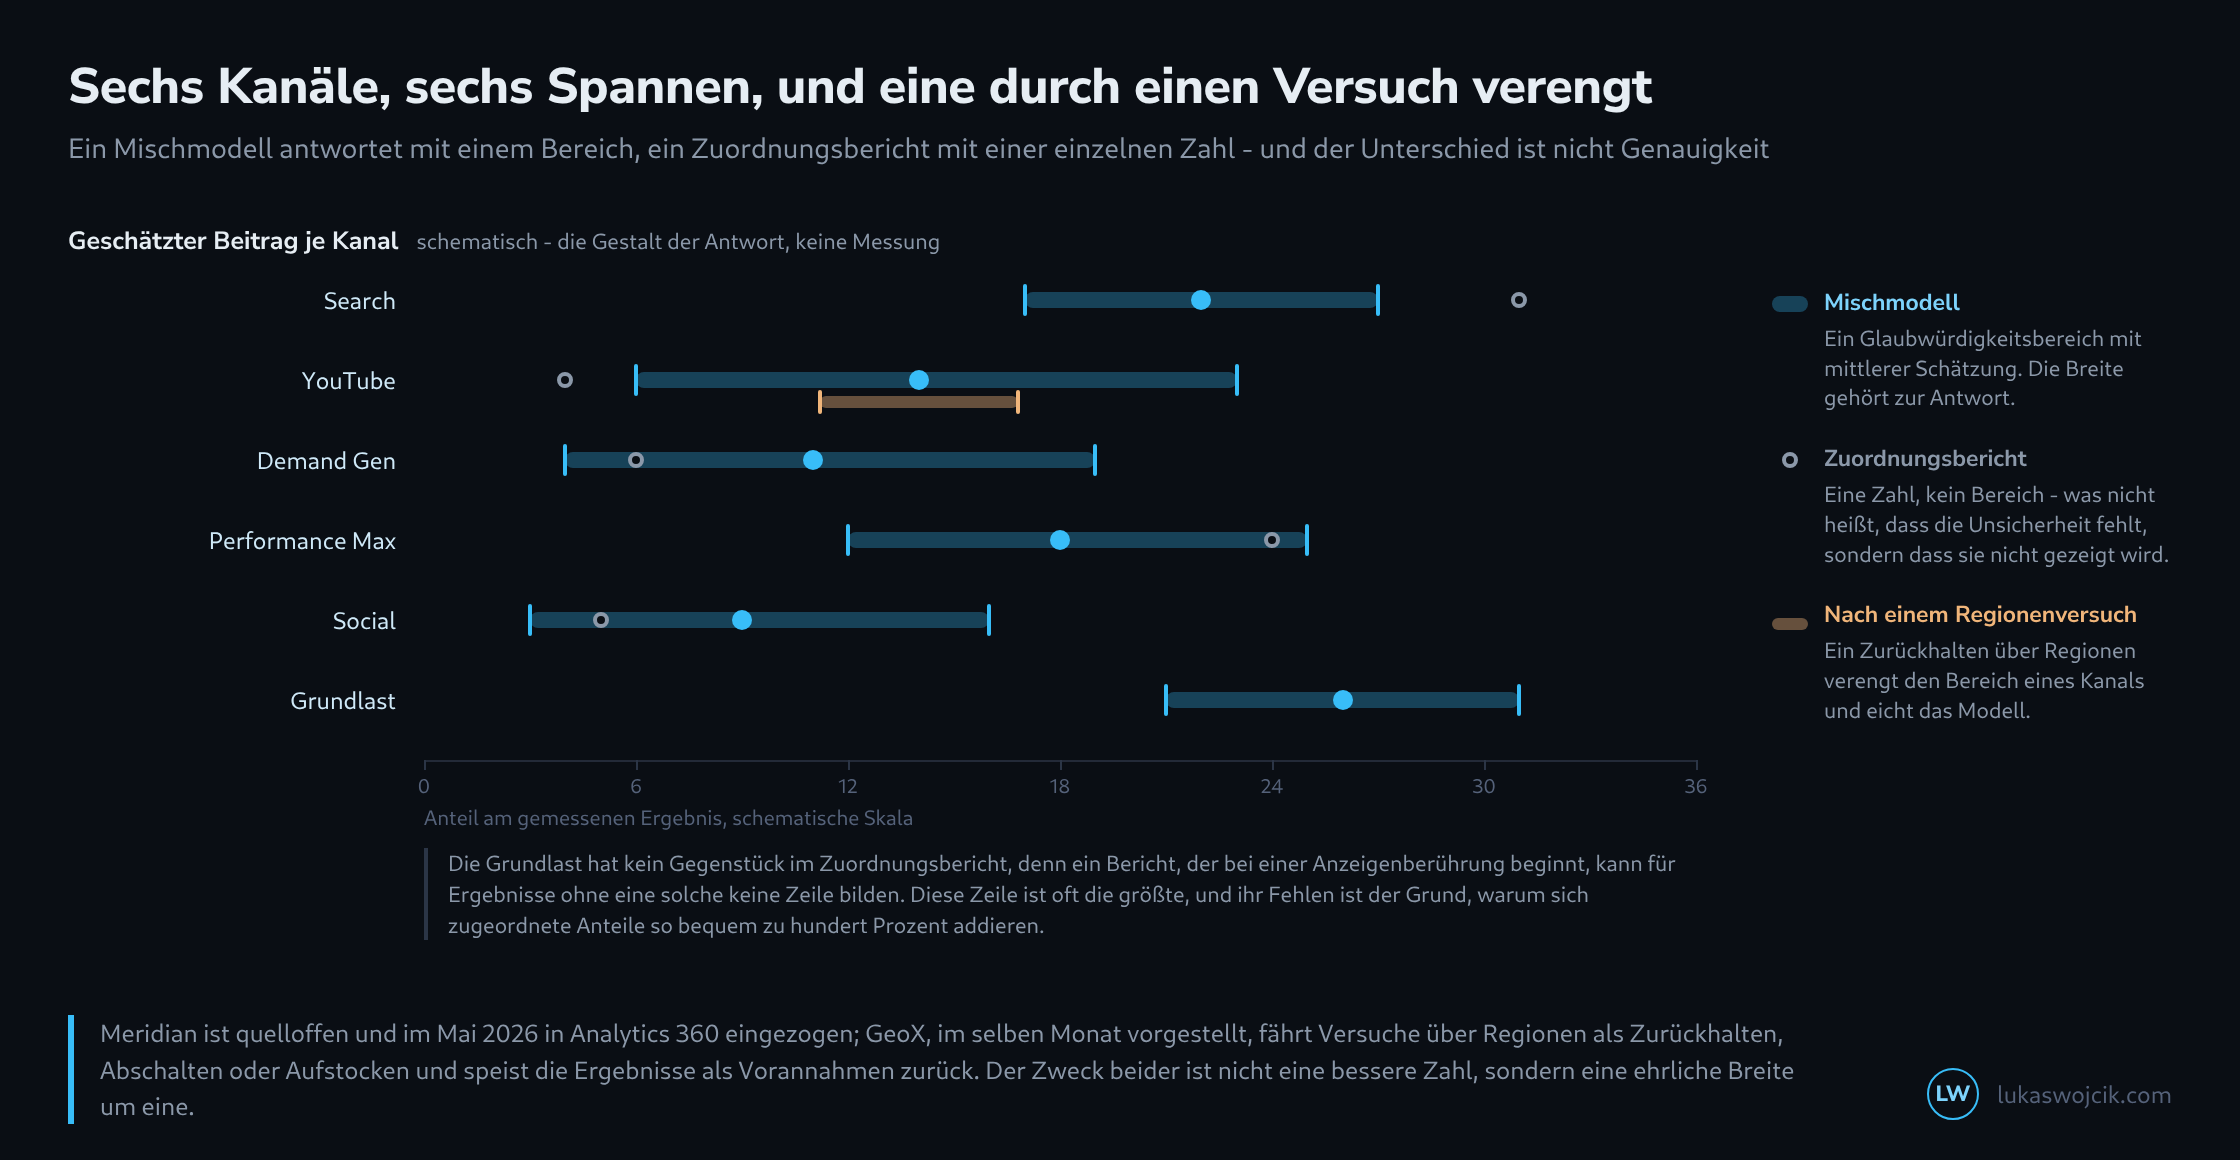
Beide beantworten dieselbe Frage – was hat die Ausgabe bewirkt – und beide antworten anders, als ein Zuordnungsbericht es tut. Sie liefern einen Bereich statt einer Zahl, und das ist kein Mangel an Genauigkeit, sondern die Auskunft selbst.
Was in Analytics 360 eingezogen ist
Meridian führt die eigenen Daten aus GA4 mit den Ausgaben und Einblendungen fremder Kanäle zusammen, genannt werden unter anderem TikTok, Pinterest und Snap. Dazu kommt eine Bedienung in natürlicher Sprache für Planungsfragen der Form, was mit dem Ergebnis geschieht, wenn ein Teil des Budgets von einem Kanal auf einen anderen wandert.
Die Einschränkung steht gleich daneben: Die Einbindung gibt es in der kostenpflichtigen Stufe, nicht in der freien. Meridian selbst bleibt quelloffen und lässt sich unabhängig davon betreiben – was in Analytics 360 einzieht, ist die Bequemlichkeit, nicht das Modell.
Warum ein Bereich mehr sagt als eine Zahl
Ein Mischmodell schätzt aus Zeitreihen, wie viel jeder Kanal zum Ergebnis beigetragen hat, und gibt dazu einen Bereich an, in dem der wahre Wert mit hoher Wahrscheinlichkeit liegt. Diese Breite entsteht aus der Datenlage: Wer über zwei Jahre stets gleich viel in einen Kanal gesteckt hat, liefert dem Modell keine Schwankung, aus der sich eine Wirkung ablesen ließe – der Bereich bleibt breit, und das ist die richtige Auskunft.
Ein Zuordnungsbericht gibt dagegen eine einzelne Zahl aus. Sie wirkt genauer, ist es aber nicht; sie zeigt nur ihre Unsicherheit nicht. Dazu kommt ein Unterschied, der leicht übersehen wird: Ein Bericht, der bei einer Anzeigenberührung beginnt, kann für Abschlüsse ohne eine solche Berührung überhaupt keine Zeile bilden. Genau diese Zeile – die Grundlast – ist in vielen Häusern die größte, und ihr Fehlen ist der Grund, warum sich zugeordnete Anteile so bequem zu hundert Prozent addieren.
Was GeoX dazu beiträgt
Ein Modell schätzt, ein Versuch belegt. GeoX macht Regionen zur Vergleichsgruppe: In einem Teil des Landes läuft die Werbung weiter, in einem anderen wird sie zurückgehalten, abgeschaltet oder aufgestockt, und der Unterschied im Ergebnis ist die Wirkung. Das ist eine Ursachenaussage und keine Modellannahme.
Drei Versuchsanlagen, dieselbe Logik

  Zurückhalten   Kanal läuft überall, nur in Testregionen nicht
  Abschalten     Kanal wird in Testregionen ganz beendet
  Aufstocken     Kanal bekommt in Testregionen mehr Budget

  Gemessen wird immer die Differenz zwischen Testregionen und
  Kontrollregionen, nicht der Verlauf in den Testregionen allein.
  Mehrere Zellen in einem Versuch teilen sich eine Kontrollgruppe,
  was Laufzeit und Kosten gegenüber Einzelversuchen senkt.

  Das Ergebnis geht als Vorannahme in das Mischmodell zurück und
  verengt dort den Bereich des untersuchten Kanals.
Der Rückweg ist der eigentliche Gewinn. Ein Versuch allein misst einen Kanal in einem Zeitraum; ein Modell allein schätzt alle Kanäle mit breiten Bereichen. Wer den Versuch als Vorannahme einspeist, bekommt ein Modell, dessen Bereiche dort schmal sind, wo tatsächlich gemessen wurde.
Was noch angekündigt wurde
Drei weitere Neuerungen gehören zur selben Ankündigung. Qualified Future Conversions schätzt mit Gemini Abschlüsse, die innerhalb von 180 Tagen nach einer Anzeigenberührung noch eintreten – begründet damit, dass bei Demand Gen nur ein Teil der Abschlüsse in den ersten dreißig Tagen fällt. Sie erscheint in drei eigenen Spalten und läuft derzeit als eingeschränkter Test.
Campaign Type Attribution trennt den Beitrag von Demand Gen von dem der übrigen Kampagnenarten, was vorher an Googles eigener Entdopplung scheiterte. Attributed Brand Searches zählt Markensuchen, die auf YouTube-Werbung zurückgehen, dauerhaft statt in einzelnen Studien.
Die ersten beiden sind Schätzungen, die als Spalten daherkommen. Eine geschätzte Zahl in einer Spalte neben gezählten Zahlen ist eine Einladung zum Verwechseln, und die Spaltenüberschrift ist der einzige Hinweis darauf, dass hier zwei verschiedene Dinge nebeneinanderstehen.
Was sich daraus praktisch ergibt
Ein Mischmodell lohnt sich nicht für jeden. Es braucht mehrere Jahre Daten, Schwankung in den Ausgaben und jemanden, der die Bereiche liest, statt nur die mittlere Schätzung abzuschreiben. Wer die mittlere Schätzung nimmt und den Bereich weglässt, hat sich einen teuren Weg zu derselben Scheingenauigkeit gebaut, die er verlassen wollte.
Der Regionenversuch dagegen ist auch im Kleinen möglich, und er beantwortet die Frage, die keine Zuordnung beantwortet: ob dieselben Abschlüsse ohne die Ausgabe auch gekommen wären. Diese Frage ist unbequem, weil die ehrliche Antwort für manche Kanäle lautet, dass ein erheblicher Teil ohnehin gekommen wäre – und genau deshalb lohnt sie sich.
Fragen und Antworten
Warum hilft ein Versuch dem Mischmodell mehr als weitere Monate mit gleichbleibenden Ausgaben?
Weil das Modell Schwankung braucht und gleichbleibende Ausgaben keine liefern. Ein Versuch erzeugt eine Schwankung mit bekannter Ursache: Die Ausgaben ändern sich in den Testregionen, weil sie planmäßig geändert wurden, und nicht, weil gerade Saison ist oder die Nachfrage steigt. Genau diese Trennung kann das Modell aus seinen eigenen Zeitreihen nicht herstellen.
Was begrenzt einen Regionenversuch in kleinem Maßstab?
Vor allem vier Dinge, die entweder die Grenze zwischen Test- und Kontrollregionen verwischen oder den Bereich des Ergebnisses verbreitern:
- Übersprechen zwischen Regionen. Menschen pendeln, reisen und sehen Werbung, die für eine andere Region bestimmt war, und die regionale Aussteuerung von Anzeigen beruht oft auf ungefähren Standortdaten. Jeder solche Fall lässt Test- und Kontrollgruppe einander ähnlicher werden, und die gemessene Wirkung fällt zu klein aus.
- Die Zuordnung der Abschlüsse. Ein Onlineabschluss braucht eine Region, etwa über die Lieferadresse. Wo das nicht gelingt, fehlt er in beiden Gruppen oder landet in der falschen.
- Die Zahl der Regionen. Wenige große Regionen bedeuten wenige Vergleichspunkte, und die eigene Schwankung jeder Region, etwa durch Wetter oder Schulferien, geht dann stark in das Ergebnis ein. Der Bereich wird breit, was richtig ist, aber die Entscheidung erschwert.
- Die Laufzeit. Der Versuch muss lang genug laufen, um auch spätere Abschlüsse zu erfassen; der Hinweis aus derselben Ankündigung, dass bei Demand Gen nur ein Teil der Abschlüsse in die ersten dreißig Tage fällt, legt nahe, dass auch ein Versuch diesen Nachlauf abwarten muss, bevor er ausgewertet wird.
Dazu kommt ein Preis: Ein Zurückhalten oder Abschalten kostet in den Testregionen die Abschlüsse, die der Kanal dort tatsächlich bewirkt hätte. Wie hoch dieser Preis ist, ist genau das, was der Versuch misst.
Quellen
Passend dazu